
Fondamenti di IA
Che cos’è la regressione lineare?

 Aggiungi Unite.AI alle tue fonti preferite su Google
La regressione lineare modella un obiettivo continuo come una combinazione lineare di una o più caratteristiche di input. Viene utilizzata per la previsione, la stima e come baseline trasparente per capire se un modello più complesso aggiunge valore significativo.
Le parole variabile indipendente e variabile dipendente descrivono ruoli nel modello, non una causa ed effetto provati. Una regressione può identificare un’associazione mentre confondimento, bias di selezione, causalità inversa o errore di misurazione spiegano la relazione.
Punti chiave
- L’obiettivo y è modellato dalle caratteristiche di input X; la versione precedente dell’articolo aveva invertito queste etichette in una spiegazione della formula.
- I minimi quadrati ordinari minimizzano la somma dei residui al quadrato.
- Le diagnosi dei residui e le assunzioni sono importanti per l’inferenza e l’incertezza.
- La regolarizzazione ridge e lasso è utile quando i predittori sono numerosi o correlati.
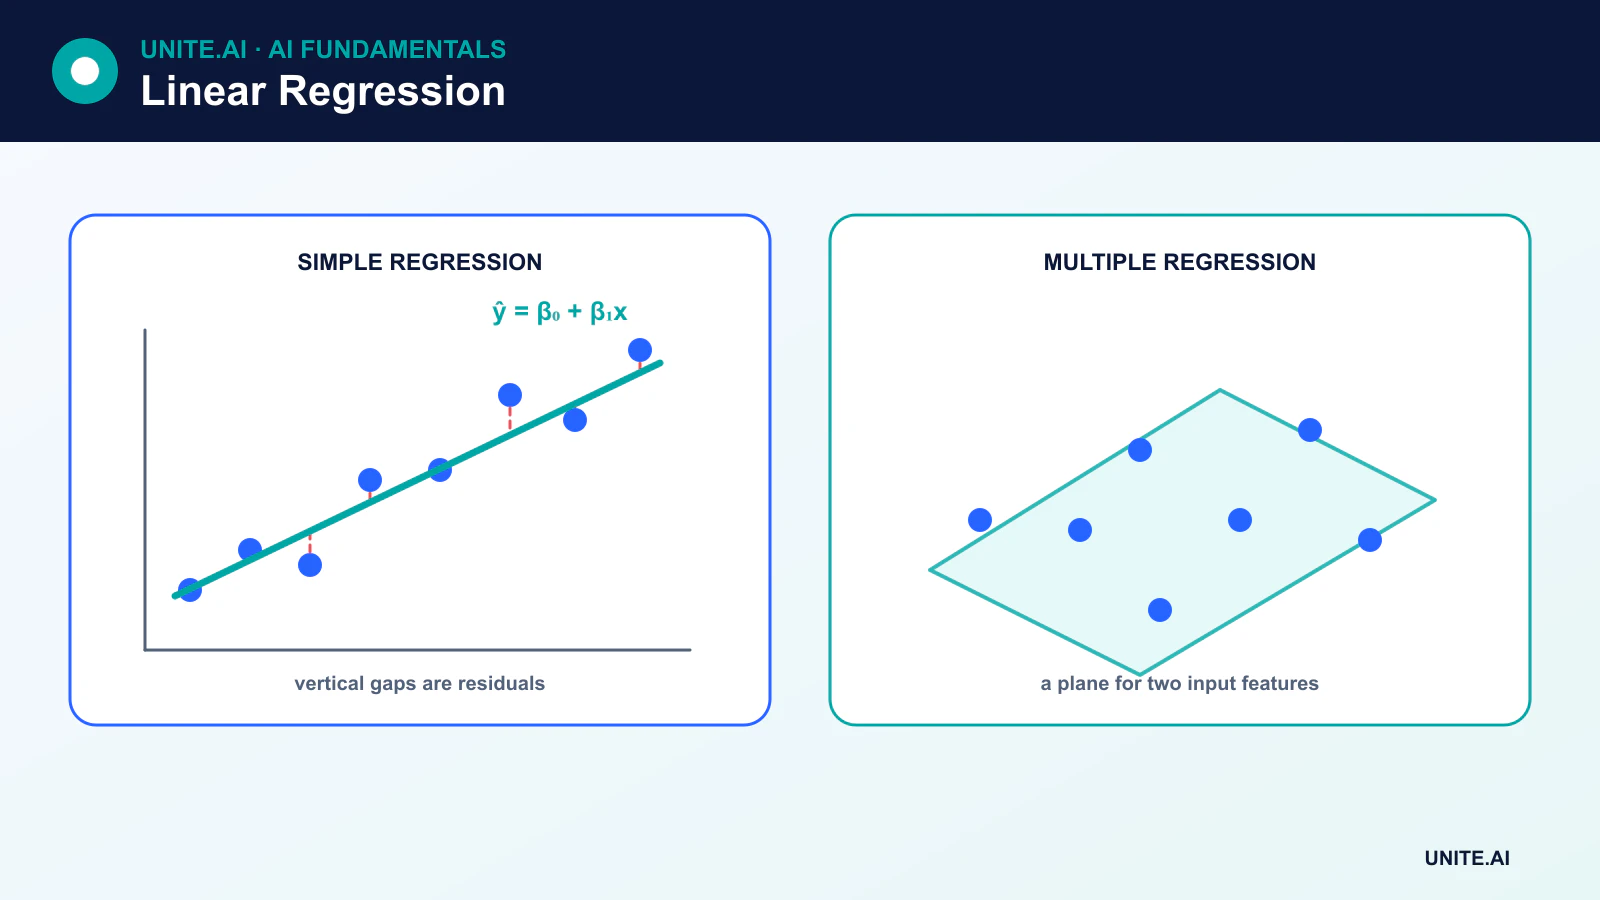
Regressione lineare semplice
Con una sola caratteristica, il modello è:
ŷ = β₀ + β₁x
β₀ è l’intercetta e β₁ è la pendenza. Il residuo per l’osservazione i è yᵢ - ŷᵢ. I minimi quadrati ordinari (OLS) scelgono i coefficienti che minimizzano la somma dei residui al quadrato.
La pendenza stima il cambiamento atteso dell’obiettivo associato a una variazione di un’unità della caratteristica nel modello stimato. Non dovrebbe essere descritta come un effetto causale a meno che il disegno dello studio e le assunzioni supportino l’identificazione causale.
Regressione lineare multipla
Con p caratteristiche:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Ogni coefficiente è interpretato condizionatamente alle altre caratteristiche incluse. La regressione multipla può incorporare variabili categoriche tramite codifica, termini polinomiali e interazioni. Rimane “lineare” perché è lineare nei coefficienti, anche se vengono incluse caratteristiche trasformate come x².
Assunzioni e diagnostica
Per la previsione, la domanda fondamentale è quanto bene il modello generalizzi. Per i test classici dei coefficienti e gli intervalli, assumono aggiuntive diventano importanti:
- Linearità: la media condizionata è rappresentata dalla forma lineare scelta.
- Errori indipendenti o correttamente modellati: osservazioni ripetute, raggruppate, spaziali o di serie temporali possono richiedere una struttura di errore diversa.
- Varianza costante degli errori: l’eteroscedasticità influisce sugli errori standard e sulle stime di incertezza.
- Multicollinearità limitata: predittori fortemente correlati rendono i coefficienti individuali instabili.
- Distribuzione dei residui: la normalità è rilevante per alcune inferenze su piccoli campioni, non è un requisito che ogni caratteristica sia distribuita normalmente.
I grafici dei residui, le misure di leverage e influenza, e la revisione di dominio possono identificare outlier, non linearità, variazione della varianza o osservazioni che dominano l’adattamento.
Valutare le previsioni
- Errore medio assoluto (MAE) media la dimensione assoluta dei residui.
- Errore quadratico medio (MSE) attribuisce più peso agli errori più grandi.
- Radice dell’errore quadratico medio (RMSE) riporta l’errore quadratico alle unità dell’obiettivo.
- R² confronta la variazione residua con una baseline costante sui dati valutati.
R² non è una misura di accuratezza, non stabilisce causalità e può essere negativo su dati di test. La validazione dovrebbe corrispondere al reale contesto di previsione, includendo divisioni temporali o per gruppi quando necessario.
Ridge, lasso e elastic net
La regressione Ridge aggiunge una penalità L2 che riduce i coefficienti e stabilizza i predittori correlati. Lasso aggiunge una penalità L1 e può azzerare i coefficienti. Elastic net combina entrambe. Le caratteristiche solitamente necessitano di una scalatura compatibile prima di confrontare queste penalità.
La regolarizzazione introduce bias in cambio di una varianza più bassa e può ridurre l’overfitting. L’intensità della penalità è selezionata tramite validazione, non con il set di test finale.
Quando la regressione lineare è lo strumento sbagliato
Un modello lineare può fallire quando le relazioni sono fortemente non lineari, gli errori dipendono da valori passati, le distribuzioni dell’obiettivo richiedono modellazioni specializzate, o pochi outlier dominano la perdita quadratica. Gli alberi decisionali, i modelli lineari generalizzati, i modelli di serie temporali, la regressione robusta o i metodi non lineari possono adattarsi meglio.
Anche quando un modello complesso ottiene risultati migliori, la regressione lineare rimane una baseline preziosa. Se un grande sistema non riesce a superarla in modo affidabile, la complessità aggiuntiva potrebbe non essere giustificata.
Assunzioni del modello, stima e diagnostica
I modelli di regressione lineare descrivono la media condizionata di un risultato numerico come un’intercetta più predittori ponderati. I minimi quadrati ordinari scelgono i coefficienti che minimizzano i residui al quadrato. I coefficienti descrivono il cambiamento atteso del risultato per una variazione di un’unità del predittore, mantenendo costanti le altre variabili incluse, secondo il modello specificato. Si tratta di un’associazione a meno che le assunzioni di identificazione causale e il disegno dello studio non giustifichino di più. Unità, codifica, trasformazioni, interazioni e categorie di riferimento determinano l’interpretazione, quindi coefficienti senza un dizionario dei dati sono incompleti.
L’inferenza classica si basa su assunzioni riguardo la forma funzionale, errori indipendenti, varianza costante e distribuzione degli errori per test e intervalli specifici. I grafici residuo‑vs‑valore stimato rivelano non linearità o eteroscedasticità; i grafici Q–Q valutano il comportamento delle code; le diagnosi di leverage e influenza identificano osservazioni che influenzano fortemente le stime. Predittori correlati aumentano l’incertezza e rendono i coefficienti individuali instabili anche quando le previsioni rimangono adeguate. Potrebbero essere necessari errori standard robusti, trasformazioni, spline, strutture gerarchiche o un altro modello, anziché eliminare i dati scomodi.
Regolarizzazione, valutazione e uso responsabile
La regressione Ridge riduce i coefficienti con una penalità L2, mentre il lasso può azzerarne alcuni con una penalità L1; l’elastic net combina entrambe. Standardizzare i predittori quando la scala della penalità deve essere comparabile e selezionare l’intensità usando validazione o cross‑validation. Valutare l’errore medio assoluto, la radice dell’errore quadratico medio, la distribuzione dei residui, la calibrazione su diversi intervalli e l’incertezza, con divisioni temporali o per gruppi che riflettano l’uso. Confrontare con una baseline media e alternative non lineari, ma mantenere i modelli lineari quando trasparenza e stabilità sono importanti.
L’estrapolazione oltre l’intervallo osservato dei predittori segue la linea stimata senza evidenza e può essere pericolosa. Monitorare gli intervalli delle caratteristiche, i valori mancanti, i residui e l’errore nei sottogruppi in produzione. Gli intervalli di previsione descrivono l’incertezza del risultato individuale e sono più ampi degli intervalli di confidenza per la media; entrambi richiedono assunzioni. Evitare di controllare per variabili che introducono bias causale quando l’obiettivo è stimare un effetto. La regressione lineare è uno strumento preciso per una relazione definita, non una garanzia universale che il mondo sia lineare o che un coefficiente rappresenti un intervento.
Esempio pratico: stima del tempo di consegna
Un team logistico modella la durata della consegna in base a distanza, livello di servizio, regione, giorno della settimana e condizioni meteo note. Ispeziona pattern di residui non lineari e aggiunge spline e interazioni giustificate invece di trattare un’equazione lineare come fisica letterale. I gruppi di corrieri e rotte definiscono le suddivisioni di validazione. Vengono riportati l’errore medio assoluto, l’errore di coda, la copertura degli intervalli e il bias sistematico. Le consegne annullate e i dati registrati dopo l’arrivo sono esclusi o modellati esplicitamente.
I coefficienti sono documentati nelle unità e verificati per instabilità in presenza di predittori correlati. Il modello rifiuta l’estrapolazione oltre le distanze e le regioni validate. Gli intervalli di previsione accompagnano le stime, e la programmazione a valle utilizza la loro incertezza. Il monitoraggio traccia gli intervalli delle caratteristiche, i residui, la copertura degli intervalli e il bias dopo cambiamenti della rete. Non viene avanzata alcuna affermazione causale su corriere o meteo basata sui coefficienti predittivi; sarebbero necessari esperimenti operativi o un’identificazione più solida per supportare un intervento.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti destinati, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Utilizzare un rollout a tappe, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allerta e un responsabile di risposta, quindi rivedere le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di documentare il recupero, l’apprendimento dagli incidenti, le procedure di cancellazione e conservazione, e un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
La regressione lineare richiede solo una variabile di input?
No. La regressione semplice ha un predittore, mentre la regressione lineare multipla può utilizzare molte caratteristiche numeriche, categoriche codificate, trasformate e di interazione.
La regressione lineare può dimostrare causalità?
No. Un’interpretazione causale richiede un disegno di ricerca difendibile e assunzioni su confondimento, selezione, misurazione e intervento. Un coefficiente predittivo da solo descrive un’associazione nel modello stimato.
Riferimenti principali












