Fondamenti di IA
Cosa sono le macchine a vettori di supporto?

 Aggiungi Unite.AI alle tue fonti preferite su Google
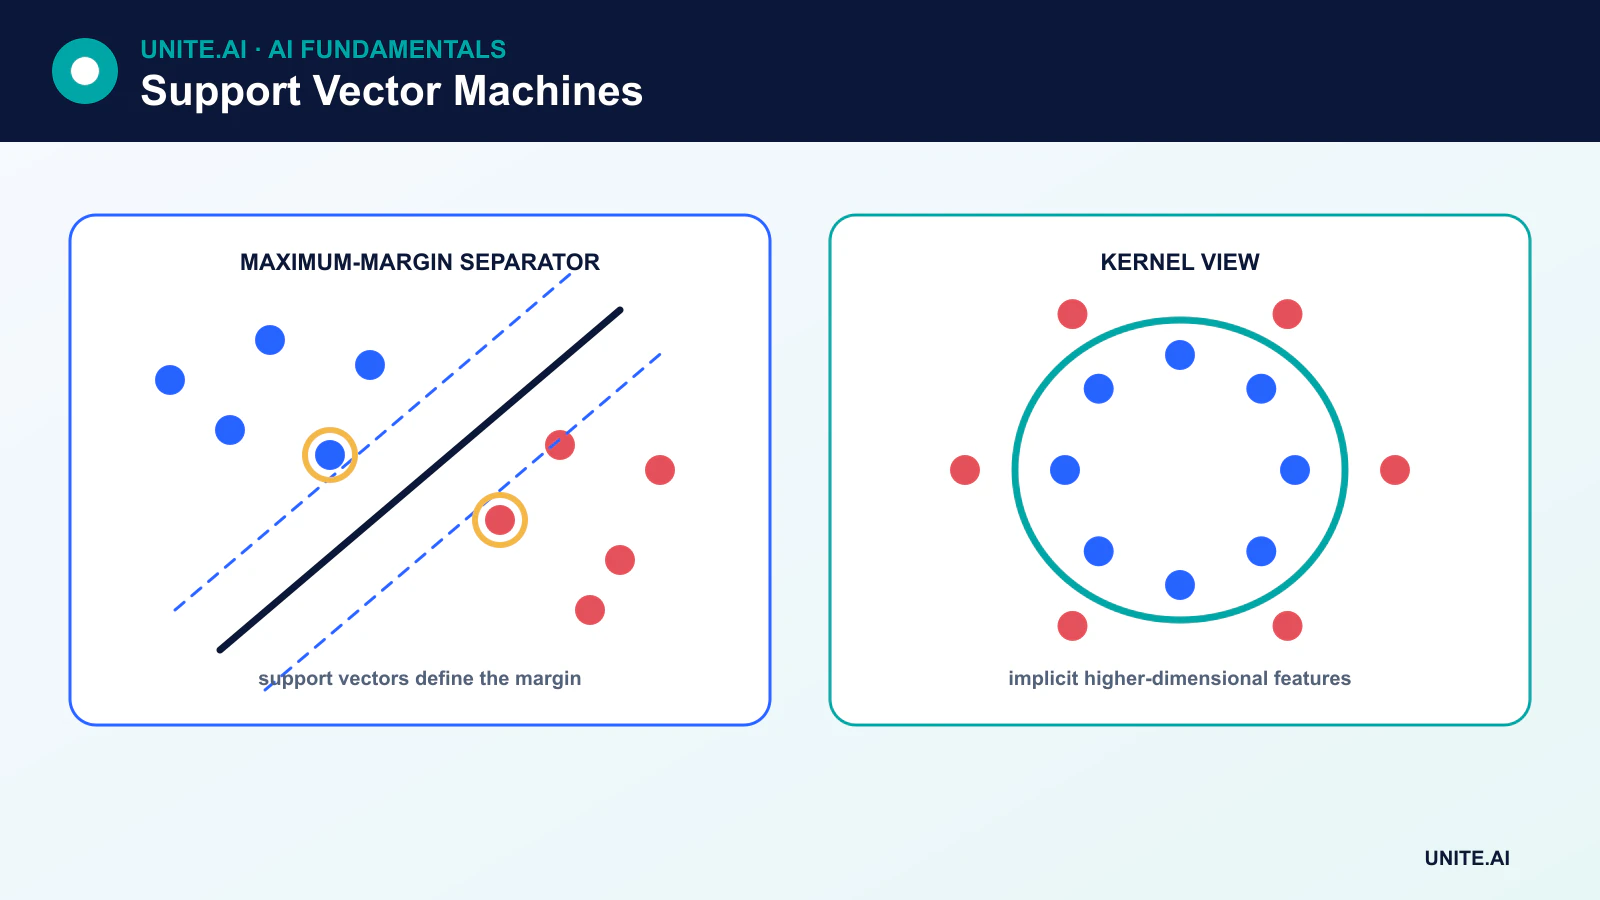
Una macchina a vettori di supporto (SVM) è un metodo di apprendimento supervisionato che individua una frontiera decisionale con il margine più ampio possibile tra le classi. Gli esempi di addestramento che determinano tale frontiera sono i vettori di supporto.
Le SVM possono eseguire classificazione lineare o non lineare, regressione e rilevamento di novità. Sono particolarmente utili per set di dati di piccole o medie dimensioni con caratteristiche informative, inclusi dati sparsi ad alta dimensionalità, ma il loro costo di addestramento può diventare impraticabile su set di dati molto grandi.
Punti chiave
- Una SVM massimizza il margine minimo tra la frontiera e i punti di addestramento più vicini.
- I vettori di supporto sono punti dati, non iperpiani aggiuntivi.
- Il parametro C bilancia la larghezza del margine rispetto alle penalità per le violazioni.
- I kernel calcolano la somiglianza in uno spazio di caratteristiche implicito senza materializzare esplicitamente ogni caratteristica trasformata.
L’idea del margine massimo
Per un classificatore binario lineare, la frontiera decisionale è un iperpiano:
w · x + b = 0
Il vettore w determina l’orientamento e b lo spostamento. Molti iperpiani possono separare le classi di addestramento. La SVM sceglie quello che massimizza la distanza dagli esempi più vicini su entrambi i lati. Quegli esempi più vicini sono i vettori di supporto e hanno la maggiore influenza sulla frontiera adattata.
L’obiettivo non è massimizzare la distanza dalla frontiera a ogni punto in modo indipendente. Massimizza il margine minimo rispettando o penalizzando i vincoli di classe.
Margini rigidi e morbidi
Una SVM a margine rigido richiede una separazione lineare perfetta ed è sensibile ai valori anomali. I dataset reali solitamente necessitano di un margine morbido, che introduce variabili di slack per osservazioni all’interno del margine o sul lato errato della frontiera.
L’iperparametro C controlla la penalità per queste violazioni:
- Un C più grande penalizza le violazioni più severamente e spesso produce un margine più stretto che segue più da vicino gli esempi di addestramento.
- Un C più piccolo consente più violazioni in cambio di un margine più ampio e più regolarizzato.
Il numero di vettori di supporto è il risultato dei dati e della soluzione; aumentare C non garantisce un conteggio specifico di vettori di supporto.
Il trucco del kernel
Alcune classi non possono essere separate con un iperpiano rettilineo nello spazio di caratteristiche originale. Un kernel valuta un prodotto interno corrispondente a un altro spazio di caratteristiche. Questo permette alla SVM di adattare una frontiera non lineare senza calcolare esplicitamente ogni coordinata trasformata.
I kernel più comuni includono:
- Lineare: efficiente per caratteristiche sparse ad alta dimensionalità come il testo.
- Polinomiale: modella interazioni fino a un grado scelto.
- Funzione di base radiale (RBF): crea frontiere locali flessibili basate sulla distanza.
- Sigmoide: assomiglia a un’attivazione neurale ma è meno comunemente la scelta predefinita.
Per una SVM RBF, gamma controlla quanto localmente ogni esempio di addestramento influisce sulla frontiera. Un gamma grande può creare regioni molto dettagliate e overfittare; un gamma piccolo produce un’influenza più liscia.
Classificazione multiclasse
L’obiettivo classico della SVM è binario. Le librerie lo estendono usando strategie come one-vs-rest, che addestra un classificatore per classe, o one-vs-one, che addestra classificatori per coppie di classi e combina le loro decisioni. Le SVM multiclasse non disegnano semplicemente una linea in meno rispetto al numero di classi.
Regressione a vettori di supporto e SVM a classe singola
La regressione a vettori di supporto (SVR) adatta una funzione ignorando gli errori all’interno di un tubo di larghezza epsilon e penalizzando le deviazioni più grandi. Una SVM a classe singola stima una frontiera attorno ai dati tipici e può supportare il rilevamento di novità. Un punto insolito non è automaticamente una frode o un guasto; è insolito rispetto alla rappresentazione adattata.
Requisiti pratici
Le SVM dipendono da distanze e prodotti interni, quindi le caratteristiche numeriche generalmente necessitano di scaling. C, kernel, gamma e pesi di classe dovrebbero essere selezionati tramite validazione. Le stime di probabilità non sono intrinseche al margine e spesso richiedono una calibrazione, che aggiunge costi e dovrebbe essere valutata separatamente.
L’addestramento di una SVM con kernel può scalare tra tempo quadratico e cubico in base al numero di campioni, a seconda dei dati e dell’implementazione. Le varianti lineari di SVM o i modelli lineari stocastici sono più adatti a set di dati molto grandi. Per immagini grezze, audio o linguaggio, le rappresentazioni apprese dal deep learning possono essere più efficaci, mentre una SVM può comunque classificare un embedding fisso.
Punti di forza e limitazioni delle SVM
Le SVM possono funzionare bene con molte caratteristiche, offrono un obiettivo regolarizzato chiaro e dipendono principalmente dai vettori di supporto al momento della predizione. Le limitazioni includono la sensibilità al scaling e agli iperparametri, un addestramento potenzialmente costoso, una ridotta interpretabilità con kernel non lineari e la necessità di calibrazione delle probabilità.
Margini, kernel e l’obiettivo di ottimizzazione
Una macchina a vettori di supporto cerca un iperpiano separatore con un ampio margine tra le classi. Solo i vettori di supporto sulla o all’interno del margine determinano la frontiera. Le SVM a margine morbido introducono slack per sovrapposizioni e punti etichettati in modo errato; il parametro C scambia un margine più ampio contro violazioni durante l’addestramento. Gli input dovrebbero generalmente essere scalati perché distanza e prodotti scalari guidano la soluzione. I pesi di classe o il ri‑campionamento aiutano quando i costi di errore e la prevalenza sono diseguali, ma soglie e probabilità richiedono comunque una validazione indipendente.
Il trucco del kernel valuta la somiglianza come se gli input fossero mappati in uno spazio di caratteristiche di dimensione superiore. I kernel lineari, polinomiali, a base radiale e specializzati codificano diverse ipotesi. Per un kernel RBF, gamma controlla quanto localmente ogni punto influisce sulla frontiera: un gamma alto può creare regioni intricate e overfittare, mentre un gamma basso può underfittare. Le matrici kernel crescono quadraticamente con il numero di campioni, rendendo le SVM non lineari costose su grandi set di dati. I risolutori lineari o le mappe di caratteristiche approssimative sono spesso preferibili su larga scala.
Uso multiclasse, calibrazione e limiti operativi
Le SVM binarie si estendono al multiclasse tramite one-vs-rest, one-vs-one o formulazioni strutturate. Gli iperparametri devono essere ottimizzati all’interno della cross‑validation, con divisioni raggruppate o temporali quando necessario. Valutare precisione e richiamo specifici per classe, distribuzioni dei margini, calibrazione e prestazioni sotto shift. I punteggi decisionali grezzi non sono probabilità; il Platt scaling o la calibrazione isotona utilizza dati separati e può degradarsi se la prevalenza cambia. Confrontare con regressione logistica, alberi e metodi moderni basati su rappresentazioni con pre‑processing e sforzo di tuning equivalenti.
Il servizio richiede lo scaler esatto, l’ordine delle caratteristiche, i parametri del kernel, i vettori di supporto e la mappatura delle classi. Il costo di predizione per una SVM con kernel cresce con il numero di vettori di supporto, quindi misurare latenza e memoria su batch realistici. Input lontani dal supporto di addestramento possono comunque ricevere etichette con fiducia; aggiungere controlli out‑of‑distribution o una politica di astensione dove opportuno. Ispezionare gli errori per proxy sensibili e artefatti del dataset. Le SVM rimangono solide per problemi di dimensioni medie e alta dimensionalità, ma un margine geometrico massimo non è prova di struttura causale o sicurezza.
Esempio pratico: una SVM per l’instradamento di documenti rari
Un team di operazioni legali classifica brevi documenti in categorie di instradamento usando caratteristiche TF–IDF e una SVM lineare. Divide per caso e tempo per evitare perdite di template, scala i pesi di classe in base al costo di errore revisionato e ottimizza C all’interno di una validazione annidata. Il modello lineare è confrontato con regressione logistica e un transformer. Precisione, richiamo, calibrazione per classe e carico di lavoro del revisore contano più dell’accuratezza complessiva.
I punteggi decisionali sono calibrati su dati separati, e i documenti a margine basso o con lingua non supportata vengono indirizzati a una presa manuale. L’artefatto di servizio include tokenizzatore, vocabolario, pesatura, modello, calibrazione e mappa delle etichette. Il monitoraggio traccia nuovi termini, prevalenza delle categorie, margini e percorsi corretti. Documenti e vettori di supporto sono protetti perché le caratteristiche testuali possono rivelare informazioni confidenziali. Un kernel non lineare è respinto quando il suo piccolo guadagno di qualità non può giustificare latenza, memoria e costo di interpretabilità.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti destinatari, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima dell’ottimizzazione. Testare casi ordinari, condizioni limite, input malformati o mancanti, shift di distribuzione, interruzioni di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, preservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile di risposta, quindi esaminare le evidenze del mondo reale dopo il deployment anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di un recupero documentato, apprendimento dagli incidenti, procedure di cancellazione e conservazione, e un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Le SVM eseguono solo la classificazione?
No. La regressione a vettori di supporto predice target continui, mentre una SVM a classe singola può stimare una frontiera di novità. Ogni variante ha un obiettivo diverso e un diverso insieme di iperparametri.
Quando una SVM lineare è una scelta valida?
Le SVM lineari sono spesso efficaci per caratteristiche sparse ad alta dimensionalità, incluse le rappresentazioni testuali tradizionali, dove un kernel flessibile aggiungerebbe costi senza un beneficio chiaro.
Riferimenti principali