Fondamenti di IA
Che cos’è il teorema di Bayes?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Il teorema di Bayes descrive come aggiornare la probabilità di un’ipotesi dopo aver osservato delle evidenze. Collega la probabilità dell’evidenza data un’ipotesi con la probabilità dell’ipotesi data quell’evidenza.
Questa distinzione è fondamentale per il ragionamento statistico e l’apprendimento automatico. Un test può essere altamente accurato quando una condizione è presente, mentre un risultato positivo ha comunque una probabilità modesta di indicare la condizione se la condizione è rara.
Punti chiave
- Il posteriore combina una credenza a priori con la verosimiglianza dell’evidenza osservata.
- Il termine evidenza normalizza le ipotesi possibili.
- I tassi di base possono dominare evidenze apparentemente forti.
- Naive Bayes assume che le caratteristiche siano condizionatamente indipendenti dato la classe, non indipendenti in ogni circostanza.
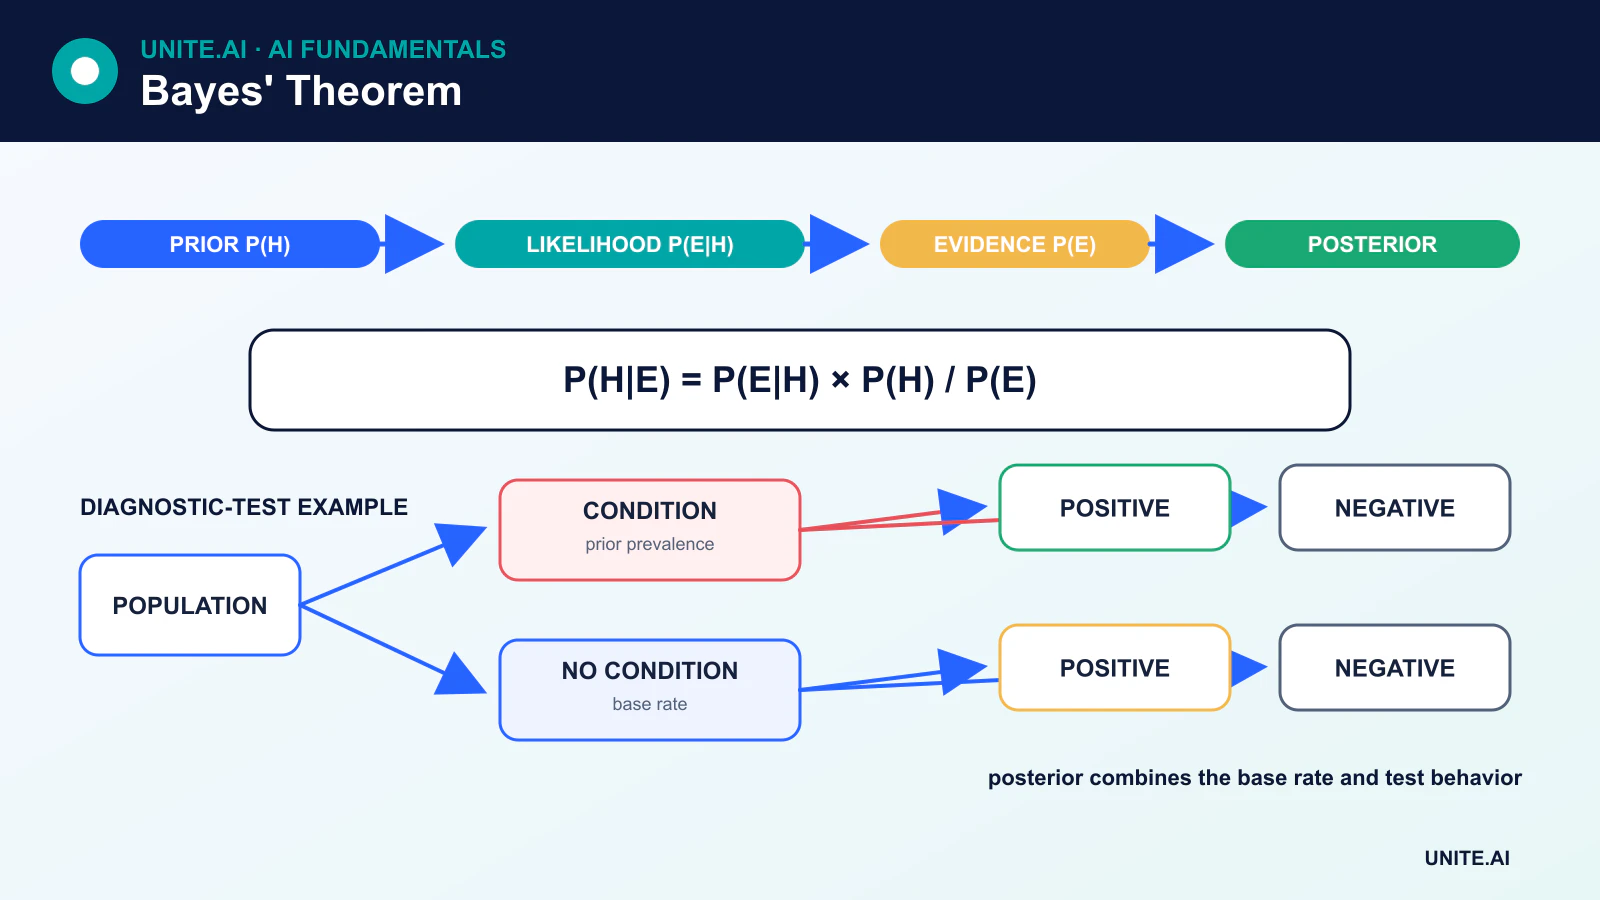
La formula
P(A|B) = P(B|A)P(A) / P(B)
- P(A) è la probabilità a priori dell’ipotesi A.
- P(B|A) è la verosimiglianza di osservare l’evidenza B se A è vera.
- P(B) è la probabilità complessiva dell’evidenza.
- P(A|B) è la probabilità a posteriori di A dopo aver osservato B.
Il teorema deriva da due espressioni equivalenti per la probabilità congiunta: P(A ∩ B) = P(B|A)P(A) e P(A ∩ B) = P(A|B)P(B).
Un esempio numerico di tasso di base
Supponiamo che una condizione colpisca l’1% di una popolazione. Un test ha una sensibilità del 90% e un tasso di falsi positivi del 5%. Consideriamo 1.000 persone:
- Circa 10 hanno la condizione; il test segnala correttamente 9.
- Circa 990 non ce l’hanno; un tasso di falsi positivi del 5% segnala circa 50.
- Ci sono quindi circa 59 risultati positivi, dei quali 9 sono veri positivi.
La probabilità della condizione dopo un risultato positivo è circa 9 / 59 ≈ 15%, non 90%. La sensibilità del test risponde a P(positivo | condizione); l’utente solitamente vuole P(condizione | positivo). Il teorema di Bayes le collega usando il tasso di base.
Aggiornamento bayesiano
Man mano che arrivano nuove evidenze, una distribuzione a posteriori può diventare la a priori per l’aggiornamento successivo. Un modello bayesiano completo specifica le ipotesi possibili, le distribuzioni a priori, una verosimiglianza e la quantità da inferire. L’incertezza è rappresentata con una distribuzione a posteriori anziché solo con una stima puntuale.
Il prior dovrebbe essere documentato e testato per sensibilità. Un prior debolmente informativo può regolarizzare valori implausibili, mentre un prior forte scelto male può dominare dati limitati.
Classificatori Naive Bayes
Naive Bayes predice una classe y a partire dalle caratteristiche x₁ … xₙ usando il teorema di Bayes e l’assunzione:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Si assume che le caratteristiche siano condizionatamente indipendenti una volta nota la classe. Questo è spesso irrealistico, tuttavia il classificatore può funzionare bene quando i punteggi di classe risultanti sono comunque utili.
Varianti comuni
- Multinomial Naive Bayes modella caratteristiche di tipo conteggio ed è comune nella classificazione di documenti.
- Bernoulli Naive Bayes modella la presenza binaria di caratteristiche.
- Gaussian Naive Bayes modella ogni caratteristica continua con una distribuzione gaussiana condizionata alla classe.
- Categorical Naive Bayes modella categorie discrete.
Smussamento e stabilità numerica
Se un valore di caratteristica non compare mai con una classe durante l’addestramento, una stima di probabilità non smussata può diventare zero ed eliminare l’intero prodotto. Lo smussamento additivo o in stile Laplace previene ciò. Le implementazioni calcolano probabilità logaritmiche così che moltiplicare molti valori piccoli diventa sommare valori log stabili.
Probabilità, punteggi e calibrazione
Le uscite di probabilità di Naive Bayes possono essere scarsamente calibrate perché le caratteristiche correlate vengono contate più volte. Un classificatore può ordinare bene le classi sovrastimando la fiducia. La calibrazione dovrebbe essere valutata su dati di test quando le probabilità guidano decisioni.
Bayes oltre Naive Bayes
L’inferenza bayesiana supporta modelli gerarchici, test A/B, stime parametriche scientifiche, previsioni, decisioni consapevoli dell’incertezza e modelli grafici probabilistici. Metodi approssimativi come Markov chain Monte Carlo e inferenza variazionale sono usati quando una distribuzione a posteriori non può essere calcolata in forma chiusa.
Errori comuni di ragionamento
- Confondere
P(A|B)conP(B|A). - Ignorare un tasso di base raro o comune.
- Trattare un prior come oggettivo o lasciarlo non documentato.
- Assumere che una alta verosimiglianza implichi automaticamente un alto posteriore.
- Interpretare un’associazione predittiva come causalità.
Probabilità condizionale, odds e evidenza
Il teorema di Bayes collega la probabilità di un’ipotesi dopo l’evidenza alla sua probabilità a priori, alla verosimiglianza di osservare quell’evidenza sotto l’ipotesi e alla probabilità totale dell’evidenza. In forma odds, le odds a posteriori sono uguali alle odds a priori moltiplicate per un rapporto di verosimiglianza. Questo separa ciò che si credeva prima di un test da quanto il test distingua fortemente le ipotesi. Un test apparentemente molto accurato può comunque produrre molti falsi positivi quando la condizione è rara perché il tasso di base entra nel posteriore.
La verosimiglianza è una funzione dell’ipotesi per dati osservati fissati e non deve essere confusa con la probabilità dell’ipotesi. La normalizzazione dell’evidenza somma o integra tra le ipotesi concorrenti. Le assunzioni di indipendenza condizionale possono semplificare il calcolo, come in Naive Bayes, ma devono essere verificate rispetto alle conseguenze. Più pezzi di evidenza non possono essere moltiplicati come indipendenti quando condividono cause o duplicano informazioni. Anche la direzione causale è importante: P(evidenza|ipotesi) non è generalmente P(ipotesi|evidenza), l’errore classico di probabilità inversa.
Scelte di modellazione, calcolo e utilizzo decisionale
L’analisi bayesiana specifica un prior, una verosimiglianza e una distribuzione predittiva a posteriori. I prior possono codificare conoscenze consolidate, regolarizzare campioni piccoli o essere debolmente informativi; dovrebbero essere giustificati e testati tramite analisi di sensibilità. I modelli coniugati forniscono aggiornamenti analitici, mentre Markov chain Monte Carlo, inferenza variazionale e metodi sequenziali approssimano posteriori complessi. Si devono diagnosticare convergenza, dimensione efficace del campione, errore di approssimazione e plausibilità predittiva a priori anziché riportare un valore a posteriori senza controlli computazionali.
Una probabilità a posteriori informa ma non sceglie da sola un’azione. Le decisioni richiedono perdite, benefici, vincoli e alternative disponibili. Valuta i modelli probabilistici con calibrazione, regole di punteggio corrette e controlli predittivi a posteriori su nuovi dati. Aggiorna solo con evidenze raccolte sotto un processo modellato; bias di selezione e spostamento del dataset possono invalidare la verosimiglianza. Comunica intervalli credibili e assunzioni senza trattarli come intervalli di frequenza garantiti. Il teorema di Bayes è algebra di probabilità esatta, mentre la qualità di una conclusione bayesiana dipende dal modello e dalle evidenze fornite.
Esempio pratico: interpretare un test diagnostico
Un test ha una sensibilità del 95% e una specificità del 90%, ma la condizione colpisce solo l’1% della popolazione sottoposta a screening. Per 10.000 persone, ci si attendono circa 95 veri positivi e 990 falsi positivi, con un valore predittivo positivo inferiore al 9%. Il teorema di Bayes rende esplicito l’effetto del tasso di base. Il calcolo indica la popolazione, la soglia del test e l’incertezza invece di pubblicizzare la sensibilità come la probabilità che un risultato positivo sia corretto. Questa distinzione è anche fondamentale per una scienza dei dati accurata.
I clinici aggiornano la probabilità con evidenze aggiuntive solo quando la dipendenza tra i test è modellata. Una soglia decisionale incorpora il danno di una malattia non rilevata, il rischio del test di conferma, i costi e le preferenze del paziente. La calibrazione è verificata nella popolazione locale, e variazioni di prevalenza innescano una revisione. Il posteriore supporta la discussione e i passi successivi; non sostituisce una diagnosi confermativa. Il reporting utilizza frequenze naturali e analisi di sensibilità così che pazienti e professionisti possano vedere come la conclusione varia sotto ipotesi plausibili.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più probabilmente trascurati. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a tappe, preservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile della risposta, quindi rivedere le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di un recupero documentato, apprendimento dagli incidenti, procedure di cancellazione e conservazione, e un punto chiaro in cui dovrebbe essere disattivato o sostituito.
Domande frequenti
Qual è la differenza tra verosimiglianza e probabilità?
Con i parametri fissati, un modello assegna probabilità ai dati possibili. Con i dati osservati fissati, la stessa espressione può essere vista come una funzione di verosimiglianza sui possibili valori dei parametri. La formula numerica può coincidere mentre l’interpretazione differisce.
Naive Bayes è un’inferenza bayesiana completa?
Utilizza il teorema di Bayes per la classificazione sotto un forte modello di indipendenza condizionale. L’inferenza bayesiana più ampia pone distribuzioni su quantità sconosciute e ragiona con una distribuzione a posteriori.
Riferimenti principali