
Fondamenti di IA
Che cos’è un albero decisionale?

 Aggiungi Unite.AI alle tue fonti preferite su Google
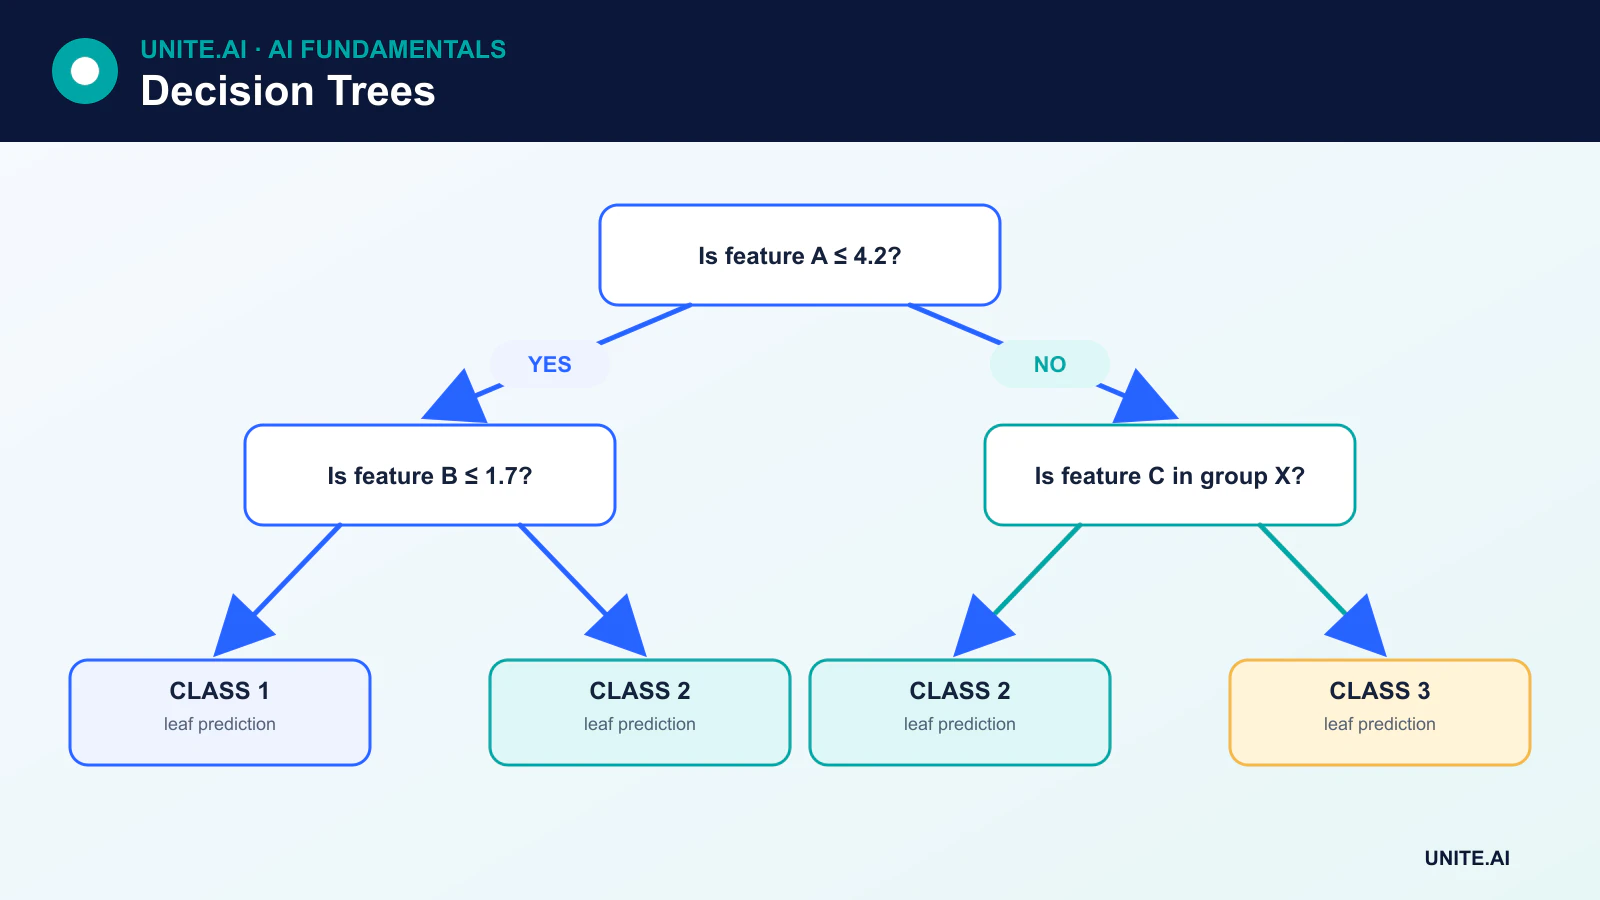
Un albero decisionale è un modello di apprendimento supervisionato che effettua una previsione applicando una sequenza di regole se‑allora. Ogni nodo interno verifica una caratteristica, ogni ramo rappresenta un risultato di tale verifica e ogni foglia produce una previsione di classe, una probabilità o un valore numerico.
Gli alberi decisionali sono usati per classificazione e regressione. Il loro fascino è pratico: possono rappresentare interazioni non lineari, richiedono relativamente poco pre‑processing e producono un percorso che una persona può ispezionare. La loro debolezza è l’instabilità—piccole variazioni nei dati di addestramento possono generare un albero diverso.
Punti chiave
- Un albero partiziona ricorsivamente lo spazio delle caratteristiche; non è necessario isolare ogni osservazione di addestramento.
- Le divisioni per classificazione usano comunemente l’impurità di Gini o l’entropia, mentre le divisioni per regressione riducono l’errore di previsione o la varianza.
- Profondità, dimensione minima della foglia e potatura controllano la complessità e sovradattamento.
- Foreste casuali e alberi gradient‑boosted migliorano la capacità predittiva combinando molti alberi.
Come un albero decisionale effettua una previsione
Supponiamo che un modello preveda se una macchina è probabile che fallisca. Il nodo radice potrebbe chiedere se la vibrazione supera una soglia appresa. Un ramo potrebbe quindi verificare la temperatura operativa. L’osservazione raggiunge una foglia contenente la probabilità di fallimento stimata tra gli esempi di addestramento che hanno seguito lo stesso percorso.
Per la regressione, la foglia può restituire il valore medio del target delle osservazioni in quella regione. Per la classificazione, può restituire la classe di maggioranza o una distribuzione delle frequenze di classe. Una foglia può contenere molte osservazioni; separare completamente i dati di addestramento è solitamente indesiderabile perché può produrre un albero sovradattato.
Come un albero sceglie una divisione
L’addestramento considera le caratteristiche e le soglie candidate, quindi seleziona la divisione che migliora maggiormente un obiettivo definito. Il miglioramento deve essere ponderato in base a quante osservazioni vanno a ciascun nodo figlio.
Impurità di Gini
Per la classificazione, l’impurità di Gini misura quanto le classi siano mescolate in un nodo:
Gini = 1 - Σ p(k)²
Un nodo che contiene una sola classe ha impurità zero. Una divisione candidata è utile quando l’impurità ponderata dei suoi figli è inferiore a quella del nodo genitore.
Entropia e guadagno di informazione
L’entropia è un’altra misura dell’incertezza di classe:
Entropy = -Σ p(k) log₂ p(k)
Il guadagno di informazione è l’entropia del genitore meno l’entropia ponderata dei figli. Gini ed entropia spesso producono alberi simili, sebbene non sempre identici.
Perdita di regressione
Gli alberi di regressione scelgono comunemente divisioni che riducono l’errore quadratico, l’errore assoluto o un altro criterio di regressione. Ogni foglia quindi prevede un valore basato sui target di addestramento all’interno di quella regione.
CART e altri algoritmi ad albero
CART, o Classification and Regression Trees, utilizza divisioni binarie e costituisce la base di implementazioni comuni come gli alberi decisionali di scikit-learn. Altri algoritmi includono ID3, C4.5 e C5.0. Le implementazioni differiscono per i tipi di divisione supportati, la gestione dei valori mancanti, la potatura e gli obiettivi.
Le variabili categoriche possono richiedere codifica, divisioni di sottoinsiemi diretti o gestione specifica dell’implementazione. I valori mancanti possono essere imputati o gestiti tramite direzioni predefinite apprese o divisioni surrogate. È importante comprendere il comportamento della libreria specifica piuttosto che presumere che ogni implementazione di albero funzioni allo stesso modo.
Controllare la complessità dell’albero
Un albero profondo può memorizzare rumore. I controlli comuni includono:
- Profondità massima: limita la lunghezza di un percorso di previsione.
- Numero minimo di campioni per divisione o foglia: previene regioni molto piccole.
- Diminuzione minima dell’impurità: richiede che una divisione fornisca un beneficio sufficiente.
- Numero massimo di foglie: limita la complessità totale.
- Potatura costo‑complessità: rimuove rami il cui miglioramento non giustifica la complessità aggiuntiva.
La potatura è un processo di ottimizzazione strutturata, non una cancellazione casuale. Gli iperparametri dovrebbero essere scelti con dati di validazione o cross‑validation, mentre il set di test finale rimane intatto.
Punti di forza e limitazioni
Gli alberi decisionali possono modellare interazioni ed effetti di soglia senza scalare le caratteristiche. Accettano input numerici e, a seconda dell’implementazione, categorici. La previsione è veloce e un albero piccolo è facile da visualizzare.
Tuttavia, un singolo albero può avere alta varianza, creare cambiamenti bruschi di previsione vicino a una divisione e favorire caratteristiche con molti possibili punti di divisione. Gli alberi inoltre extrapolano poco nella regressione: al di fuori delle regioni osservate, una foglia restituisce comunque un valore appreso dai campioni di addestramento. Un albero grande potrebbe non essere più comprensibile di un altro modello complesso.
Da un albero a insiemi
L’apprendimento ensemble combina più modelli. Una foresta casuale addestra molti alberi su osservazioni ricampionate e sottoinsiemi di caratteristiche, quindi media le loro previsioni. Il gradient boosting costruisce alberi in sequenza così che ogni nuovo albero affronti l’errore residuo. Questi approcci solitamente superano un singolo albero, ma sacrificano un po’ di interpretabilità e aggiungono costi computazionali.
L’importanza delle caratteristiche da un albero o da un ensemble deve essere interpretata con attenzione. L’importanza basata sull’impurità può essere di parte, e l’importanza di una caratteristica non dimostra causalità. L’importanza per permutazione, gli strumenti di dipendenza parziale e la revisione di dominio forniscono contesto aggiuntivo.
Come un albero apprende divisioni e previsioni
Un albero decisionale partiziona ricorsivamente lo spazio delle caratteristiche. In ogni nodo, un algoritmo di addestramento valuta le soglie candidate delle caratteristiche o le partizioni di categoria e seleziona la divisione che riduce maggiormente l’impurità, come l’impurità di Gini o l’entropia per la classificazione e l’errore quadratico per la regressione. Le foglie memorizzano una distribuzione di classi o una previsione numerica basata sulle osservazioni di addestramento che vi arrivano. La divisione greedy è computazionalmente pratica ma non garantisce l’albero globalmente ottimale, e campioni diversi o criteri di spareggio possono produrre strutture differenti.
Caratteristiche continue, ordinali, categoriche e mancanti richiedono una gestione esplicita. La codifica one‑hot può creare molte divisioni candidate; i metodi categorici nativi possono usare statistiche ordinate ma necessitano di implementazioni a prova di leakage. Gli alberi non richiedono scaling, ma possono favorire variabili ad alta cardinalità e isolare piccoli gruppi. Profondità, dimensione minima della foglia, diminuzione minima dell’impurità e potatura costo‑complessità controllano la varianza. Sceglierli con dati di validazione e valutare la calibrazione, poiché una probabilità di foglia basata su pochi casi può essere estrema e instabile.
Interpretazione, modalità di fallimento e utilizzo in produzione
Un percorso dalla radice alla foglia è una regola esatta per una previsione del modello, ma non è automaticamente una spiegazione causale. Variabili correlate possono sostituirsi a vicenda, piccoli cambiamenti nei dati possono alterare le divisioni superiori, e un percorso dall’aspetto semplice può dipendere da etichette di parte. L’importanza globale delle caratteristiche basata sull’impurità può essere fuorviante; l’importanza per permutazione, la dipendenza parziale e i controlli controfattuali aggiungono contesto ma hanno anche assunzioni. Riporta l’incertezza e verifica se una regola presunta è valida su dati indipendenti e sui sottogruppi rilevanti.
Gli alberi singoli sono utili quando trasparenza, bassa latenza e una struttura non lineare moderata sono importanti, ma gli ensemble solitamente offrono prestazioni predittive più forti. Convalida il comportamento ai confini, le categorie rare, i valori mancanti e gli input al di fuori dell’intervallo di addestramento. Le regole esportate devono riprodurre esattamente il preprocessing di addestramento e il confronto numerico. Monitora l’occupazione delle foglie, la distribuzione dell’output, gli errori e le categorie emergenti. Un albero che indirizza molti nuovi casi in una regione piccola o precedentemente vuota dovrebbe attivare una revisione anche se il drift aggregato rimane piccolo. Mantieni un fallback per schemi non validi e documenta ogni decisione di potatura o soglia.
Esempio pratico: un albero di triage dei prestiti interpretabile
Un prestatore utilizza un albero solo per dare priorità alle domande incomplete per la revisione manuale, non per approvare o rifiutare il credito. L’obiettivo è un risultato di completezza documentato, e le caratteristiche disponibili al momento dell’accettazione escludono decisioni successive. La validazione temporale raggruppata confronta un albero potato poco profondo con regole e regressione logistica. La dimensione minima della foglia impedisce regole basate su pochi richiedenti, mentre la calibrazione e gli errori specifici per classe sono riportati su tutti i canali e i gruppi protetti rilevanti.
I revisori vedono il percorso esatto e i valori di origine ma possono correggere dati errati e sovrascrivere l’instradamento. L’organizzazione testa proxy correlati e cambiamenti controfattuali, monitora l’occupazione delle foglie e i valori mancanti, e tratta un improvviso traffico verso una piccola foglia come un incidente di qualità dei dati. Le modifiche di politica creano una nuova versione del modello e una validazione, non una modifica di divisione non documentata. Poiché l’uso influisce su accesso e onere, i richiedenti ricevono un canale umano e l’albero non è mai presentato come una spiegazione causale della solvibilità.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni guasto importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della sintonizzazione. Testa casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione delle dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e il ritiro. Usa un rollout a fasi, conserva un fallback sicuro e verifica il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le sovrascritture umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allarme e un responsabile della risposta, quindi rivedi le evidenze del mondo reale dopo il deployment anziché presumere che le prestazioni offline persistano. Rivaluta ogniqualvolta le fonti dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di un recupero documentato, apprendimento dagli incidenti, procedure di cancellazione e conservazione, e di un chiaro punto in cui dovrebbe essere disattivato o sostituito.
Riferimenti principali












