
Fondamenti di IA
Cos’è una matrice di confusione?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Una matrice di confusione è una tabella che conta quante volte le previsioni di un classificatore coincidono o differiscono dalle etichette note. Rivela quali classi vengono confuse e fornisce i conteggi usati per calcolare metriche come precisione, richiamo, specificità e F1. È uno degli strumenti diagnostici fondamentali per i problemi di classificazione di apprendimento supervisionato.
La matrice stessa non è un unico punteggio di prestazione. È una vista strutturata dei risultati a una determinata soglia decisionale, set di dati e definizione di classe.
Punti chiave
- Per la classificazione binaria, i quattro risultati sono vero positivo, falso positivo, falso negativo e vero negativo.
- Etichettare sempre gli assi: le librerie e le pubblicazioni non sempre posizionano le classi reali e quelle predette nella stessa orientazione.
- L’accuratezza può nascondere errori gravi quando le classi sono sbilanciate.
- Modificare la soglia di classificazione cambia la matrice di confusione e il compromesso tra precisione e richiamo.
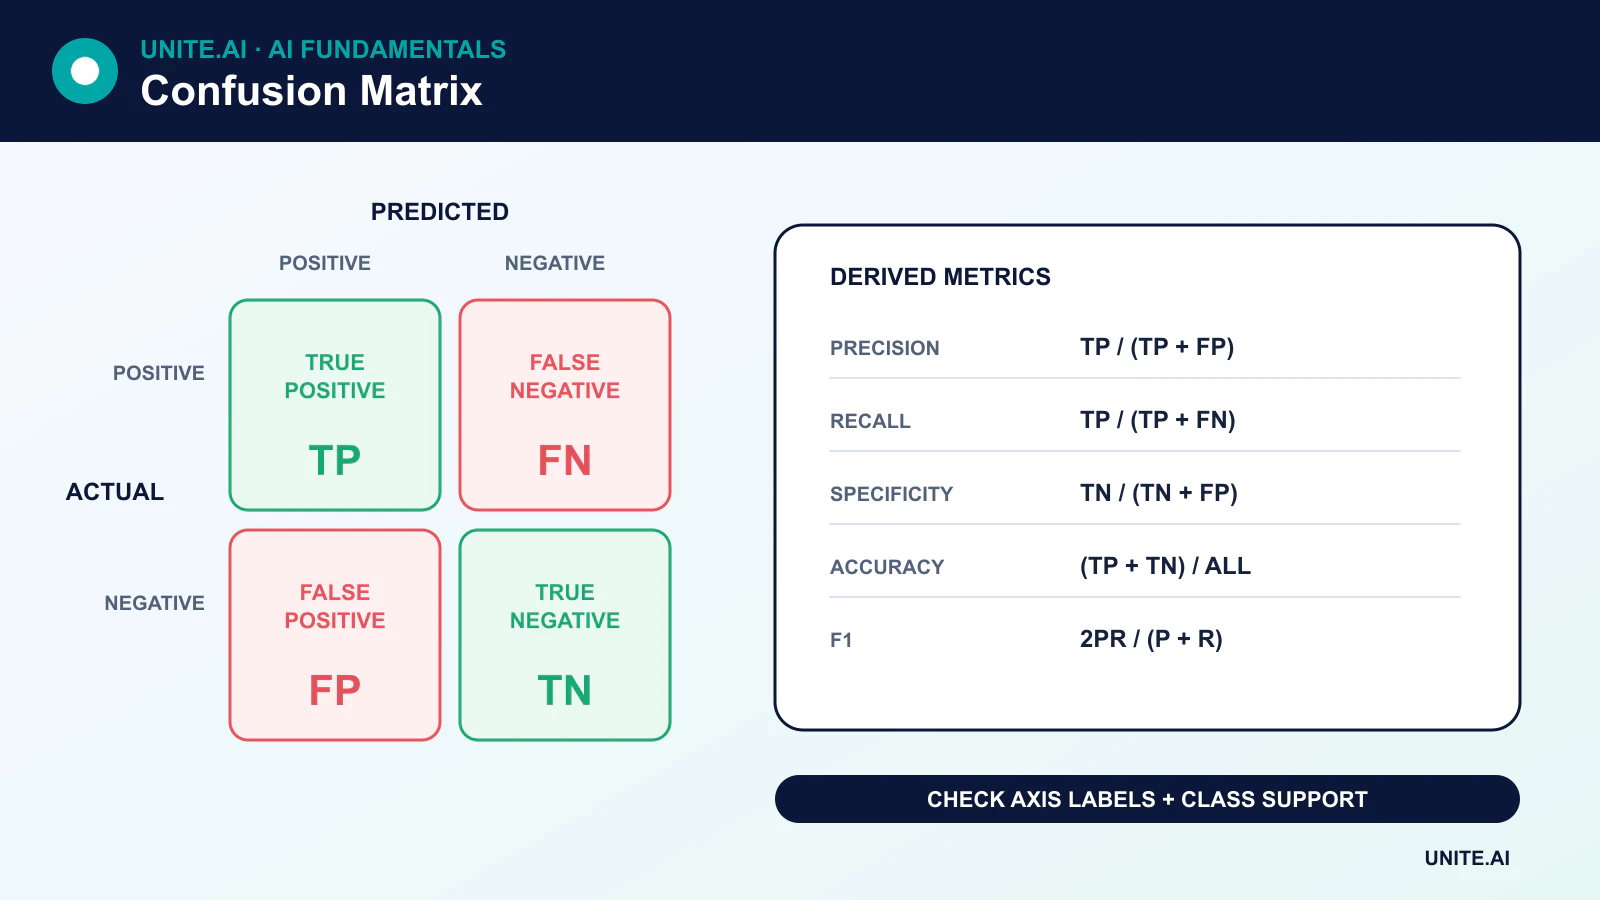
I quattro risultati della classificazione binaria
- Vero positivo (TP): l’esempio è positivo e il modello predice positivo.
- Falso positivo (FP): l’esempio è negativo ma il modello predice positivo.
- Falso negativo (FN): l’esempio è positivo ma il modello predice negativo.
- Vero negativo (TN): l’esempio è negativo e il modello predice negativo.
Nella convenzione di scikit-learn, le righe rappresentano le classi reali e le colonne le classi predette. Altre visualizzazioni possono trasporre questa disposizione, quindi le etichette — non le posizioni degli angoli — dovrebbero guidare l’interpretazione.
Metriche derivate da una matrice di confusione
Precisione
Precision = TP / (TP + FP)
La precisione risponde: tra gli esempi predetti positivi, quale proporzione era effettivamente positiva?
Richiamo o sensibilità
Recall = TP / (TP + FN)
Il richiamo risponde: tra tutti gli esempi realmente positivi, quale proporzione è stata identificata dal modello? Nella classificazione binaria, il richiamo della classe positiva è anche chiamato sensibilità o tasso di veri positivi.
Specificità
Specificity = TN / (TN + FP)
La specificità è il richiamo per la classe negativa: tra i negativi reali, quale proporzione è stata correttamente respinta dal modello?
Accuratezza
Accuracy = (TP + TN) / (TP + TN + FP + FN)
L’accuratezza è utile quando le classi e i costi degli errori sono ragionevolmente bilanciati. Può essere ingannevole quando una classe domina.
Punteggio F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
Il F1 riassume precisione e richiamo con una media armonica. Ignora i veri negativi, quindi non è il riepilogo adeguato per ogni compito.
Un esempio pratico
Supponiamo che un set di test contenga 1.000 transazioni. Cinquanta sono fraudolente. Un modello individua 40 di quelle frodi ma segnala 30 transazioni legittime:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Il modello ha un’accuratezza del 96%, ma la sua precisione è circa il 57% e il richiamo è dell’80%. L’alta accuratezza è dovuta in gran parte al gran numero di transazioni legittime. Se questo modello è accettabile dipende dal costo delle frodi non rilevate, dalla capacità di indagine e da quanto siano calibrati i suoi punteggi di rischio.
Le soglie modificano la matrice
Molti classificatori restituiscono un punteggio anziché una risposta sì/no inevitabile. Abbassare la soglia positiva generalmente aumenta il richiamo e i falsi positivi; alzarla generalmente aumenta la precisione o la specificità, ma perde più positivi. La soglia dovrebbe essere scelta usando dati di validazione e costi reali degli errori, non fissata automaticamente a 0,5.
Le curve precisione‑richiamo e ROC riassumono le prestazioni attraverso le soglie. Le curve precisione‑richiamo sono spesso più informative quando la classe positiva è rara.
Matrici di confusione multiclasse
Per K classi, la matrice è K × K. Le previsioni corrette si trovano sulla diagonale; le celle fuori diagonale mostrano quali coppie di classi sono confuse. Le metriche per classe possono essere mediate in diversi modi:
- Media macro: assegna a ogni classe lo stesso peso.
- Media ponderata: pesa ogni classe in base al numero di esempi.
- Media micro: aggrega i conteggi dei risultati prima di calcolare la metrica.
Riportare solo una media può nascondere scarse prestazioni su classi più piccole. Includere i conteggi di supporto e i risultati per classe dove le differenze sono rilevanti.
Errori comuni
- Leggere una matrice trasposta senza controllare le etichette degli assi.
- Calcolare le metriche dai dati di addestramento invece che da un opportuno set di validazione.
- Ignorare la prevalenza delle classi, la strategia di campionamento o entità duplicate tra le suddivisioni.
- Confrontare matrici prodotte a soglie diverse senza annotare il cambiamento.
- Trattare tutti i falsi positivi e i falsi negativi come ugualmente costosi.
Una matrice di confusione è quindi uno strumento diagnostico, non una valutazione completa. La calibrazione, l’analisi dei sottogruppi, la robustezza e le conseguenze successive devono anch’esse far parte di una revisione della classificazione.
Leggere ogni cella e derivare metriche utili
Per la classificazione binaria, la matrice di confusione conta veri positivi, falsi positivi, falsi negativi e veri negativi per una classe positiva e una soglia scelte. L’accuratezza divide le previsioni corrette per tutti i casi; la precisione chiede quale frazione dei positivi predetti fosse corretta; il richiamo chiede quale frazione dei positivi reali è stata trovata; la specificità misura i negativi reali correttamente respinti. Il F1 è la media armonica di precisione e richiamo. Nessuna è intrinsecamente la migliore: lo screening per frodi, il triage medico e il filtraggio spam assegnano conseguenze diverse alle stesse celle.
Per i problemi multiclasse, le righe rappresentano comunemente le classi reali e le colonne le classi predette, sebbene le convenzioni varino, quindi le etichette devono essere esplicite. I conteggi one‑vs‑rest producono precisione e richiamo per classe. La media macro pesa le classi in modo uguale; la media micro aggrega le decisioni e favorisce le classi più comuni; la media ponderata segue il supporto di classe. I compiti multilabel consentono più etichette per elemento e richiedono definizioni per etichetta o per campione. Normalizzare per riga per ispezionare i pattern di richiamo o per colonna per ispezionare la composizione delle predizioni, ma conservare i conteggi grezzi così i gruppi rari non vengano esagerati visivamente.
Soglie, incertezza e decisioni operative
Una matrice di confusione riassume decisioni rigide a una soglia. Usa curve precisione‑richiamo o ROC per confrontare le soglie, poi seleziona un punto operativo in base a capacità, prevalenza e costo dell’errore. La calibrazione verifica se le probabilità predette corrispondono alla frequenza osservata ed è separata dal ranking. Quando la prevalenza cambia, la precisione può variare anche se sensibilità e specificità rimangono stabili. Riporta intervalli di confidenza o variazioni bootstrap, ed evita di trarre conclusioni da una manciata di errori in un piccolo sottogruppo.
Audita le matrici per tempo, luogo, dispositivo, lingua e gruppi interessati pertinenti per individuare errori concentrati. Confronta il modello con il processo decisionale esistente, inclusa la revisione umana. Per le catene, registra gli errori a ogni fase: recupero, classificazione, sogliatura e azione. Monitora le etichette di risultato in tempo reale con il loro ritardo e il processo di correzione. Un F1 apparentemente migliorato può comunque aumentare falsi negativi dannosi o superare la capacità di revisione. La matrice di confusione è un registro decisionale; collega ogni cella a chi subisce l’errore e a quale risposta segue.
Esempio pratico: selezione di una soglia per lo screening medico
Un modello di apprendimento automatico per lo screening fornisce un punteggio di rischio per una condizione a bassa prevalenza. Il team crea matrici di confusione a diverse soglie e riporta sensibilità, specificità, precisione, falsi riferimenti e casi mancati con intervalli di confidenza. Poiché il valore predittivo positivo dipende dalla prevalenza, modella la popolazione di riferimento invece di citare la precisione di un singolo set di dati. I risultati sono segmentati per dispositivo, sito, età, sesso e altri gruppi clinicamente giustificati.
I clinici scelgono un punto operativo che mantenga la sensibilità richiesta senza sovraccaricare i test di conferma. La matrice è tradotta in conteggi attesi per 10.000 persone scremate così le conseguenze siano comprensibili. Punteggi al di fuori delle condizioni validate non producono conclusioni automatiche. Il monitoraggio confronta le predizioni con diagnosi confermate in ritardo, traccia capacità e calibrazione, e avvia revisioni quando la prevalenza o l’acquisizione cambiano. La matrice di confusione rimane collegata al modello, alla soglia e alla popolazione esatti.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e la conseguenza di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile di risposta, quindi rivedere le evidenze reali dopo il deployment anziché presumere che le prestazioni offline persistano. Rivalutare ogniqualvolta le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
Che cos’è una matrice di confusione normalizzata?
La normalizzazione divide i conteggi per il totale della classe reale, il totale della classe predetta o per tutte le osservazioni. Rende più semplice confrontare le percentuali tra classi, ma il rapporto dovrebbe anche mantenere i conteggi di supporto grezzi così i gruppi piccoli non vengano scambiati per gruppi di pari dimensione.
Una matrice di confusione può valutare la regressione?
Non direttamente. Una matrice di confusione richiede classi discrete. Suddividere un target continuo in intervalli elimina informazioni; la regressione dovrebbe normalmente utilizzare l’analisi dei residui e metriche progettate per valori continui, come MAE o RMSE.
Riferimenti principali












