
Fondamenti di IA
Come funziona la classificazione del testo?

 Aggiungi Unite.AI alle tue fonti preferite su Google
La classificazione del testo assegna una o più etichette a un documento, messaggio o frammento di testo. Esempi includono il rilevamento di spam, l’instradamento dell’intento, l’analisi del sentiment, la categorizzazione degli argomenti, la moderazione e la priorità dei ticket di supporto.
Un classificatore in produzione è più di un semplice modello. Dipende da una tassonomia di etichette precisa, annotazioni rappresentative, divisioni sicure da perdite, una regola decisionale calibrata e un monitoraggio del linguaggio in evoluzione e della prevalenza delle classi.
Punti chiave
- Definire le etichette e i casi ambigui prima di scegliere un’architettura.
- Le baseline semplici bag‑of‑words rimangono utili; gli encoder pre‑addestrati aggiungono contesto e apprendimento per trasferimento.
- L’accuratezza può nascondere scarse prestazioni sulle classi minoritarie, quindi è opportuno utilizzare metriche sensibili alle classi e l’analisi degli errori.
- La calibrazione delle probabilità, l’astensione e la revisione umana trasformano i punteggi in decisioni più sicure.
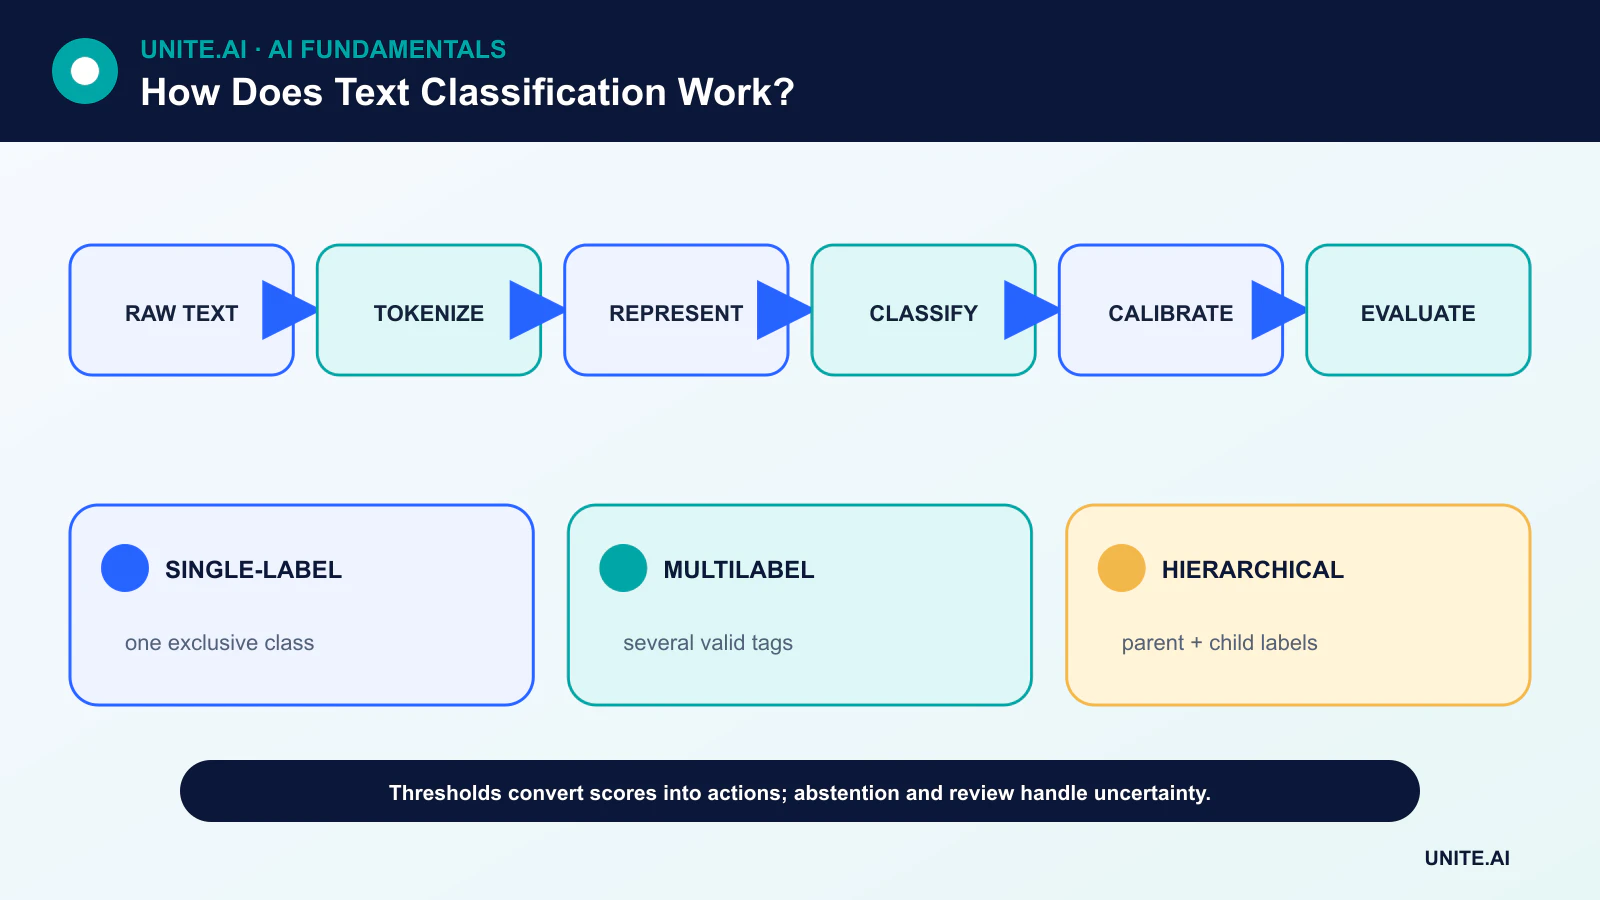
Definire la tassonomia e la politica di annotazione
Un compito a etichetta singola sceglie una classe mutuamente esclusiva. Un compito multilabel può assegnare diverse etichette indipendenti. Le tassonomie gerarchiche contengono etichette padre e figlio. Si tratta di problemi di apprendimento differenti e richiedono output e metriche diversi.
Gli annotatori hanno bisogno di definizioni, esempi positivi e negativi, regole per i contesti mancanti e di un percorso di escalation. Le statistiche di accordo possono rivelare un compito poco chiaro, ma il disaccordo può anche rappresentare una reale ambiguità che il sistema dovrebbe conservare.
Rappresentare il testo
Le pipeline tradizionali usano conteggi di token, n‑grammi e TF‑IDF con classificatori lineari o macchine a vettori di supporto. Si addestrano rapidamente, evidenziano termini influenti e forniscono una solida baseline.
I sistemi neurali mappano i token in embedding. Gli encoder transformer pre‑addestrati usano l’attenzione per produrre rappresentazioni contestuali e possono essere affinati con esempi etichettati. I classificatori guidati da prompt o zero‑shot possono ridurre l’etichettatura iniziale, ma la formulazione delle etichette, la versione del modello e la calibrazione devono essere valutate sul dominio reale.
Addestramento senza perdite
Il dataset è suddiviso in dati di addestramento, validazione e test finale. Documenti quasi‑duplicati, messaggi della stessa conversazione o modelli dalla stessa fonte dovrebbero rimanere nello stesso split. Per usi dipendenti dal tempo, una divisione cronologica rappresenta meglio la distribuzione in produzione.
Lo sbilanciamento delle classi può essere affrontato mediante ponderazione, ricampionamento, selezione della soglia o dati aggiuntivi. Gli esempi sintetici non dovrebbero sostituire la revisione dei fallimenti reali delle classi minoritarie e possono introdurre artefatti che il modello apprende troppo facilmente.
Metriche e decisioni calibrate
Una matrice di confusione mostra quali etichette vengono confuse. La precisione misura quante previsioni positive sono corrette; il richiamo misura quante vere positive sono state trovate. Le medie macro ponderano le classi in modo uguale, mentre le medie micro ponderano gli esempi individuali.
Un punteggio softmax grezzo non è automaticamente una probabilità affidabile. La calibrazione confronta la fiducia con la correttezza osservata. I team possono impostare soglie specifiche per classe, astenersi quando la fiducia è bassa e indirizzare i casi sensibili a un revisore.
Distribuzione, uso multilingue e deriva
Il testo cambia con prodotti, eventi, slang e comportamenti avversari. Il monitoraggio dovrebbe tracciare la lingua di input, la lunghezza, i pattern fuori vocabolario, le frequenze di classe, la fiducia e i risultati ritardati. Il riaddestramento richiede dati versionati e una suite di regressione con esempi importanti.
Le prestazioni multilingue devono essere testate per lingua e dialetto. Tradurre tutto in un’unica lingua può modificare il sentiment o le entità; un encoder multilingue può comunque avere prestazioni disomogenee perché il suo pre‑addestramento e le etichette non sono rappresentativi in modo uniforme.
Rappresentazioni e famiglie di classificatori
La classificazione del testo mappa un documento, una frase o una sequenza di token a una o più etichette. Definire se le etichette sono mutuamente esclusive, multilabel, gerarchiche, ordinate o open‑set. Le pipeline tradizionali tokenizzano il testo, costruiscono caratteristiche bag‑of‑words o TF‑IDF e addestrano regressione logistica, Naive Bayes o un SVM lineare. I sistemi neurali apprendono embedding tramite convoluzione, ricorrenza o transformer. I modelli linguistici guidati da prompt possono classificare senza addestramento specifico al compito, ma i vincoli di output, i costi, la deriva e le evidenze richiedono ancora una valutazione rispetto a baseline più semplici.
Il preprocessing dipende dalla rappresentazione. La conversione in minuscolo o la rimozione della punteggiatura può distruggere segnali per nomi, sentiment, codice o lingua; lo stemming può unire significati distinti. I tokenizzatori transformer operano su sub‑parole e hanno limiti di lunghezza, quindi la strategia di troncamento è importante. Documenti lunghi possono richiedere segmentazione e aggregazione. Conservare il testo grezzo e la versione della trasformazione, e suddividere per autore, conversazione, fonte o tempo per evitare che quasi‑duplicati e modelli ricorrenti attraversino i set di addestramento e test.
Etichette, metriche e analisi degli errori
Una guida all’annotazione dovrebbe definire l’ambito, gli esempi, i casi ambigui e un’opzione sconosciuta o di astensione. Misurare l’accordo e risolvere i disaccordi anziché nasconderli con il voto di maggioranza. Per classi sbilanciate, l’accuratezza è insufficiente; riportare precisione, richiamo, F1, matrice di confusione, calibrazione e carico di lavoro specifico per soglia per classe. I compiti multilabel necessitano di metriche micro, macro e a livello di etichetta. Valutare lingue, dialetti, domini, lunghezza dei messaggi e tempo. Una divisione casuale può sovrastimare la qualità quando il vocabolario o i modelli cambiano.
L’analisi degli errori dovrebbe distinguere fallimenti di rappresentazione, contesto insufficiente, ambiguità delle etichette, vocabolario raro, negazione, sarcasmo e indizi spurii. Utilizzare test controfattuali che modificano nomi, marcatori dialettali o metadati irrilevanti mantenendo il significato. Ispezionare gli errori ad alta fiducia e i casi rifiutati. Un modello può apprendere che un canale cliente o una firma predicono un’etichetta anziché interpretare il contenuto. Rimuovere le perdite e rivedere i dati prima di aumentare semplicemente la capacità del modello.
Progettazione della produzione
Fornire un tokenizzatore e un modello fissi con validazione dello schema, limiti di lunghezza, batching e una soluzione di fallback per lingua non supportata o bassa fiducia. Monitorare la distribuzione degli input, le frequenze delle etichette, la calibrazione, la latenza e i risultati revisionati. Proteggere il testo perché può contenere istruzioni personali, confidenziali o avversarie. Per la moderazione automatica, l’idoneità o l’instradamento, offrire un ricorso e misurare errori disparati. Versionare etichette e soglie secondo la politica aziendale. La classificazione del testo è affidabile solo entro il suo sistema di etichette definito e la distribuzione dei dati; spiegazioni fluide del modello non dimostrano che una classificazione sia corretta.
Esempio pratico: classificare le richieste di supporto in ingresso
Un team di supporto definisce etichette di instradamento mutuamente esclusive più flag urgenti, multilingue e sconosciuti. Gli annotatori etichettano messaggi de‑identificati con linee guida per problemi misti e misurano l’accordo. Una baseline logistica TF‑IDF, un encoder fine‑tuned e un modello guidato da prompt utilizzano lo stesso set di test basato sul tempo. La valutazione riporta precisione e richiamo per classe, falsi negativi urgenti, calibrazione, validità dello schema, latenza e costo, con modelli quasi‑duplicati raggruppati per evitare perdite.
Il classificatore distribuito valida lingua e lunghezza, si astiene su prove deboli e consente agli operatori di correggere gli instradamenti. Prompt e messaggi sono trattati come non attendibili; l’accesso agli strumenti è assente. Il monitoraggio traccia la prevalenza delle etichette, la fiducia, le correzioni, i tempi di risposta e gli argomenti emergenti. Una modifica di politica o prodotto aggiorna la tassonomia e i dati di riaddestramento tramite revisione. Il sistema migliora il posizionamento nella coda, ma non inferisce mai l’emozione o il diritto del cliente oltre le etichette validate.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni limite, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allerta e un responsabile della risposta, quindi rivedere le evidenze dal mondo reale dopo il deployment anziché presumere che le prestazioni offline persistano. Rivalutare ogni volta che cambiano fonti di dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto richiede anche procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e un punto chiaro in cui dovrebbe essere disattivato o sostituito.
Domande frequenti
L’analisi del sentiment è un compito di classificazione del testo?
Di solito sì, ma il sentiment può essere multilabel, basato su aspetti o continuo anziché una singola etichetta positiva/neurale/negativa.
Quando dovrebbe un classificatore di testo astenersi?
Quando la fiducia è bassa, il testo è fuori dal campo, il contesto richiesto è mancante o il costo di un’azione automatica errata supera il costo della revisione.
Riferimenti principali












