
Fondamenti di IA
Cos’è l’analisi del sentiment? Metodi, usi e limitazioni

 Aggiungi Unite.AI alle tue fonti preferite su Google
L’analisi del sentiment stima il linguaggio valutativo in testi, trascrizioni vocali o altri contenuti. Un sistema può classificare la polarità, ad esempio positiva, negativa o neutra; rilevare opinioni a livello di aspetto; stimare l’intensità; o identificare la posizione rispetto a una determinata affermazione.
L’obiettivo deve essere definito con attenzione. Il sentiment non è sinonimo di emozione, intenzione, tossicità, soddisfazione o verità. Una frase positiva può descrivere sarcasticamente un evento dannoso, mentre una recensione di prodotto negativa può comunque raccomandare il prodotto nel complesso.
Punti chiave
- Definire unità, obiettivo, etichette e contesto prima di raccogliere esempi.
- I lessici sono baseline trasparenti; i modelli supervisionati e i transformer possono catturare più contesto ma necessitano di dati rappresentativi.
- Negazione, sarcasmo, vocabolario di dominio, testo multilingue e confini degli aspetti rimangono difficili.
- Valutare per classe, sottogruppo, dominio e periodo temporale; includere la revisione umana per usi con conseguenze.
Livelli e obiettivi
L’analisi a livello di documento produce un’unica etichetta per l’intero elemento. L’analisi a livello di frase separa le affermazioni, mentre l’analisi basata sugli aspetti collega il sentiment a un’entità o a un attributo — ad esempio, positivo sulla qualità dell’immagine ma negativo sulla durata della batteria.
La posizione (stance) chiede se un interlocutore sostiene una proposizione specifica, il che può differire dal tono emotivo. Queste distinzioni dovrebbero essere definite nella guida all’annotazione prima di applicare i metodi di classificazione del testo.
Lessici, modelli classici e transformer
Un lessico assegna punteggi alle parole e li combina con regole per la negazione o l’intensità. È interpretabile ed economico, ma fatica con il contesto. I modelli supervisionati classici utilizzano caratteristiche di parole o n-grammi, mentre i transformer apprendono rappresentazioni contestuali e possono essere affinati.
Il prompting few-shot può essere comodo, ma i risultati dipendono dagli esempi e dalla formulazione. Confronta ogni approccio complesso con una baseline e utilizza il few-shot learning solo con un set di valutazione separato e versionato.
Sfide dei dati e del linguaggio
Le etichette possono riflettere la prospettiva dell’annotatore anziché un fatto oggettivo. Il cambiamento di dominio è marcato: “imprevedibile” può essere un elogio per un film e una critica per un veicolo. Il passaggio tra codici, i dialetti, le emoji, i discorsi citati e l’ironia complicano i segnali a livello di token.
Bilanciare le classi intenzionalmente e impedire che autori, prodotti o conversazioni correlati trapelino tra training e test. Un modello che memorizza un marchio o un interlocutore può apparire accurato senza aver appreso il sentiment.
Valutazione e uso responsabile
Riportare precisione, recall, F1 e una matrice di confusione invece della sola accuratezza. Revisionare gli errori per aspetto, lunghezza, dialetto e periodo, e calibrare le soglie in base al costo operativo di ciascun errore.
Le tendenze aggregate possono supportare la ricerca o il triage, ma inferire lo stato di un individuo o prendere decisioni in ambito occupazionale, creditizio, sanitario o di polizia comporta maggiori rischi. Fornire incertezza, contesto di origine, controlli sulla privacy e revisione umana.
Annotazione e costruzione del dataset
Redigere una guida all’annotazione con entità target, unità di analisi, definizioni delle etichette, gestione di casi misti e neutrali, regole di citazione, politica sul sarcasmo ed esempi del dominio. Pilotare con diversi annotatori, calcolare l’accordo, discutere le divergenze e rivedere il compito prima di scalare le etichette.
Il campionamento determina ciò che il modello apprende. Un flusso di social media può sovrarappresentare account molto attivi; i ticket di supporto possono omettere i clienti soddisfatti; le valutazioni a stelle potrebbero non corrispondere al testo della recensione. Conservare i metadati di origine e temporali, rispettare i termini della piattaforma e la privacy, e creare un set di test dalla popolazione in cui verranno prese le decisioni.
Il leakage delle etichette può verificarsi tramite valutazioni, emoji inserite dal sistema di raccolta, firme predefinite o nomi di prodotto correlati al sentiment. Deduplicare post quasi identici e raggruppare conversazioni o autori affinché il loro linguaggio non compaia su entrambi i lati di una divisione.
Scelte di modellazione e calibrazione
I sistemi basati su lessico sommano i punteggi delle parole e li aggiustano per negazione, intensificatori, punteggiatura o emoji. Forniscono un utile controllo di coerenza e possono essere adattati con termini di dominio. I modelli lineari con caratteristiche TF–IDF rimangono competitivi su alcuni dataset e rivelano n-grammi influenti.
Gli encoder contestuali rappresentano le parole in base al testo circostante e possono essere affinati per polarità o aspetti. Documenti lunghi possono richiedere modelli gerarchici, aggregazione di frasi o recupero di segmenti rilevanti. Gli approcci multilingue possono addestrare un modello condiviso, tradurre in una lingua pivot o mantenere modelli locali; ciascuno presenta compromessi di copertura e culturali.
La calibrazione delle probabilità è importante quando i punteggi attivano azioni. I grafici di affidabilità e l’errore di calibrazione atteso mostrano se una confidenza segnalata di 0,8 corrisponde a circa l’80 % di correttezza. Le soglie possono creare una banda di astensione per la revisione umana, e soglie separate possono essere giustificate quando i costi degli errori differiscono — non per nascondere una qualità disomogenea.
Applicazioni e interpretazioni errate comuni
Il sentiment aggregato può aiutare a dare priorità ai temi, confrontare le reazioni a campagne o indirizzare messaggi di servizio urgenti. L’analisi degli aspetti è spesso più azionabile della polarità complessiva perché identifica di cosa parlano le persone. L’analisi delle tendenze richiede un campionamento stabile e definizioni delle etichette coerenti nel tempo.
Non equiparare la prevalenza di post negativi all’opinione della popolazione. Il comportamento di pubblicazione, i bot, la moderazione, la demografia della piattaforma, le campagne e le query di raccolta modellano il campione. Un modello di sentiment non misura la popolazione silenziosa, e un cambiamento nella formulazione può apparire come un cambiamento di atteggiamento.
Per decisioni individuali, etichette false possono essere stigmatizzanti e difficili da contestare. Evitare di usare il sentiment come proxy per l’engagement dei dipendenti, la salute mentale, l’affidabilità creditizia, l’intento o l’inganno. Quando le persone sono coinvolte, mostrare il contesto di origine, consentire correzioni e richiedere un decisore umano con reale discrezione.
Esempio pratico: analisi del sentiment per il feedback dei clienti
Un’azienda che analizza i commenti di supporto dovrebbe definire se ha bisogno di sentiment a livello di documento, sentiment di aspetto, emozione, urgenza o classificazione del problema. “La consegna è stata veloce ma il prodotto si è rotto” non può essere rappresentato fedelmente da un’unica etichetta positiva‑o‑negativa. Creare una guida all’annotazione per obiettivi, negazione, sarcasmo, affermazioni miste, discorsi citati e casi sconosciuti, quindi misurare l’accordo prima di trattare le etichette come verità di base.
Confrontare un lessico o una baseline lineare con un encoder fine‑tuned o un modello linguistico con prompting. Suddividere i dati per tempo o cliente per prevenire il leakage di quasi‑duplicati e conservare la prevalenza delle classi. Riportare precisione, recall, F1, calibrazione e matrice di confusione per lingua, canale, prodotto e proxy demografici solo dove legale e giustificato. Revisionare gli errori ad alta confidenza perché sono più pericolosi nel routing automatizzato rispetto a output incerti che vengono escalati.
Usare il sentiment come un segnale per l’aggregazione o la priorità, non come una misura indiscutibile dello stato di una persona. Monitorare il vocabolario e il drift del prodotto, riaddestrare con esempi revisionati e consentire agli operatori di correggere le etichette. Non inferire tratti protetti né disciplinare i dipendenti basandosi su punteggi di sentiment non convalidati. Per i report esecutivi, mostrare la dimensione del campione, l’incertezza, i dati mancanti e i temi che guidano il cambiamento, così un punteggio fluttuante porta a un’indagine anziché a una conclusione semplificata.
Il dispiegamento multilingue non dovrebbe presumere che la traduzione degli input conservi tono, negazione, idiomi o convenzioni culturali. Convalidare ogni lingua supportata e i pattern multilingue con revisori madrelingua, e fornire un risultato “sconosciuto” quando le evidenze sono deboli. L’adattamento al dominio è altrettanto importante: parole che suonano negative nella conversazione comune possono essere descrizioni tecniche neutre. Mantenere soglie o modelli separati solo quando le evidenze operative giustificano la complessità aggiuntiva e il carico di governance.
Checklist di implementazione pratica
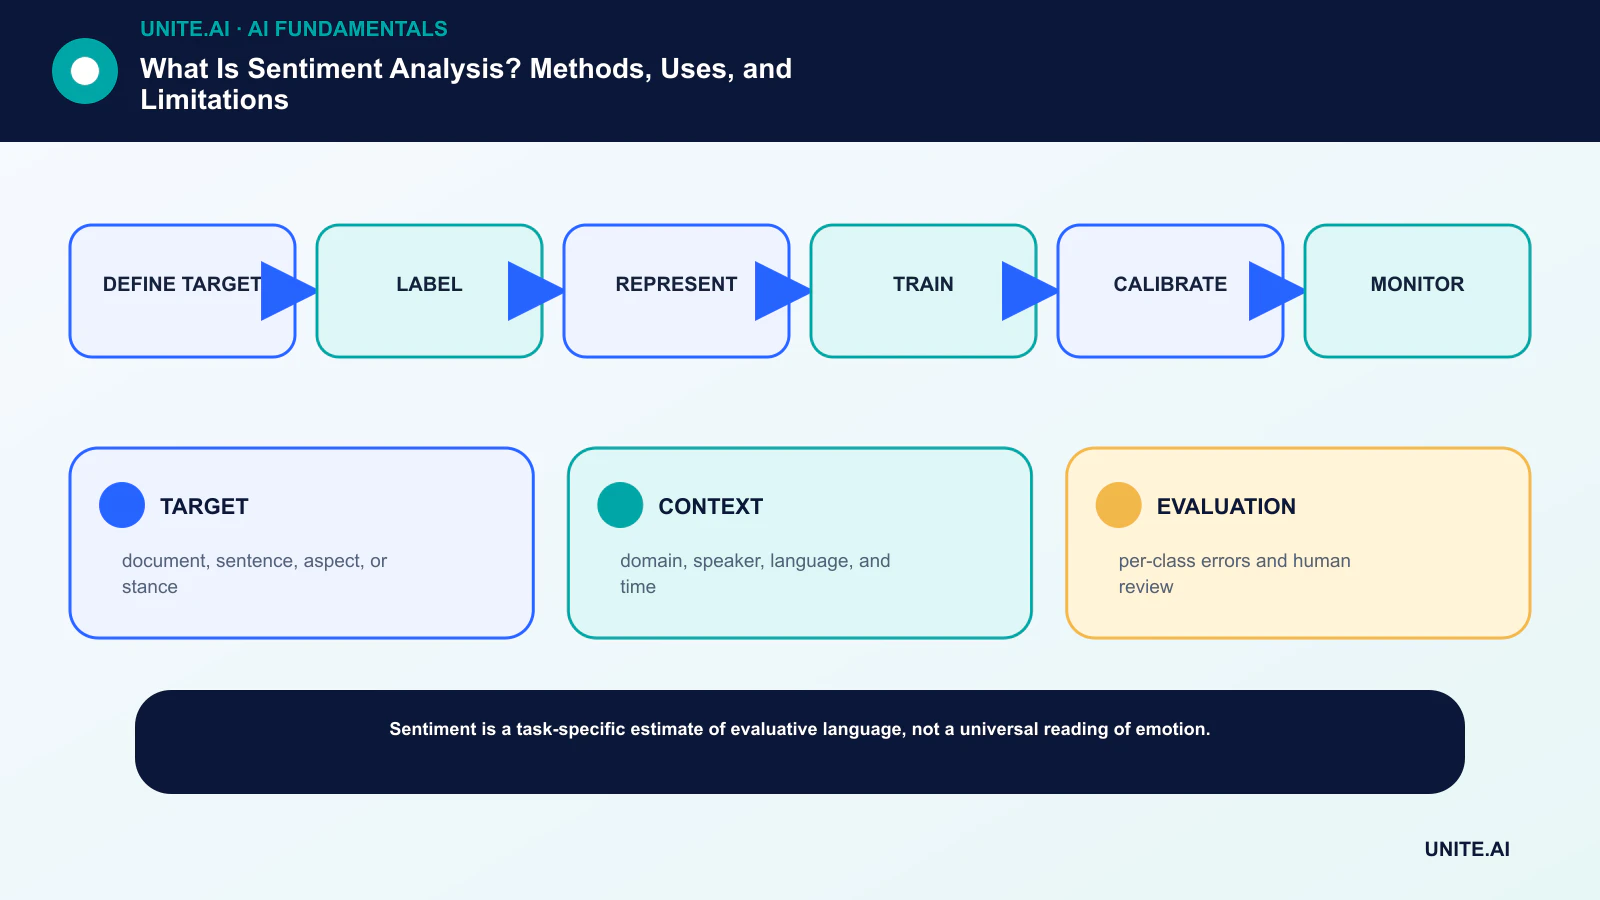
Trasformare il concetto in un flusso di lavoro limitato e verificabile: definire obiettivo → etichetta → rappresentazione → addestramento → calibrazione → monitoraggio. Assegnare un responsabile, documentare i dati e le dipendenze, stabilire una baseline semplice, impostare criteri di accettazione e di interruzione, testare guasti rappresentativi e definire monitoraggio, rollback e revisione prima di ampliare lo scopo. Registrare versioni e ipotesi affinché un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, eseguire una revisione di prontezza documentata con le persone che costruiscono, gestiscono, mettono in sicurezza e sono interessate dal sistema. Testare casi normali, condizioni di confine, guasti di dipendenze e usi impropri; conservare le evidenze e i rischi irrisolti. Definire chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Rivalutare la decisione dopo l’arrivo dei dati reali, poiché un pilot tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- TARGET: documento, frase, aspetto o posizione.
- CONTEXT: dominio, interlocutore, lingua e tempo.
- EVALUATION: errori per classe e revisione umana.
Domande frequenti
L’analisi del sentiment è obiettiva?
No. Stima etichette definite da un compito e da un processo di annotazione. Alcuni testi sono davvero ambigui, misti, dipendenti dal contesto o interpretati diversamente dai lettori.
L’analisi del sentiment può rilevare il sarcasmo?
I modelli possono apprendere alcuni pattern, ma il sarcasmo dipende spesso dalla storia dell’interlocutore, dalla conoscenza condivisa e dal contesto al di fuori del testo. Rimane una modalità di errore comune.
Riferimenti principali












