
Fondamenti di IA
Cos’è il riconoscimento vocale conversazionale (CSR)?

 Aggiungi Unite.AI alle tue fonti preferite su Google
Il riconoscimento vocale conversazionale (CSR) estende il riconoscimento automatico del parlato oltre la trascrizione isolata, utilizzando il contesto del dialogo, i segnali di turnazione, le informazioni sugli interlocutori e l’elaborazione a bassa latenza. L’obiettivo è supportare un’interazione in tempo reale in cui parole, tempi, interruzioni e turni precedenti sono tutti rilevanti.
Il CSR è un’etichetta emergente sia per prodotti sia per la ricerca, non una singola classe di modello standardizzata. Un sistema solido combina l’ASR in streaming con il rilevamento dei punti finali, la gestione degli interlocutori, la modellazione linguistica contestuale, lo stato del dialogo e una politica di risposta, per poi valutare l’esperienza end‑to‑end.
Punti chiave
- Il riconoscimento in streaming emette ipotesi provvisorie e le revisiona man mano che arriva più audio.
- Il rilevamento del punto finale e la previsione del turno sono separati dalla precisione della trascrizione.
- La cronologia della conversazione e le parole chiave possono migliorare il riconoscimento, ma possono anche propagare errori precedenti.
- Valutare latenza, interruzioni, interlocutori, accenti, rumore, privacy e completamento del compito, non solo il tasso di errore delle parole.
Da ASR al dialogo in tempo reale
L’ASR tradizionale mappa l’audio in testo. Un sistema conversazionale deve decidere quando ascoltare, quando un turno è completo, se il parlato è rivolto al sistema e come recuperare quando la sua trascrizione o risposta è errata.
I modelli in streaming elaborano i frame in modo incrementale e producono trascrizioni parziali. Una bassa latenza migliora la reattività, ma un impegno prematuro può aumentare revisioni o errori. L’applicazione necessita di una politica per distinguere testo stabile da quello provvisorio.
Turnazione, sovrapposizione e interlocutori
La sola durata del silenzio è un segnale di fine turno debole. Il completamento lessicale, la prosodia, il timing, lo sguardo e lo stato del dialogo possono aiutare a prevedere se una persona sta mantenendo o cedendo la parola. L’interruzione (barge‑in) consente all’utente di interrompere il parlato sintetizzato senza perdere il contesto.
Le voci sovrapposte e la diarizzazione rimangono difficili. I sistemi dovrebbero preservare l’incertezza sull’interlocutore, evitare di attribuire una dichiarazione alla persona sbagliata e fornire un percorso di correzione, soprattutto per registrazioni utilizzate in ambito sanitario, finanziario o legale.
Riconoscimento contestuale
I turni precedenti possono disambiguare nomi e riferimenti; le liste di parole chiave possono orientare il riconoscimento verso termini di dominio. I modelli di linguaggio vocale possono codificare il contesto audio e testuale in un framework condiviso di prompting o attenzione.
Il contesto può anche rafforzare una trascrizione precedente errata o far trapelare informazioni tra sessioni. Limita la cronologia allo scopo corrente, separa i metadati affidabili dal parlato dell’utente e utilizza il contesto dei transformer con regole esplicite di conservazione e accesso.
Valutazione e distribuzione responsabile
Segnalare il tasso di errore delle parole in streaming, la latenza del primo token e della finalizzazione, il tasso di revisione, gli errori di endpoint, il successo del barge‑in, l’attribuzione degli interlocutori e il completamento del compito. Testare microfoni reali, rumore, accenti, code‑switching, disabilità e parlato carico di emozioni.
I dati vocali possono identificare o rivelare informazioni sensibili. Applicare il consenso, la minimizzazione, la crittografia, i limiti di conservazione e la revisione umana. Collegare le risposte generate ai controlli di sicurezza dei chatbot, perché una trascrizione accurata non rende una risposta corretta o autorizzata.
Dall’input acustico allo stato conversazionale
Un sistema di riconoscimento vocale conversazionale cattura l’audio, applica il conditioning del segnale, rileva il parlato, riconosce parole o unità semantiche, identifica gli interlocutori quando necessario e aggiorna lo stato del dialogo. I sistemi in streaming producono ipotesi parziali prima che l’utteranza termini. Quelle ipotesi possono cambiare, quindi i componenti a valle devono distinguere i risultati provvisori da quelli finali.
Il rilevamento dell’attività vocale e il rilevamento del punto finale decidono quando inizia il parlato e quando l’utente ha finito. Soglie di silenzio fisse falliscono con parlanti lenti, rumore di fondo e pause di riflessione. I modelli di turnazione possono usare parole, prosodia, sguardo e contesto del dialogo, ma devono bilanciare una risposta rapida con il rischio di interrompere l’interlocutore.
La diarizzazione risponde a chi ha parlato e quando; il riconoscimento dell’interlocutore stima l’identità; la separazione della sorgente isola le voci sovrapposte. Sono compiti diversi con rischi differenti. In riunioni, sanità e assistenza clienti, attribuire le parole giuste alla persona giusta può essere importante quanto il tasso di errore delle parole della trascrizione.
Contesto, sovrapposizione, emozione e recupero dell’interazione
Il contesto conversazionale risolve pronomi, ellissi, correzioni, termini di dominio e riferimenti a turni precedenti. Un sistema può combinare prove acustiche con la cronologia del dialogo e conoscenze recuperate, ma il contesto precedente può anche orientare il riconoscimento verso un’aspettativa errata. Conservare le prove audio e la confidenza affinché il contesto non sovrascriva silenziosamente l’incertezza.
Il dialogo naturale include backchannel, interruzioni, falsi inizi, risate, code‑switching e parlato simultaneo. Un agente reattivo ha bisogno di gestire il barge‑in: interrompere o abbassare l’output, catturare il nuovo parlato dell’utente, decidere se l’interruzione cambia l’intento e recuperare senza duplicare o perdere un’azione.
La prosodia e i segnali paralinguistici possono indicare enfasi o incertezza, ma inferire emozioni, salute o intento dalla voce è soggetto a errori e dipende dalla cultura. Utilizzare tali stime con cautela, divulgarle quando opportuno e non prendere decisioni importanti basate su un’etichetta emotiva non convalidata.
Valutazione, privacy e progettazione di produzione
Il tasso di errore delle parole resta utile, ma la valutazione conversazionale dovrebbe misurare anche l’attribuzione degli interlocutori, l’accuratezza delle entità, il successo semantico del compito, la stabilità delle ipotesi parziali, la latenza del punto finale, il successo delle interruzioni, il recupero e il tasso di correzione dell’utente. Segmentare per accento, lingua, dispositivo, rumore, sovrapposizione, stile di parlato e condizioni di rete.
L’architettura in streaming richiede buffer limitati, back‑pressure, riconnessione, numeri di sequenza e finalizzazione esplicita. Tenere separati i budget di latenza del modello e del dialogo, tracciare ogni fase e testare reti degradate. Quando un sistema attiva azioni, confermare l’intento ad alto impatto e rendere i tentativi di nuovo idempotenti affinché audio ripetuti o riconnessioni non duplicano le transazioni.
Il parlato contiene informazioni di identità, contenuto, ambiente e spettatori. Minimizzare la conservazione, crittografare il trasporto e l’archiviazione, controllare l’accesso, definire la cancellazione e distinguere l’audio dalle trascrizioni e dagli embedding derivati. Fornire indicatori visibili di registrazione e alternative quando il consenso è assente. Un modello locale può ridurre il trasferimento ma richiede comunque permessi e controlli sul ciclo di vita.
Esempio pratico: un agente vocale che gestisce interruzione e correzione
Un chiamante dice, ‘Prenota martedì—no, mercoledì pomeriggio,’ mentre l’agente inizia a rispondere dopo ‘martedì.’ Il riconoscimento in streaming emette trascrizioni parziali in evoluzione, il rilevamento del punto finale individua il parlato continuato e il barge‑in interrompe l’output. Lo stato del dialogo segna la data precedente come superata anziché creare due richieste. La conferma dell’entità si concentra sulla data e l’ora corrette, mentre il sistema conserva la confidenza e le prove per l’interpretazione finale.
L’architettura separa la cattura dell’audio, il rilevamento del parlato, il riconoscimento in streaming, la gestione degli interlocutori, la politica del dialogo, l’esecuzione degli strumenti e la sintesi. I numeri di sequenza e la finalizzazione impediscono che risultati parziali tardivi sovrascrivano la trascrizione finale. Lo strumento di prenotazione accetta una richiesta strutturata, verifica autorizzazione e disponibilità, e utilizza una chiave di idempotenza. Una prenotazione consequenziale viene letta e confermata prima dell’esecuzione; una riconnessione non può ripeterla silenziosamente.
I test combinano l’accuratezza di parole ed entità con la latenza del punto finale, il successo delle interruzioni, la gestione delle correzioni, l’attribuzione degli interlocutori, il completamento del compito e il tasso di azioni duplicate. Gli scenari coprono rumore, sovrapposizione, accenti, code‑switching, parlato lento, dispositivi di assistenza, reti deboli e attacchi sintetici. La conservazione dell’audio è minimizzata e divulgata, i dati degli spettatori sono gestiti esplicitamente e gli utenti possono passare al testo o a un operatore umano. L’intelligenza conversazionale è misurata dal recupero sicuro e dal risultato, non solo dall’accuratezza della trascrizione.
Checklist di implementazione pratica
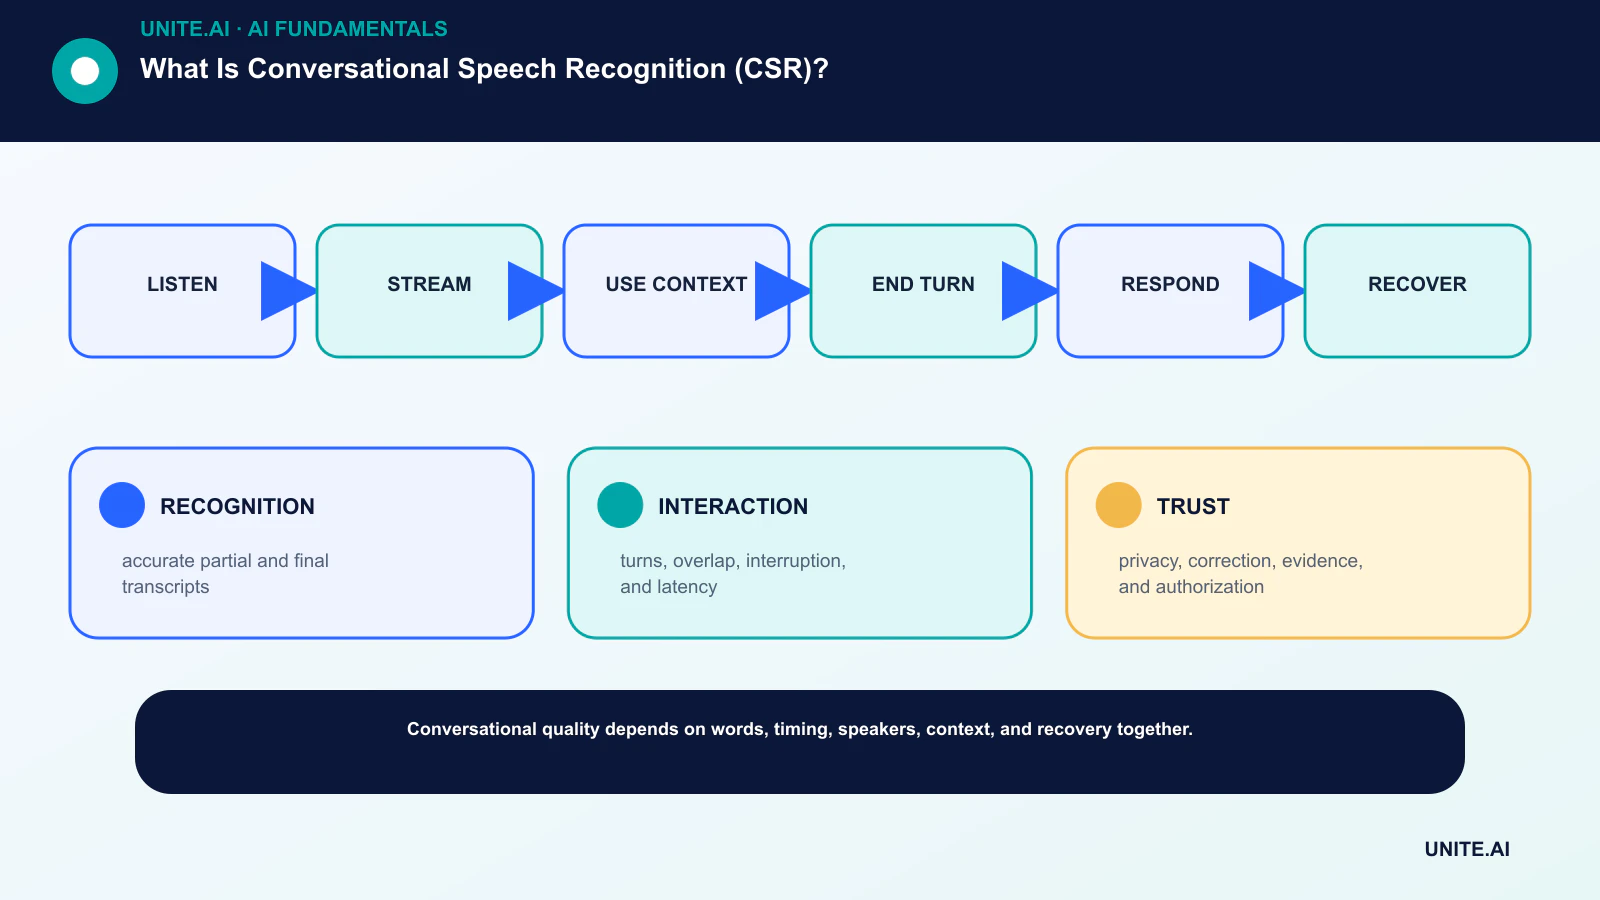
Trasforma il concetto in un flusso di lavoro limitato e verificabile: ascoltare → stream → usare il contesto → chiudere il turno → rispondere → recuperare. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa i fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare l’ambito. Registra versioni e assunzioni affinché un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, gestiscono, proteggono e sono interessate dal sistema. Testa casi normali, condizioni limite, fallimenti di dipendenze e usi impropri; conserva le prove e i rischi irrisolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesamina la decisione dopo l’arrivo dei dati reali, perché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- RICONOSCIMENTO: trascrizioni parziali e finali accurate.
- INTERAZIONE: turni, sovrapposizione, interruzione e latenza.
- FIDUCIA: privacy, correzione, prove e autorizzazione.
Domande frequenti
Il CSR è diverso dall’ASR?
L’ASR è il componente di conversione da parlato a testo. Il CSR utilizza l’ASR insieme al contesto del dialogo, al timing, alla gestione degli interlocutori e dei punti finali, e a politiche di interazione per la conversazione in tempo reale.
Un tasso di errore delle parole più basso garantisce un agente vocale migliore?
No. Un sistema può trascrivere con precisione ma interrompere gli utenti, rispondere lentamente, attribuire erroneamente gli interlocutori o compiere l’azione sbagliata. Sono necessari metriche di interazione end‑to‑end.
Riferimenti principali












