Fondamenti di IA
Che cos’è l’Emotion AI (Computazione affettiva) e perché è importante?

 Aggiungi Unite.AI alle tue fonti preferite su Google
L’Emotion AI, spesso definita computazione affettiva, applica il calcolo a segnali associati all’affetto, come linguaggio, prosodia vocale, movimento facciale, postura, fisiologia o pattern di interazione. Un sistema può classificare un’etichetta, stimare dimensioni come valenza e attivazione, o adattare un’interfaccia.
Il risultato è un’inferenza — non una lettura diretta di uno stato emotivo interno. Le espressioni variano a seconda della persona, della cultura, del contesto, della salute e della situazione, così lo stesso segnale osservabile può supportare diverse spiegazioni. Gli usi ad alto rischio richiedono prove solide, consenso e una revisione legale.
Punti chiave
- Definire con precisione l’obiettivo osservabile; emozione, espressione, sentimento, stress e coinvolgimento non sono intercambiabili.
- Validare sulla popolazione e sull’ambiente di destinazione, non solo su un benchmark curato.
- Preferire assistenza e controllo da parte dell’utente rispetto a sorveglianza nascosta o a giudizi automatizzati con conseguenze.
- Documentare l’incertezza, i diritti sui dati, la conservazione, le prestazioni dei sottogruppi e un percorso per contestare le decisioni.
Segnali e obiettivi dei modelli
I modelli di testo possono stimare il sentimento espresso; i modelli audio utilizzano tempistica, intonazione e energia; i modelli di visione analizzano i movimenti; i sistemi fisiologici possono impiegare la frequenza cardiaca o la conduttanza cutanea. I sistemi multimodali combinano i segnali, ma più sensori non generano automaticamente un’etichetta più veritiera.
Un’etichetta come “frustrato” dipende dalle istruzioni di annotazione e dal contesto. Analisi del sentimento delle parole è più limitata rispetto all’inferenza della condizione emotiva di una persona, e nessuna delle due dovrebbe essere confusa con una valutazione clinica.
Perché contesto e incertezza dominano
Le persone mascherano, esagerano o esprimono i sentimenti in modo diverso. Disabilità, lingua, illuminazione, qualità del microfono e norme sociali possono modificare i segnali osservati. I dataset di laboratorio potrebbero non rappresentare un call center, una classe, un veicolo o una clinica.
Valutare la calibrazione, l’astensione, gli errori per gruppo, le prestazioni cross‑domain e le alternative. Matrici di confusione aiutano a mostrare quali etichette vengono confuse, ma è necessaria una revisione qualitativa per capire il perché.
Applicazioni utili e rischiose
Le applicazioni controllate dall’utente possono supportare l’accessibilità, la scrittura riflessiva, la formazione adattiva o un avviso di sicurezza. Questi usi dovrebbero indicare chiaramente cosa viene misurato, consentire correzioni e evitare di sovrastimare la certezza.
Le decisioni in ambito occupazionale, educativo, assicurativo, di polizia e sanitario comportano rischi molto più elevati. Il Regolamento IA dell’UE vieta alcuni usi del riconoscimento delle emozioni nei luoghi di lavoro e nell’istruzione, soggetti a eccezioni specifiche, e classifica gli altri usi in base al rischio. I requisiti variano a seconda della giurisdizione e cambiano nel tempo.
Implementazione responsabile
Chiedersi se il compito richieda davvero un’inferenza emotiva. Utilizzare la minimizzazione dei dati, uno scopo esplicito, una breve conservazione, la sicurezza, test indipendenti, avviso all’utente e revisione umana. Evitare di costruire profili secondari da segnali raccolti per un altro scopo.
Applicare le pratiche di AI spiegabile senza suggerire che una mappa di salienza provi un’emozione. Comunicare l’incertezza in linguaggio semplice e fornire un modo significativo per rinunciare o contestare un risultato con conseguenze.
Come viene rappresentato l’affetto
I modelli categoriali prevedono etichette come gioia, rabbia, paura, tristezza o neutro. I modelli dimensionali stimano valori continui come valenza, attivazione e dominanza. I modelli di valutazione descrivono come una persona valuta un evento. Queste rappresentazioni sono teorie e scelte di misurazione, non verità di base intercambiabili.
Le annotazioni possono provenire dalla persona che vive l’evento, da un osservatore, da un clinico o da un protocollo sperimentale. L’auto‑report ha limiti introspezionali e di memoria; le etichette degli osservatori inferiscono lo stato dal comportamento; le misurazioni fisiologiche riflettono l’attivazione e molti processi non emotivi. Un dataset dovrebbe indicare a quale prospettiva appartiene l’etichetta.
La modellazione temporale è importante perché l’affetto si sviluppa nel tempo. Le etichette facciali a livello di frame possono reagire eccessivamente a movimenti transitori, mentre una media a livello di enunciato può nascondere cambiamenti. La durata della finestra, la sincronizzazione tra sensori, i canali mancanti e le baseline dei parlanti influenzano il risultato.
Pipeline di modellazione per modalità
Le pipeline di visione rilevano e allineano volti o corpi, estraggono frame o punti di riferimento, quindi classificano caratteristiche spaziali e temporali. Occlusione, angolazione della fotocamera, compressione, tono della pelle, occhiali, differenze facciali e espressioni deliberate possono alterare le prestazioni. Le unità di azione facciale descrivono il movimento più direttamente di un’emozione dichiarata e possono rappresentare un obiettivo più sicuro.
Le pipeline audio separano la voce, normalizzano il livello e modellano pattern spettrali, prosodici e temporali. Un aumento dell’intonazione può indicare eccitazione, stress, una domanda o un’abitudine del parlante. Le pipeline di testo catturano la valutazione espressa e il contesto ma perdono il tono a meno che non siano combinate con l’audio. La fusione multimodale può avvenire a livello di feature, decisione o di cross‑attention.
La personalizzazione può calibrare la baseline di un individuo, ma richiede più dati e crea un profilo longitudinale sensibile. I sistemi dovrebbero preferire adattamenti locali o di breve durata quando possibile e devono evitare di utilizzare i dati di una persona per inferenze non correlate senza uno scopo valido.
Valutazione, fattori umani e misure di sicurezza
Dividere casualmente i frame dello stesso video tra training e test genera leakage. Tenere separati persone, sessioni, dispositivi, siti e periodi temporali in base alla dichiarazione prevista. Segnalare metriche macro affinché le classi comuni non nascondano fallimenti su stati rari e includere un’opzione di astensione per input ambigui.
Gli studi con gli utenti dovrebbero misurare se l’adattamento è davvero utile. Un’interfaccia che modifica il tono basandosi su un’inferenza errata può risultare invadente o paternalistica. Consentire agli utenti di correggere il sistema, scegliere il grado di adattamento e vedere la ragione funzionale di una risposta senza assegnare un’etichetta emotiva definitiva.
Le implementazioni ad alto rischio richiedono una valutazione d’impatto, una revisione legale, la sicurezza e un divieto di usi secondari. Conservare video o dati biometrici grezzi solo quando necessario, limitare l’accesso e definire la cancellazione. Non utilizzare i punteggi emotivi come unica prova di inganno, performance, competenza, intento o salute mentale.
Valutare un caso d’uso di Emotion AI prima del deployment
Iniziare definendo la costruzione dichiarata: movimento facciale, prosodia vocale, sentimento auto‑riportato, comportamento osservato o uno stato clinico non sono intercambiabili. Identificare la decisione che utilizzerà l’output e se un segnale meno invasivo può servirla. Un sistema che adatta la difficoltà del gioco in base a un feedback esplicito di frustrazione ha un profilo di evidenza e rischio diverso rispetto a uno che inferisce l’onestà di un dipendente da una webcam.
La validazione richiede persone, culture, lingue, dispositivi, contesti e condizioni di registrazione rappresentative, con una verità di base adeguata alla dichiarazione. Confrontare con baseline semplici e segnalare incertezza, errore per sottogruppo, disaccordo tra valutatori e prestazioni al di fuori del laboratorio. Non convertire un punteggio probabilistico in una dichiarazione categorica su ciò che una persona sente. Offrire agli utenti correzioni, la possibilità di rinunciare e un percorso non biometrico quando possibile.
Vietare decisioni con conseguenze basate esclusivamente su emozioni inferite, soprattutto in ambito occupazionale, educativo, assicurativo, di polizia, sanitario e nell’accesso ai servizi. Ridurre al minimo la conservazione di audio e video grezzi, isolare gli identificatori biometrici e controllare gli usi secondari. La documentazione dovrebbe spiegare il contesto di addestramento, l’uso previsto, gli usi non validi e i fattori di confondimento noti come disabilità, mascheramento, stress, cultura o farmaci. L’Emotion AI è una affermazione di misurazione che richiede prove, non una finestra magica sull’esperienza interna.
Checklist di implementazione pratica
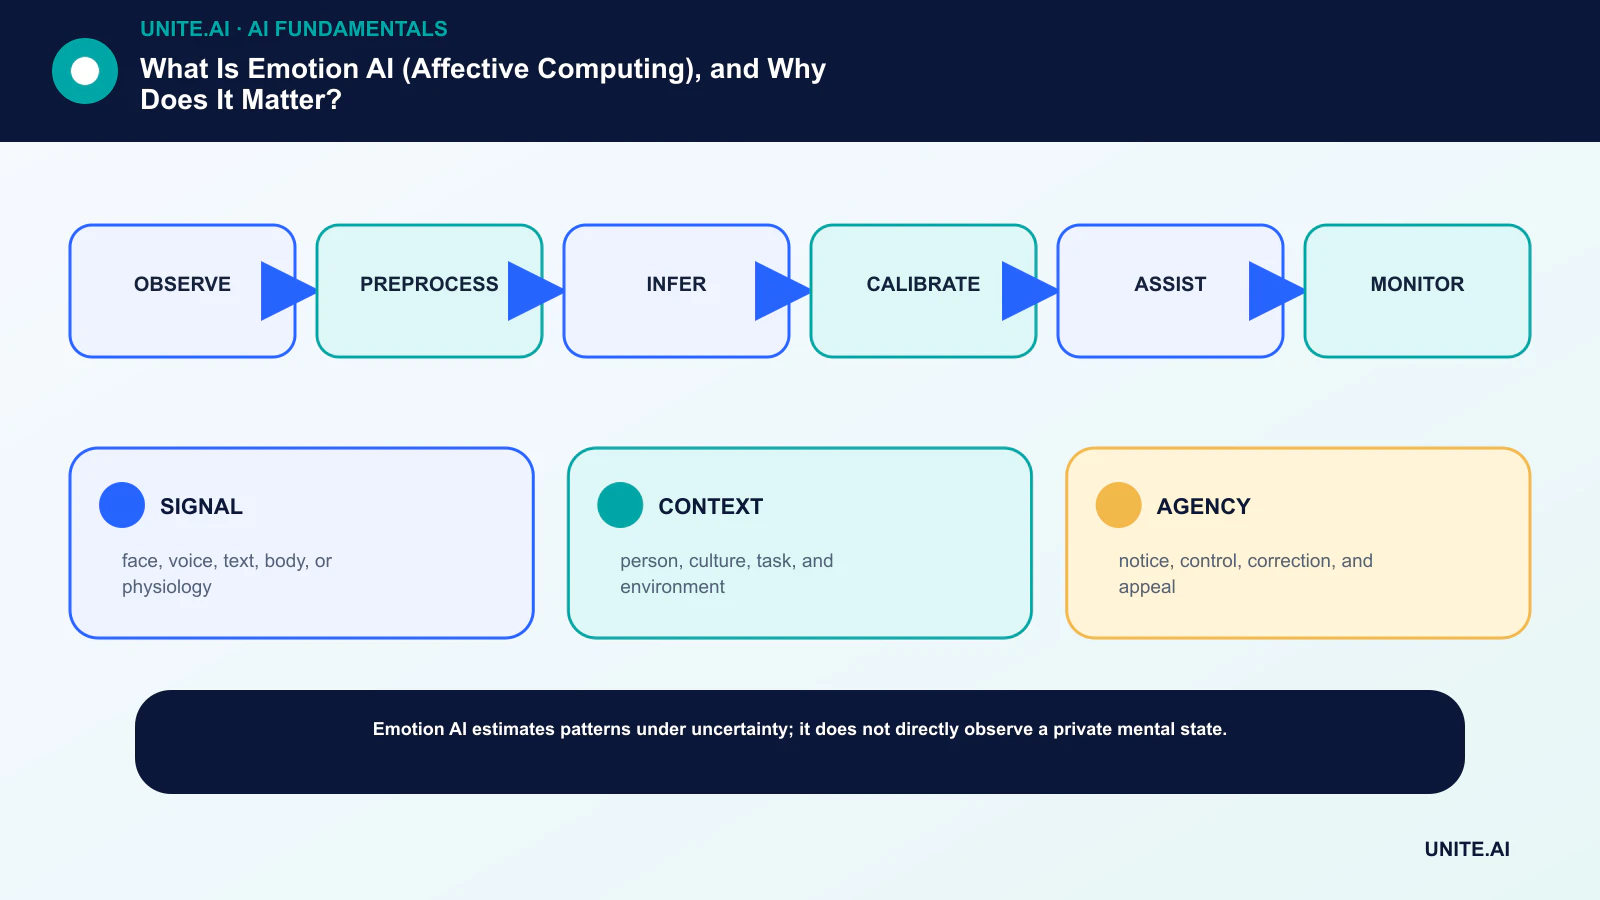
Trasformare il concetto in un flusso di lavoro delimitato e testabile: osservare → pre‑elaborare → inferire → calibrare → assistere → monitorare. Assegnare un responsabile, documentare i dati e le dipendenze, stabilire una baseline semplice, definire criteri di accettazione e di interruzione, testare fallimenti rappresentativi e definire monitoraggio, rollback e revisione prima di ampliare il campo d’azione. Registrare versioni e ipotesi affinché un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, eseguire una revisione di prontezza documentata con le persone che costruiscono, gestiscono, proteggono e sono interessate dal sistema. Testare casi normali, condizioni di confine, guasti di dipendenza e usi impropri; conservare le evidenze e i rischi non risolti. Definire chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesaminare la decisione dopo l’arrivo dei dati reali, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- SIGNAL: volto, voce, testo, corpo o fisiologia.
- CONTEXT: persona, cultura, compito e ambiente.
- AGENCY: avviso, controllo, correzione e ricorso.
Domande frequenti
L’IA può leggere accuratamente le emozioni da un volto?
Può prevedere le etichette del dataset a partire dai movimenti facciali, ma tali movimenti non determinano in modo univoco un’emozione interna. L’accuratezza dipende fortemente dal contesto, dalla popolazione, dalle etichette e dal design della misurazione.
L’Emotion AI è legale?
Dipende dall’uso, dai dati, dalle persone e dalla giurisdizione. Alcuni contesti sono proibiti o ad alto rischio. Le organizzazioni hanno bisogno di consulenza legale aggiornata, non di una checklist tecnica generica.
Riferimenti principali