Fondamenti di IA
Come funziona la classificazione delle immagini?

 Aggiungi Unite.AI alle tue fonti preferite su Google
La classificazione delle immagini prevede un’etichetta per l’intera immagine. Risponde a domande come “Quale categoria di prodotto è mostrata?” o “Questa scansione contiene un risultato target?” Non individua di per sé ciascun oggetto né ne delinea i pixel.
I sistemi moderni utilizzano comunemente reti neurali convoluzionali o transformer visivi, spesso inizializzati con pesi preaddestrati. Prestazioni affidabili dipendono ancora da etichette, campionamento, augmentazione, calibrazione e test in condizioni di distribuzione reale.
Punti chiave
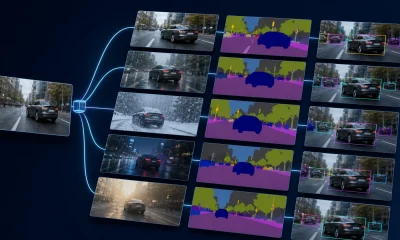
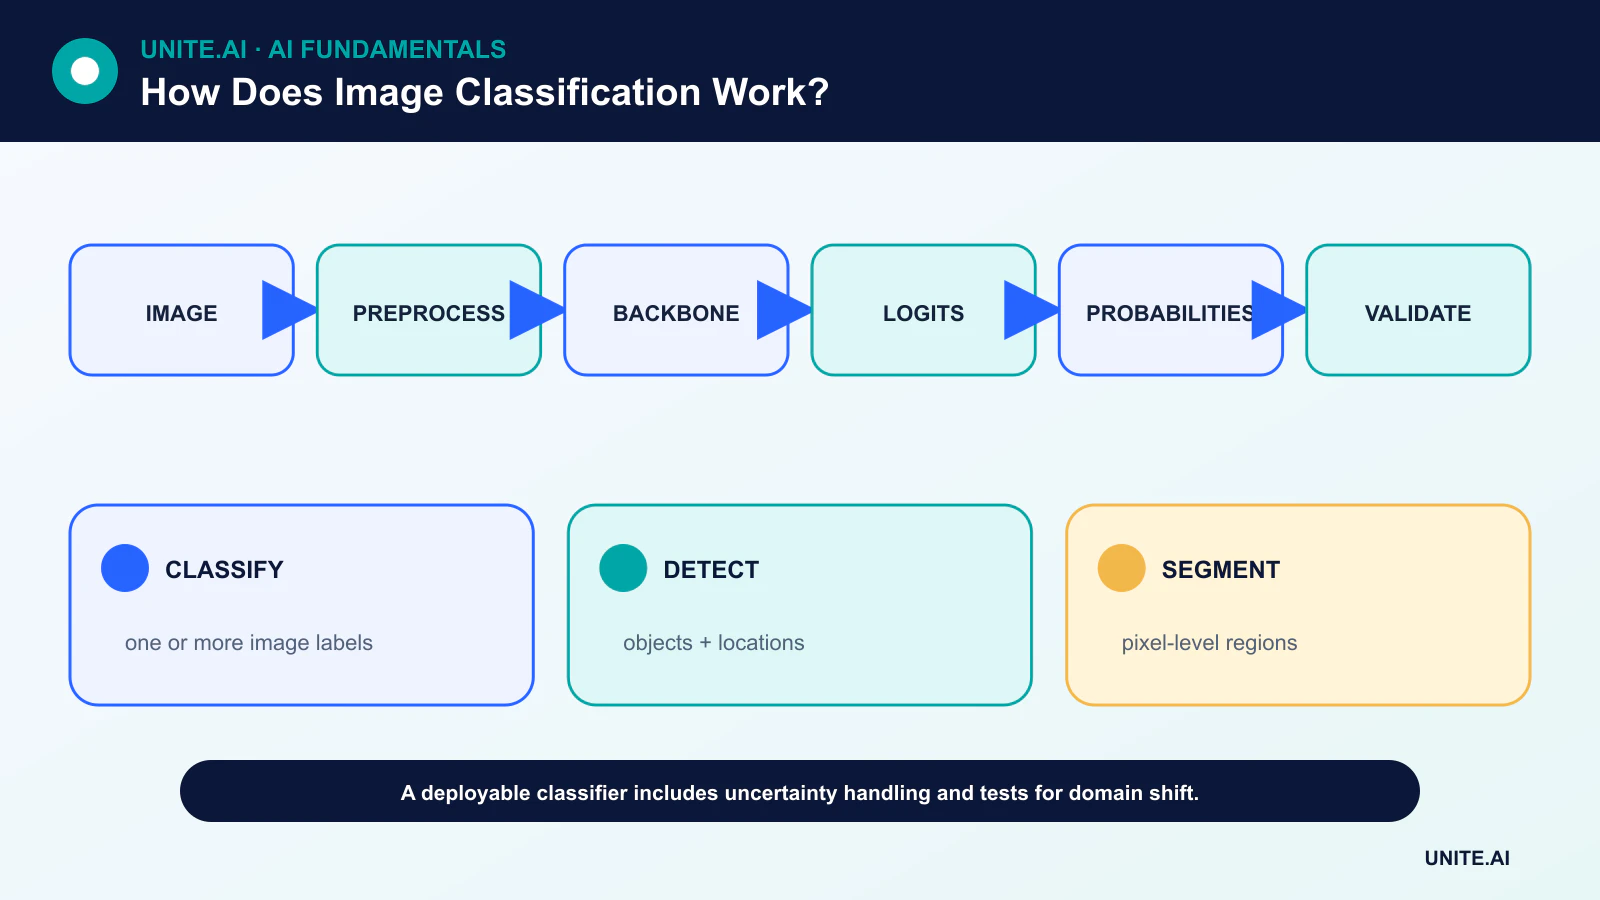
- La classificazione etichetta l’intera immagine; il rilevamento disegna riquadri per gli oggetti e la segmentazione assegna regioni a livello di pixel.
- Il preaddestramento e il transfer learning possono ridurre i requisiti di dati, ma una discrepanza di dominio può annullare il beneficio.
- L’accuratezza globale può nascondere squilibri di classe, scorciatoie spurie e scarsa calibrazione.
- Qualità dell’immagine, dispositivo di acquisizione, geografia e variazioni del flusso di lavoro possono tutti generare uno spostamento della distribuzione.
Da pixel a punteggi
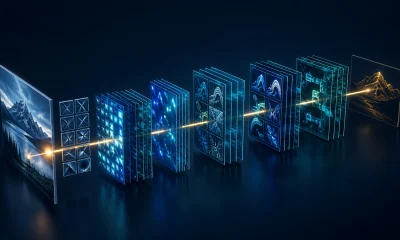
Le immagini vengono ridimensionate o ritagliate, normalizzate e convertite in tensori. L’augmentazione dei dati può applicare trasformazioni che preservano le etichette, come capovolgimenti, ritagli o variazioni di colore. Un backbone mappa i pixel in caratteristiche; una testa di classificazione produce logit che vengono convertiti in punteggi di classe relativi.
Il preprocessing scelto deve corrispondere alla distribuzione. Un ritaglio centrale che rimuove l’oggetto rilevante o una normalizzazione non corrispondente può compromettere le prestazioni anche se i pesi addestrati rimangono invariati.
CNN e transformer visivi
Le reti neurali convoluzionali utilizzano filtri locali e pesi condivisi per costruire caratteristiche spaziali. Le connessioni residuali hanno reso più facile l’ottimizzazione di CNN molto profonde. I transformer visivi suddividono un’immagine in patch e usano l’attenzione per modellare le relazioni tra di esse.
I confronti tra architetture dovrebbero controllare dati di addestramento, augmentazione, capacità di calcolo e risoluzione. Il modello migliore su un benchmark pubblico potrebbe non essere il più adatto per un dispositivo edge, un piccolo set di dati o un requisito di spiegabilità.
Transfer learning e progettazione dei dati
Il transfer learning parte da pesi addestrati su un dataset sorgente più ampio. Un team può congelare il backbone, affinare gli strati successivi o aggiornare l’intero modello. L’affinamento richiede solitamente un tasso di apprendimento più basso e un set di validazione sicuro da perdite.
Le etichette dovrebbero descrivere ciò che è visibilmente inferibile. Se una diagnosi dipende dalla storia clinica del paziente non presente nell’immagine, il classificatore non può apprendere l’intera decisione clinica. Duplicati, fotogrammi di uno stesso video e immagini dello stesso soggetto devono rimanere nello stesso split.
Metriche, incertezza e scorciatoie
L’accuratezza Top-1 richiede che la classe con il punteggio più alto sia corretta; l’accuratezza top‑k accetta la classe corretta tra le k classi con i punteggi più alti. Precisione, richiamo per classe e una matrice di confusione rivelano errori non uniformi.
I modelli possono sfruttare sfondi, filigrane, apparecchiature di acquisizione o inquadrature invece dell’oggetto desiderato. Test controfattuali, analisi di sottogruppi e strumenti di salienza possono aiutare a scoprire scorciatoie, ma una mappa di calore esplicativa non è prova di ragionamento causale.
Monitoraggio in produzione
I controlli in produzione dovrebbero coprire file corrotti, dimensioni inattese, sfocatura, illuminazione, modelli di fotocamere e nuove classi. La confidenza dovrebbe essere calibrata su dati simili a quelli di distribuzione, e gli input fuori ambito dovrebbero essere rifiutati o revisionati.
Il monitoraggio di etichette ritardate e delle variazioni nei costi di errore è essenziale. Un modello che sembra stabile secondo le statistiche di input può comunque fallire se la relazione tra pixel ed etichette cambia.
Creazione di un dataset per la classificazione delle immagini
La classificazione delle immagini assegna una o più etichette all’intera immagine. Si differenzia dal rilevamento, che localizza gli oggetti, e dalla segmentazione, che etichetta i pixel. Definire l’ambito delle classi, la gerarchia, le regole multi‑etichetta, le categorie di sfondo o sconosciute e quali evidenze devono essere visibili. Raccogliere fotocamere, location, illuminazione, punti di vista, distanze e soggetti rappresentativi dell’ambiente di distribuzione. Suddividere per soggetto, scena, sessione o origine prima dell’augmentazione; fotogrammi video adiacenti o immagini di prodotto duplicate tra le partizioni causano gravi perdite.
Le istruzioni di annotazione dovrebbero coprire occlusione, oggetti ambigui, classi multiple, bassa qualità e astensione. Misurare l’accordo e revisionare i disaccordi sistematici. Il solo bilanciamento delle classi non garantisce la copertura: una classe di malattia può includere un solo dispositivo o una classe di fauna un unico sfondo. Ispezionare i metadati e i quasi‑duplicati, e mantenere un set di test protetto da acquisizioni indipendenti. Dati sintetici e scraping web possono ampliare la varietà ma introdurre problemi di licenza, provenienza, stile e etichette che devono essere valutati su immagini reali.
Modelli, addestramento e valutazione
I metodi classici combinano descrittori ingegnerizzati con un classificatore; i sistemi moderni usano reti convoluzionali o transformer visivi, spesso tramite transfer learning. Le scelte di ridimensionamento e ritaglio determinano quali informazioni sopravvivono. L’augmentazione dovrebbe riflettere variazioni valide e preservare le etichette. Ottimizzare una loss adeguata al compito, gestire lo squilibrio mediante ponderazione o campionamento accurato, e selezionare checkpoint sui dati di validazione. Confrontare con una baseline semplice e abilitare l’ablazione di augmentazione, risoluzione e inizializzazione preaddestrata per capire da dove provengono i miglioramenti.
Segnalare precisione, richiamo, F1 per classe, confusione, accuratezza top‑k quando rilevante, calibrazione e prestazioni per condizione. Testare sfocatura, compressione, illuminazione, ritaglio, occlusione, dispositivo e input senza classe supportata. Le soglie di confidenza possono indirizzare i casi incerti a revisione; la probabilità softmax non garantisce confidenza, soprattutto sotto spostamento. Sfondi controfattuali e test di occlusione rivelano apprendimento di scorciatoie. Per usi legati alla sicurezza, valutare i guasti nel caso peggiore e le conseguenze di falsi positivi e falsi negativi.
Distribuzione e monitoraggio
Imballare decodifica, conversione colore, orientamento, normalizzazione, modello e mappa delle etichette insieme. Validare l’artefatto esportato o quantizzato sui dispositivi target e misurare latenza end‑to‑end, memoria, consumo energetico e throughput. Monitorare la qualità dell’immagine, le distribuzioni di input e output, la calibrazione, le etichette confermate e lo stato dei sensori. Ridurre e mettere in sicurezza la conservazione delle immagini, specialmente per volti, posizioni e spettatori. Fornire un fallback per input corrotti o fuori ambito e ripristinare versioni del modello. La classificazione risponde alla domanda a livello di immagine definita; non dovrebbe essere estesa a localizzazioni, identità o affermazioni di intento non supportate.
Esempio pratico: classificazione di materiali riciclabili
Una struttura fotografa gli oggetti su un nastro trasportatore e assegna classe di materiale, contaminazione e sconosciuto. Le immagini sono suddivise per giorno di raccolta e lotto di oggetti, coprendo illuminazione, superfici bagnate, piegature, sovrapposizioni e nastri vuoti. Un piccolo CNN e un modello preaddestrato sono confrontati con regole di colore e forma. Richiamo per classe, smistamento errato, calibrazione, throughput e risultati per fotocamera e condizione del materiale guidano la selezione.
La pipeline di produzione verifica l’esposizione della fotocamera e la sincronizzazione del nastro, quindi invia gli elementi incerti a un flusso generale invece di forzare una classe. L’inferenza quantizzata è validata sull’hardware specifico. Il monitoraggio traccia la qualità dell’input, i tassi di classe, i rifiuti e audit manuali campionati; nuovi imballaggi attivano un aggiornamento dei dati revisionato. Il modello controlla un separatore limitato con barriere fisiche, e un guasto del sensore o del modello riporta il meccanismo a uno stato sicuro anziché deviare silenziosamente il materiale.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti previsti, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ciascun guasto importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della sintonizzazione. Testare casi ordinari, condizioni di confine, input malformati o mancanti, spostamento della distribuzione, interruzione di dipendenze, uso improprio e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le prove da un prototipo attraente.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a tappe, mantenere un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità dell’input, il comportamento dell’output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allerta e un responsabile di risposta, quindi rivedere le prove reali dopo la distribuzione invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi cambiano. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui deve essere disattivato o sostituito.
Domande frequenti
Un classificatore di immagini può identificare più oggetti?
Un classificatore multietichetta può indicare quali categorie sono presenti, ma non localizza le singole istanze. È necessario il rilevamento di oggetti per ottenere riquadri o conteggi.
Perché un modello può fallire su foto che sembrano normali a una persona?
Potrebbe fare affidamento su artefatti di acquisizione, texture o correlazioni che sono cambiate. Piccole differenze di preprocessing e lo spostamento di dominio possono anche influire sulle caratteristiche apprese.
Riferimenti principali