
Fondamenti di IA
Che cos’è il KNN (K-Nearest Neighbors)?

 Aggiungi Unite.AI alle tue fonti preferite su Google
K-nearest neighbors (KNN) prevede un risultato a partire dagli esempi di addestramento etichettati più vicini a un punto di query. Per la classificazione, i vicini votano la classe. Per la regressione, i loro valori target vengono mediati o combinati in altro modo.
KNN è un metodo basato su istanze, non generalizzante: la fase di fitting si limita a memorizzare gli esempi di addestramento e, facoltativamente, un indice di ricerca. Ciò non elimina la necessità di suddividere i dati in set di addestramento, validazione e test. La valutazione su dati di tenuta è essenziale per scegliere k, la metrica di distanza, l’elaborazione delle caratteristiche e la regola di voto.
Punti chiave
- KNN prevede localmente; non suddivide prima il dataset in cluster.
- La normalizzazione delle caratteristiche è fondamentale perché la distanza determina quali esempi contano come vicini.
- Un k piccolo può essere rumoroso, mentre un k grande può smussare la struttura locale.
- Alte dimensioni, caratteristiche irrilevanti, squilibrio di classe e ricerca lenta possono limitare le prestazioni.
Come funziona la classificazione KNN
- Rappresentare la query e gli esempi di addestramento nello stesso spazio delle caratteristiche.
- Calcolare la distanza dalla query agli esempi di addestramento.
- Selezionare i k esempi più vicini.
- Predire la classe di maggioranza o utilizzare il voto ponderato per distanza.
Il voto ponderato attribuisce maggiore influenza ai vicini più prossimi. In caso di parità è necessario una regola documentata, e i vicini a pari distanza con etichette diverse possono far dipendere i risultati dall’ordine o da dettagli di implementazione.
Regressione KNN
Per la regressione, la previsione è comunemente la media dei target dei vicini. La ponderazione per distanza può ridurre l’influenza delle osservazioni più lontane. La mediana o un’aggregazione robusta possono essere utili quando i target locali contengono outlier.
Metriche di distanza
La distanza euclidea è comune per caratteristiche continue, la distanza di Manhattan somma le differenze assolute e la distanza coseno si concentra sulla direzione piuttosto che sulla magnitudine. Altre metriche si applicano a dati binari, categorici, geografici, sequenziali o di embedding appresi.
Definire KNN “non parametrico” significa che non assume una forma funzionale fissa a dimensione finita per il confine decisionale. Suppone comunque che la rappresentazione e la metrica scelte rendano i punti vicini rilevanti tra loro.
Perché la scalatura è importante
Se una caratteristica varia da 0 a 1 e un’altra da 0 a 100.000, la distanza euclidea ordinaria sarà dominata dalla seconda caratteristica. Standardizzazione, normalizzazione o trasformazioni specifiche del dominio devono essere adattate sulla partizione di addestramento e applicate a validazione, test e dati di produzione.
Le caratteristiche irrilevanti distorcono anche i vicinati. La selezione delle caratteristiche, la riduzione della dimensionalità o le rappresentazioni apprese possono aiutare, ma ogni scelta deve essere validata senza perdite di dati.
Scelta di k
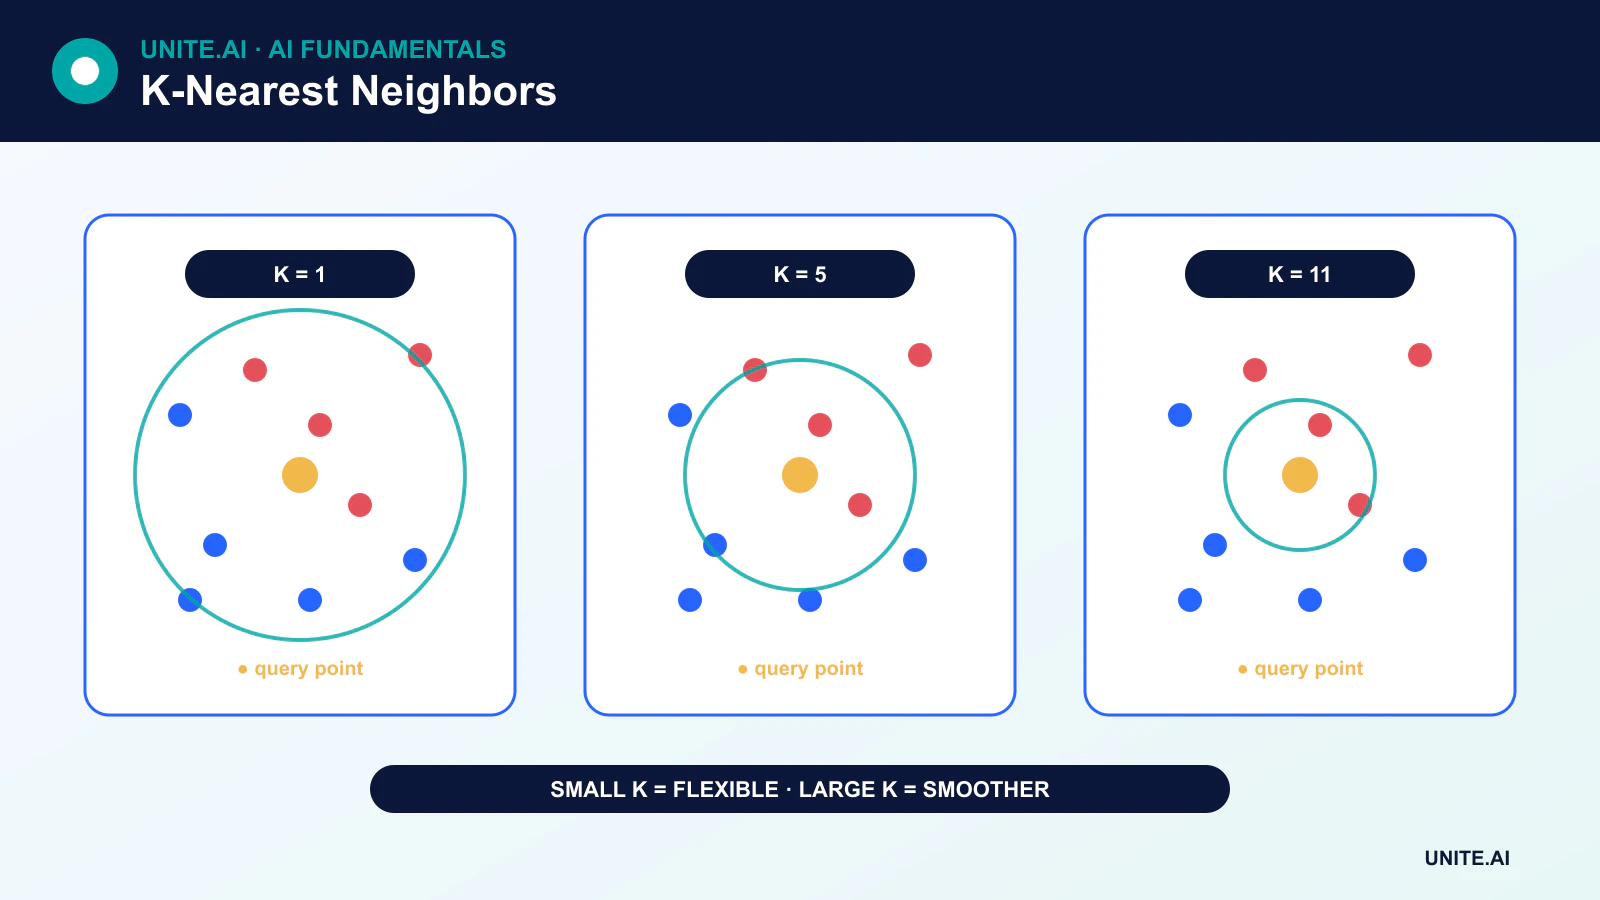
Con k = 1, il modello può seguire rumore ed esempi etichettati in modo errato. Man mano che k aumenta, le previsioni diventano più fluide e meno sensibili a un singolo punto. Se k diventa troppo grande, classi o regioni distanti dominano e il modello sottoadatta.
Scegli k mediante cross-validation sui dati di addestramento. Per la classificazione binaria, un k dispari riduce ma non elimina le parità. Pesi di classe, suddivisioni stratificate, scelta della soglia e metriche appropriate sono importanti quando le classi sono sbilanciate.
La maledizione della dimensionalità
In spazi ad alta dimensionalità, le distanze possono diventare meno informative perché gli esempi sono sparsi e le distanze più vicine e più lontane diventano relativamente simili. KNN può richiedere enormi quantità di dati per mantenere vicinati locali significativi. Questo è la maledizione della dimensionalità.
La riduzione della dimensionalità o embedding specifici per il compito possono aiutare, ma la geometria di un embedding dovrebbe essere validata per la nozione di similarità desiderata.
Prestazioni della ricerca
Una query brute-force confronta il nuovo punto con tutti gli esempi memorizzati. Gli alberi KD e gli alberi a palline accelerano alcune ricerche esatte, sebbene i loro vantaggi diminuiscano in alta dimensionalità. Gli indici di nearest-neighbor approssimati scambiano una piccola perdita di recall per grandi guadagni di velocità e memoria. Questa idea è alla base anche della ricerca di similarità vettoriale.
Punti di forza e limitazioni
KNN è semplice, supporta confini decisionali irregolari e fornisce una spiegazione intuitiva basata su esempi. Può anche richiedere una notevole quantità di memoria, esporre esempi di addestramento sensibili, prevedere lentamente e comportarsi male quando la distanza non è significativa. È una baseline utile — non un metodo altamente accurato nella maggior parte dei problemi per impostazione predefinita.
Distanza, vicinati e comportamento degli iperparametri
K-nearest neighbors memorizza gli esempi di addestramento e prevede a partire dai k più vicini secondo una distanza scelta. La classificazione utilizza un voto di maggioranza o ponderato per distanza; la regressione media i target dei vicini. La scalatura è essenziale perché una caratteristica ad alta gamma può dominare la distanza euclidea. Dati categorici, sparsi, sequenziali o geografici possono richiedere distanze Hamming, coseno, di edit, great-circle o apprese. La metrica è un’assunzione di modellazione sulla similarità e dovrebbe essere validata rispetto al significato reale dei casi vicini.
Un k piccolo crea confini flessibili, ad alta varianza e sensibili al rumore; un k grande smussa le previsioni e può cancellare strutture di minoranza. Un k dispari evita solo alcune parità binarie e non è una regola generale. Scegli k, distanza, ponderazione, insieme di caratteristiche e pre‑elaborazione all’interno della cross‑validation. Lo squilibrio di classe può far sì che il voto di maggioranza locale ignori risultati rari, quindi è necessario ispezionare il recall per classe e la composizione del vicinato. Le distanze ad alta dimensionalità tendono a concentrarsi, e le caratteristiche irrilevanti degradano i vicinati; la selezione, la riduzione della dimensionalità o gli embedding appresi possono aiutare.
Indicizzazione, incertezza e operatività in produzione
L’inferenza ingenua confronta una query con tutti i punti di addestramento. Gli alberi KD e gli alberi a palline aiutano in basse dimensioni adatte; gli indici di nearest‑neighbor approssimati scambiano l’esattezza per velocità e scalabilità. Misura il recall della ricerca dei vicini separatamente dalla qualità predittiva. La memoria comprende le caratteristiche memorizzate, le etichette e le strutture dell’indice. Gli aggiornamenti sono concettualmente semplici ma possono richiedere ricostruzioni dell’indice, coerenza di versione e propagazione delle cancellazioni. Proteggi gli esempi di addestramento sensibili perché il ritorno di vicini o distanze può esporre i record.
KNN può mostrare esempi che rendono una previsione comprensibile, ma la vicinanza non è causalità né equità. Fornisci distanza, margine di voto e una regola di astensione quando i vicinati sono scarsi o conflittuali. Monitora la distanza della query, le etichette dei vicini, il drift delle caratteristiche, la latenza e i risultati confermati. Mantieni sincronizzate le versioni di pre‑elaborazione e dell’indice, e testa i risultati esatti rispetto a quelli approssimati dopo le modifiche. KNN è una baseline locale efficace e un metodo di recupero quando la distanza è significativa; fatica quando la similarità non può essere rappresentata dalle caratteristiche disponibili.
Esempio pratico: KNN per la sostituzione di prodotti
Un rivenditore rappresenta i prodotti con attributi numerici standardizzati, compatibilità categorica e un embedding testuale appreso, poi definisce una distanza ponderata valutata dai merchandiser. K e i pesi sono selezionati usando lanci di prodotti successivi, non righe di articoli casuali. La valutazione verifica il recall di sostituti rilevanti, raccomandazioni incompatibili, distanza, copertura di categoria e risultati per articoli rari. Una baseline di popolarità mostra se la similarità locale aggiunge valore.
Un indice approssimato è confrontato con i vicini esatti per recall e latenza. Le query senza un articolo compatibile vicino non restituiscono suggerimenti, ma nessun vicino forzato. Cancellazioni di prodotti e correzioni di attributi si propagano all’indice tramite aggiornamenti versionati. Il monitoraggio traccia le distribuzioni delle distanze, i risultati vuoti, le sovrascritture e i risultati commerciali senza confondere le vendite con la reale compatibilità. I termini sensibili dei fornitori sono esclusi dalle spiegazioni, e gli esempi restituiti rimangono evidenza di similarità — non un’affermazione che i prodotti siano equivalenti.
Prove di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definisci gli utenti destinatari, l’ambiente operativo, gli input, gli output, le dipendenze, il responsabile e le conseguenze di ogni errore importante. Stabilisci una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testa casi ordinari, condizioni al contorno, input malformati o mancanti, spostamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misura la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registra ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere le evidenze da un prototipo attraente.
Prima del lancio, assegna l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Usa un rollout a fasi, mantieni un fallback sicuro e verifica il monitoraggio con fallimenti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento degli output, la versione del modello o della regola, lo stato delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definisci soglie di allarme e un responsabile di risposta, poi esamina le evidenze del mondo reale dopo il deployment invece di presumere che le prestazioni offline persistano. Rivaluta ogni volta che cambiano le fonti di dati, gli utenti, i modelli, i fornitori, le politiche, l’hardware o gli obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui debba essere disattivato o sostituito.
Domande frequenti
KNN ha una fase di addestramento?
Ha poco fitting di parametri, ma possiede comunque un processo di sviluppo: il preprocessing è appreso dai dati di addestramento, può essere costruito un indice, e k, la metrica, i pesi e le caratteristiche sono selezionati tramite validazione.
KNN è lo stesso di K-means?
No. KNN è principalmente un metodo supervisionato di previsione locale. K-means è un algoritmo di clustering non supervisionato in cui K è il numero di centri di cluster.
Riferimenti principali












