Fondamenti di IA
Che cos’è il clustering K-means?

 Aggiungi Unite.AI alle tue fonti preferite su Google
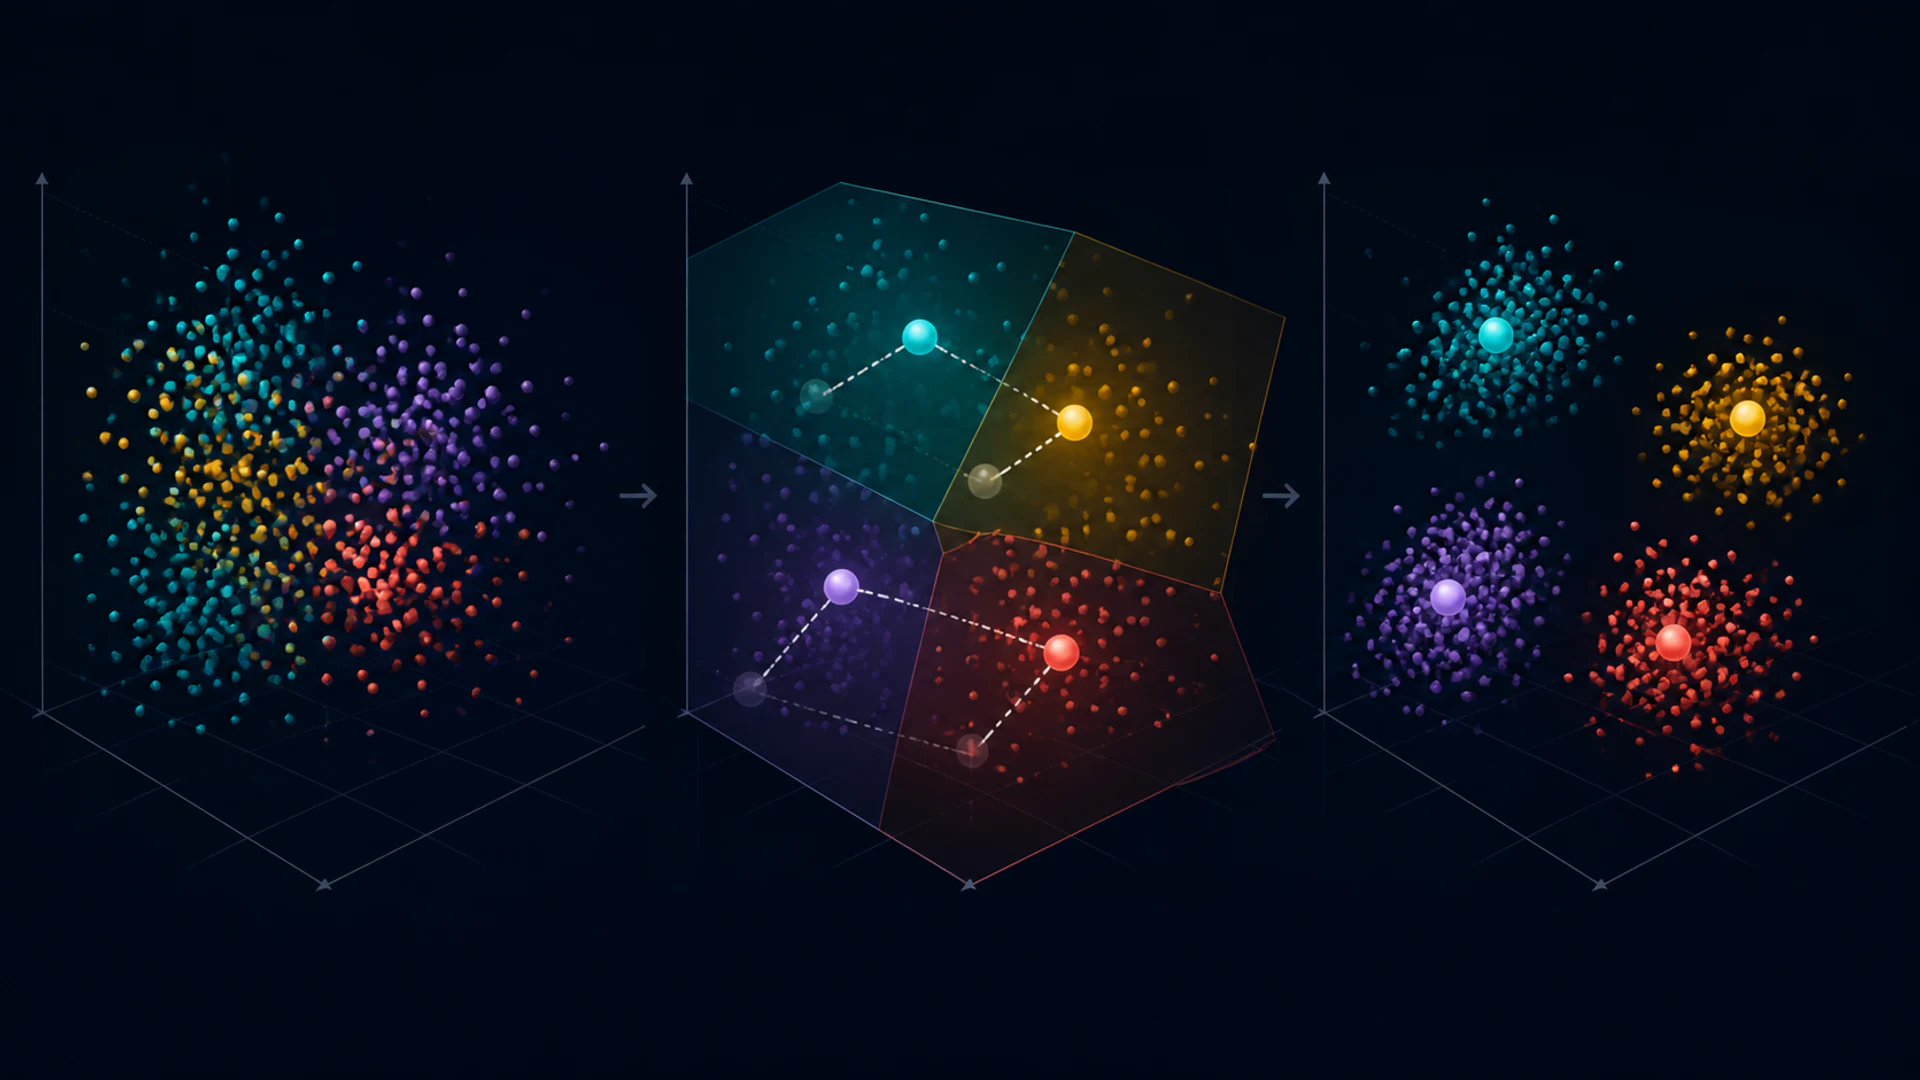
K-means è un algoritmo non supervisionato che partiziona osservazioni numeriche in k cluster. Alterna l’assegnazione di ogni punto al suo centroide più vicino e il ricalcolo di ogni centroide come media dei punti a esso assegnati.
L’algoritmo è veloce e utile, ma il risultato è influenzato da scaling, distanza, inizializzazione e dal valore di k. Un cluster è una partizione matematica, non automaticamente una categoria del mondo reale.
Punti chiave
- K-means minimizza la distanza euclidea quadratica entro il cluster rispetto ai centroidi.
- L’inizializzazione è importante; k-means++ distribuisce i centroidi iniziali e solitamente migliora i risultati.
- Standardizzare le caratteristiche quando le loro unità o scale devono contribuire in modo comparabile.
- K-means ha difficoltà con outlier, cluster non sferici, densità diseguali e dati categorici.
L’obiettivo e il ciclo di aggiornamento
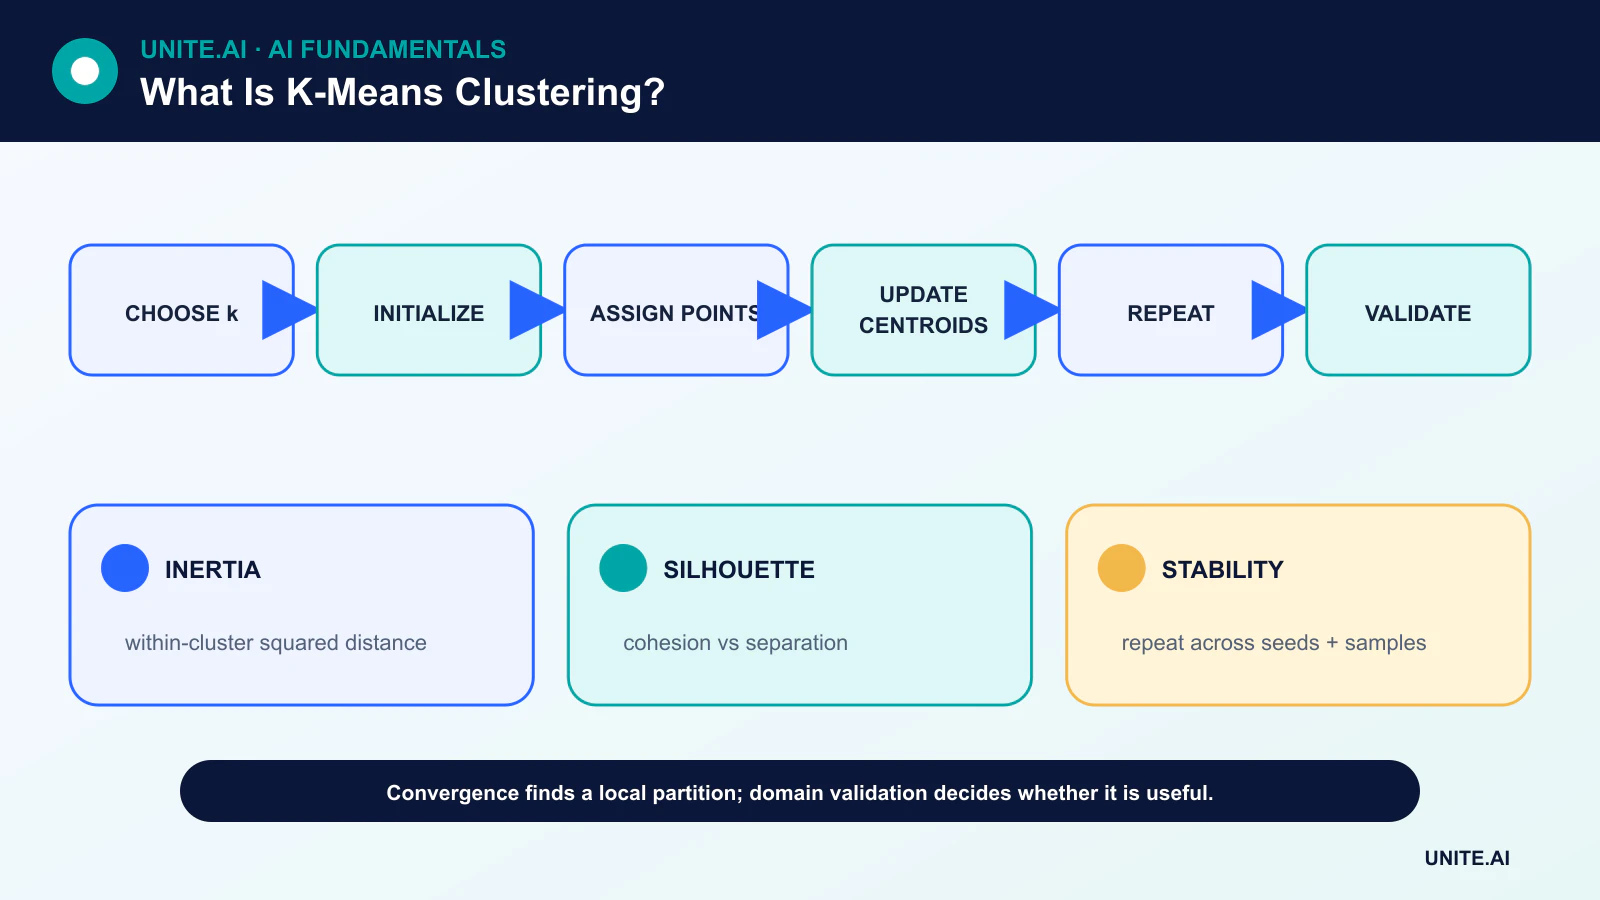
Dato k centroidi, la fase di assegnazione invia ogni osservazione a quello più vicino. La fase di aggiornamento sostituisce ciascun centroide con la media delle osservazioni a esso assegnate. La somma dei quadrati entro il cluster non può aumentare con questi passaggi, perciò il processo converge a un optimo locale.
La convergenza non garantisce l’optimo globale. Centroidi iniziali diversi possono portare a partizioni differenti, motivo per cui le implementazioni eseguono diverse inizializzazioni e conservano la soluzione con l’inertia più bassa.
Inizializzazione e k-means++
Selezionare casualmente tutti i centroidi iniziali da un’unica zona densa può produrre una soluzione scadente o una convergenza lenta. k-means++ sceglie i semi con una probabilità legata alla distanza dai semi già esistenti, favorendo una copertura più ampia del set di dati.
Eseguire più run rimane utile. Registrare il seme casuale e il numero di inizializzazioni affinché i risultati possano essere riprodotti.
Scalatura e distanza
La distanza euclidea quadratica rende K-means sensibile alle unità di misura. Una caratteristica misurata in migliaia può dominare un’altra misurata tra zero e uno. La standardizzazione è comune, ma la conoscenza del dominio dovrebbe decidere se una varianza standardizzata uguale riflette un’importanza uguale.
Gli outlier possono spostare la media molto lontano dai punti tipici. Una scalatura robusta, il trimming o metodi basati su medoid possono essere più adeguati. Le caratteristiche categoriche codificate one‑hot creano una geometria di distanza che potrebbe non corrispondere alla similarità tra categorie.
Scelta di k e validazione dei cluster
L’inertia diminuisce ogni volta che k aumenta, quindi non può essere usata da sola per selezionare k. L’heuristica del gomito cerca un miglioramento decrescente. L’analisi della silhouette confronta coesione e separazione. La stabilità su campioni e semi diversi aggiunge un ulteriore controllo.
La validazione più forte è l’utilità per il dominio previsto. Confrontare i cluster con risultati noti, revisione da parte di esperti o un compito a valle, senza fingere che le etichette post‑hoc siano state scoperte oggettivamente.
Limiti e alternative
K-means favorisce gruppi compatti, approssimativamente sferici e di scala simile. I modelli di miscele gaussiane rappresentano componenti ellissoidali probabilistici; i metodi in stile DBSCAN identificano regioni dense e rumore; il clustering gerarchico produce un albero di unioni.
La riduzione della dimensionalità può migliorare la velocità o denoisare gli input, ma adattarla sull’intero set di dati può modificare la questione di validazione. Mini‑batch K-means riduce il calcolo per grandi set di dati al costo di un aggiornamento approssimato.
Obiettivo, inizializzazione e convergenza
K-means partiziona osservazioni numeriche in k cluster minimizzando la distanza euclidea quadratica entro il cluster rispetto ai centroidi. L’algoritmo di Lloyd alterna l’assegnazione di ogni punto al centroide più vicino e il ricalcolo dei centroidi finché le assegnazioni o l’obiettivo non si stabilizzano. Converge a un optimo locale, non necessariamente il migliore globale. L’inizializzazione k-means++ distribuisce i centri iniziali e solitamente migliora i risultati, ma più semi rimangono importanti. Standardizzare le caratteristiche quando le unità devono contribuire in modo comparabile, poiché la distanza quadratica amplifica variabili di grande scala e outlier.
Il metodo presuppone cluster approssimativamente compatti, sferici e di scala simile sotto geometria euclidea. Ha difficoltà con manifold allungati, densità diseguale, dati categorici, outlier pesanti e strutture nidificate. Cluster vuoti e punti duplicati richiedono una gestione definita. Mini‑batch k-means scala a grandi quantità di dati con un compromesso di approssimazione. Per testi sparsi, il k‑means sferico orientato al coseno può meglio corrispondere alla direzione, mentre miscele, metodi di densità, clustering gerarchico o k‑medoids codificano altre assunzioni.
Scelta di k e validazione del significato
Le curve a gomito, i punteggi di silhouette, i criteri informativi nei modelli correlati e la stabilità possono informare la scelta di k, ma nessuno scopre un numero univocamente corretto. L’utilità per il business e l’interpretazione del dominio sono importanti. Rifare il fitting su campioni e semi diversi, confrontare lo spostamento dei centroidi e la coerenza delle assegnazioni, e validare i cluster su risultati indipendenti non usati per crearli. Una proiezione bidimensionale può distorcere la separazione, quindi esaminare le distanze e gli esempi nello spazio di rappresentazione originale o validato.
I cluster sono gruppi descrittivi creati dalle caratteristiche e dalla metrica selezionate; non sono categorie naturali né segmenti causali. Profili basati sulle stesse variabili usate per il clustering possono essere circolari. Utilizzare attributi di test e una revisione qualitativa, e verificare se i cluster riproducono principalmente geografia, fonte dei dati o tratti sensibili. I cluster piccoli possono essere anomalie o artefatti. Dare un nome a un cluster non fa sì che tutti i membri corrispondano all’etichetta.
Distribuzione e manutenzione
Memorizzare insieme scaling, ordine delle caratteristiche, centroidi, definizione della distanza e etichette dei cluster. Per nuovi punti, monitorare la distanza dal centroide assegnato e la frazione che supera di gran lunga il supporto di training; fornire uno stato ‘sconosciuto’ invece di forzare ogni caso in un cluster. Tracciare le dimensioni dei cluster, i centroidi e la rilevanza dei risultati nel tempo. Il riaddestramento modifica le identità dei cluster, quindi mappare o versionare le regole a valle invece di riutilizzare silenziosamente i vecchi nomi. K-means è una baseline utile per compressione e segmentazione quando la sua geometria corrisponde alla domanda, non un motore di scoperta universale.
Esempio pratico: segmentazione dei clienti con k-means
Un’azienda di abbonamenti standardizza le caratteristiche di utilizzo su una finestra fissa, rimuove gli identificatori di account e testa k su diversi semi. Vengono esaminate stabilità, silhouette e risultati di business su dati di test, ma i team di prodotto ispezionano anche account rappresentativi e di confine. Scoprono che un cluster è semplicemente costituito da nuovi clienti con osservazioni più brevi, quindi la durata è gestita esplicitamente. K-means è confrontato con alternative gerarchiche e basate sulla densità invece di essere considerato automaticamente appropriato. L’esercizio è trattato come apprendimento non supervisionato, non come scoperta di etichette.
I segmenti guidano ricerche e sperimentazioni di messaggistica, non l’ammissibilità o il prezzo. Nuovi account lontani da tutti i centroidi ricevono un’assegnazione ‘sconosciuta’. Scaling, caratteristiche, centroidi e nomi sono versionati, e il riaddestramento mappa i nuovi cluster a quelli vecchi solo con evidenza. Il monitoraggio traccia la dimensione del cluster, la distanza e la rilevanza dei risultati. Attributi sensibili e proxy sono auditati, e il team evita di descrivere i cluster come tipi di personalità naturali quando sono partizioni matematiche di comportamenti selezionati.
Evidenza di implementazione e prontezza operativa
Una decisione di produzione richiede più di una dimostrazione di successo. Definire gli utenti target, l’ambiente operativo, gli input, gli output, le dipendenze, il proprietario e le conseguenze di ogni fallimento importante. Stabilire una baseline riproducibile e un set di valutazione versionato prima della messa a punto. Testare casi ordinari, condizioni di confine, input malformati o mancanti, cambiamenti di distribuzione, interruzioni di dipendenze, usi impropri e i gruppi o ambienti più soggetti a carenze. Misurare la qualità del compito insieme a calibrazione o incertezza, latenza, throughput, costo delle risorse, accessibilità, privacy e sicurezza. Registrare ogni trasformazione e soglia affinché un revisore indipendente possa riprodurre il risultato e distinguere l’evidenza da un prototipo accattivante.
Prima del lancio, assegnare l’autorità per il rilascio, le eccezioni, le modifiche, il rollback e la dismissione. Utilizzare un rollout a fasi, conservare un fallback sicuro e verificare il monitoraggio con guasti iniettati deliberatamente. La telemetria operativa dovrebbe rivelare la qualità degli input, il comportamento dell’output, la versione del modello o della regola, lo stato di salute delle dipendenze, le override umane e i risultati confermati senza raccogliere dati sensibili non necessari. Definire soglie di allarme e un responsabile di risposta, quindi esaminare le evidenze reali dopo il deployment invece di presumere che le prestazioni offline persistano. Rivalutare ogni volta che cambiano fonti di dati, utenti, modelli, fornitori, politiche, hardware o obiettivi. Un sistema mantenuto necessita anche di procedure documentate di recupero, apprendimento dagli incidenti, cancellazione e conservazione, e di un punto chiaro in cui deve essere disattivato o sostituito.
Domande frequenti
K-means è supervisionato o non supervisionato?
È non supervisionato perché riceve solo le caratteristiche e un numero scelto di cluster, senza etichette target.
K-means classifica nuovi dati?
Dopo l’addestramento, un nuovo punto può essere assegnato al suo centroide più vicino. Si tratta di un’assegnazione a un cluster, non necessariamente di una previsione di classe supervisionata.
Riferimenti principali