
Fondamenti di IA
Cos’è l’Interpretabilità Meccanistica? Come i Ricercatori Analizzano i Modelli di IA

 Aggiungi Unite.AI alle tue fonti preferite su Google
L’interpretabilità meccanistica studia come i componenti appresi all’interno di una rete neurale producono causalmente il comportamento. Invece di limitarsi a correlare input e output, i ricercatori formulano ipotesi su caratteristiche, teste di attenzione, neuroni e circuiti, per poi intervenire e testare tali ipotesi.
Il campo ha prodotto spiegazioni dettagliate per comportamenti selezionati in modelli piccoli e medi, ma una descrizione completa e fedele di un modello di frontiera rimane fuori portata. Spiegazioni automatizzate e visualizzazioni accattivanti possono essere punti di partenza utili, non prove.
Punti chiave
- Le caratteristiche sono schemi rappresentati; i circuiti sono componenti interagenti proposti per implementare un calcolo.
- Il patching di attivazione, l’ablazione e il tracciamento causale verificano se un componente modifica un comportamento.
- La sovrapposizione significa che un neurone può partecipare a molte caratteristiche; gli autoencoder sparsi tentano una base di caratteristiche diversa.
- I metodi di interpretabilità necessitano di verità di base, test falsificabili, copertura e valutazione rispetto a spiegazioni alternative.
Dalla rappresentazione al meccanismo
Il probing indaga se le informazioni possono essere decodificate da un’attivazione. L’attribuzione stima quali input o componenti sono rilevanti. Il lavoro meccanistico va oltre proponendo un calcolo interno e verificando se gli interventi modificano il comportamento intermedio e finale previsto.
Ciò lo rende correlato ma più ristretto rispetto a explainable AI. Una spiegazione post‑hoc per una singola decisione non è necessariamente un algoritmo reverse‑engineered all’interno del modello.
Circuiti e interventi causali
I ricercatori possono identificare una testa di attenzione o una caratteristica associata a un compito, ablatarla, patchare le attivazioni da un’altra esecuzione o tracciare come l’informazione si sposta tra i layer. Un’ipotesi valida prevede il comportamento su nuovi esempi e resiste ai controlli.
Gli interventi possono creare stati fuori distribuzione, quindi un cambiamento comportamentale non rivela automaticamente il calcolo naturale. Utilizzare più metodi, controlli corrispondenti e effetti quantitativi anziché un unico prompt illustrativo.
Sovrapposizione e caratteristiche sparse
Le reti neurali possono rappresentare più caratteristiche rispetto alle singole dimensioni sovrapponendole. Un neurone può quindi attivarsi per diversi schemi non correlati, rendendo fuorvianti le etichette a livello di neurone.
Gli autoencoder sparsi apprendono un dizionario più ampio di caratteristiche dalle attivazioni del modello. Possono rendere i pattern più separabili, ma la sparsità scelta, i dati di addestramento, l’errore di ricostruzione e le etichette automatiche influenzano ciò che viene recuperato. Le caratteristiche Neural-network richiedono comunque una validazione causale.
Sicurezza, debugging e limitazioni
Gli strumenti meccanistici possono aiutare a individuare fatti memorizzati, bias, strategie ingannevoli o circuiti di fallimento e possono supportare modifiche o monitoraggio. Gli stessi strumenti possono non rilevare calcoli distribuiti, rari o dipendenti dal contesto.
Considera i risultati come evidenza circoscritta: versione del modello, compito, dataset, layer, intervento, effetto e incertezza. Collega l’interpretazione alle valutazioni comportamentali, al red‑team e alla governance responsible-AI anziché usarla come certificato di sicurezza universale.
Rappresentazioni, circuiti e evidenza causale
L’interpretabilità meccanistica studia come i calcoli interni producono il comportamento del modello. I ricercatori ispezionano attivazioni, pesi, attenzione e caratteristiche intermedie, per poi formulare ipotesi su rappresentazioni e circuiti. Una rappresentazione non è necessariamente immagazzinata in un singolo neurone; può essere distribuita su direzioni, layer, token e combinazioni dipendenti dal contesto.
Gli autoencoder sparsi tentano di decomporre le attivazioni dense in un insieme più ampio di caratteristiche che si attivano in modo selettivo. Le etichette delle caratteristiche sono interpretazioni umane di esempi osservati, non verità di base. L’errore di ricostruzione, la sparsità, la divisione delle caratteristiche, l’assorbimento e le caratteristiche morte influenzano ciò che la decomposizione rivela e ciò che omette.
La correlazione è insufficiente per un’affermazione meccanistica. Il patching di attivazione, l’ablazione, il tracciamento causale, lo steering e gli interventi mirati sui pesi testano se un componente modifica il comportamento come previsto. Gli interventi possono anche creare stati fuori distribuzione, quindi i risultati necessitano di controlli, analisi dose‑risposta, spiegazioni alternative e replica su diversi prompt e modelli.
Un flusso di lavoro rigoroso per l’interpretabilità
Inizia con un comportamento misurato con precisione e un dataset che separa le ipotesi concorrenti. Localizza i layer, le posizioni, i componenti o le caratteristiche rilevanti; ispeziona i meccanismi candidati; intervieni; e verifica se il circuito proposto predice nuovi casi. Mantieni gli esempi esplorativi separati dalla valutazione confermatoria per ridurre il bias di selezione.
Gli strumenti automatizzati possono classificare neuroni, caratteristiche, teste o percorsi, mentre i modelli linguistici possono proporre descrizioni. L’automazione aumenta la copertura ma può generare storie plausibili. Valuta le spiegazioni su esempi di attivazione tenuti da parte e previsioni causali, registra l’incertezza e rendi gli artefatti riproducibili con versione del modello, tokenizzatore, prompt e codice.
I meccanismi possono essere polisemantici, ridondanti, non lineari e distribuiti. Rimuovere un componente può essere compensato da altri, mentre una caratteristica può partecipare a diversi comportamenti. I risultati negativi sono informativi: un circuito apparente che fallisce al di fuori degli esempi curati dovrebbe essere limitato o scartato anziché salvato con una spiegazione sempre più vaga.
Applicazioni, limitazioni e affermazioni di sicurezza
L’interpretabilità può aiutare a debugare allucinazioni, bias, memorizzazione, comportamenti di jailbreak o generalizzazioni inattese; confrontare modelli; e generare ipotesi scientifiche. Può anche identificare caratteristiche per il monitoraggio o l’intervento. Questi usi richiedono una validazione specifica per il compito perché una visualizzazione di ricerca utile non è automaticamente un controllo di produzione affidabile.
L’assenza di una caratteristica rilevata non prova l’assenza di una capacità o intenzione, e una caratteristica leggibile non dimostra che il modello la utilizzi in una risposta specifica. Gli strumenti osservano una proiezione del calcolo con copertura limitata. Le affermazioni di sicurezza devono specificare sensibilità di rilevamento, falsi positivi, distribuzione, avversario e punti ciechi noti.
Utilizza l’interpretabilità insieme a valutazioni comportamentali, red‑team, governance dei dati, controlli di accesso, monitoraggio e risposta agli incidenti. Pubblica metodi e contro‑esempi quando possibile. Il campo sta progredendo rapidamente, ma le tecniche attuali non forniscono una spiegazione completa e fedele del ragionamento dei modelli di frontiera né una garanzia generale di allineamento.
Esempio pratico: testare un circuito proposto del modello
Supponiamo che un modello sembri utilizzare un insieme di teste di attenzione e caratteristiche per risolvere un oggetto indiretto in una frase. I ricercatori definiscono un dataset controllato con nomi, posizioni, distrattori e controesempi vari, quindi misurano il comportamento. L’ispezione delle attivazioni identifica componenti candidati, ma l’ipotesi è scritta prima dell’intervento: quale informazione ogni componente trasporta, dove si sposta e come la sua modifica dovrebbe alterare l’output.
Il patching di attivazione e l’ablazione testano necessità e sufficienza su esempi tenuti da parte. Una modifica mirata che cambia il token previsto nella direzione attesa supporta il meccanismo; un danno generale alle prestazioni no. I controlli patchano posizioni e componenti non correlate, variano l’entità dell’intervento e confrontano circuiti alternativi. Il team pubblica casi negativi in cui la spiegazione fallisce ed evita di attribuire uno scopo leggibile all’uomo basandosi solo sulla correlazione.
Per affermare un’applicazione di sicurezza, il metodo deve rilevare il comportamento rilevante con sensibilità nota sotto prompt realistici e adattamento avversario. I monitor di caratteristiche sono valutati per falsi positivi, evasione, aggiornamenti del modello e rilevanza causale. Le evidenze di interpretabilità possono guidare il debug e ulteriori test, ma l’applicazione rimane nei controlli esterni e nel monitoraggio comportamentale. Un diagramma di circuito convincente è un’ipotesi scientifica con evidenze — non una spiegazione completa di un modello né una garanzia sul comportamento non osservato.
Checklist di implementazione pratica
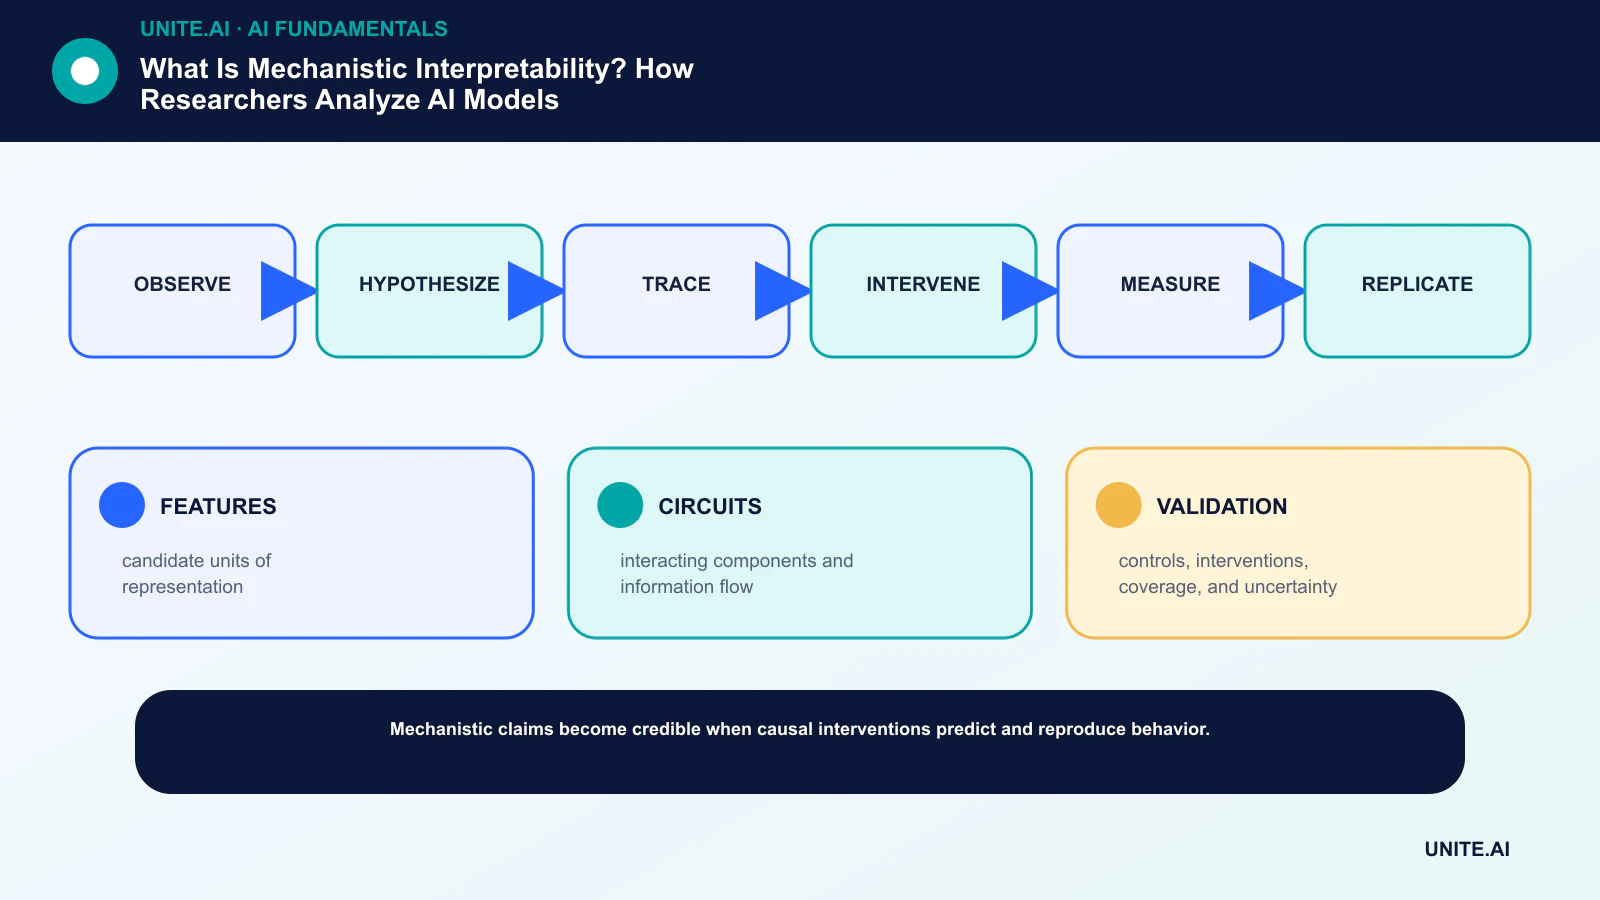
Trasforma il concetto in un flusso di lavoro limitato e verificabile: osserva → ipotizza → traccia → intervieni → misura → replica. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare lo scopo. Registra versioni e assunzioni affinché un altro team possa riprodurre il risultato e comprendere cosa è cambiato.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, gestiscono, mettono in sicurezza e sono interessate dal sistema. Testa casi normali, condizioni limite, fallimenti di dipendenze e usi impropri; conserva le evidenze e i rischi non risolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesamina la decisione quando arrivano dati reali, perché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- CARATTERISTICHE: unità candidate di rappresentazione.
- CIRCUITI: componenti interagenti e flusso di informazione.
- VALIDAZIONE: controlli, interventi, copertura e incertezza.
Domande frequenti
L’interpretabilità meccanistica è la stessa cosa della lettura dei pesi del modello?
No. I pesi grezzi non sono auto‑esplicativi. I ricercatori analizzano attivazioni, caratteristiche, componenti e interventi per costruire e testare ipotesi causali.
Gli autoencoder sparsi possono spiegare completamente un LLM?
No. Offrono una base di caratteristiche candidate e possono supportare l’analisi dei circuiti, ma la copertura, la fedeltà, la ricostruzione, l’etichettatura e la scalabilità rimangono problemi aperti.
Riferimenti principali












