Fondamenti di IA
Cos’è un NPU? Le unità di elaborazione neurale spiegate

 Aggiungi Unite.AI alle tue fonti preferite su Google
Un’unità di elaborazione neurale (NPU) è un acceleratore specializzato progettato per eseguire in modo efficiente le operazioni comuni delle reti neurali. Su telefoni, PC, veicoli, fotocamere e sistemi embedded, può eseguire carichi di lavoro AI supportati consumando meno energia o liberando CPU e GPU per altri compiti.
NPU è un termine ampio del settore piuttosto che un’architettura universale. Le prestazioni dipendono dagli operatori supportati, dai formati numerici, dalla memoria, dal compilatore e dal runtime, dai limiti termici e da quanto di un’applicazione può rimanere sull’acceleratore.
Riepilogo dei punti chiave
- Le NPU enfatizzano operazioni su matrici, vettori e tensori con elevato riutilizzo dei dati e basso consumo energetico.
- Il valore di picco TOPS non è un benchmark end‑to‑end dell’applicazione e può assumere una precisione o una sparsità specifiche.
- Un modello potrebbe richiedere conversione, quantizzazione, partizionamento del grafo e ricorso a fallback per operazioni non supportate.
- Confronta latenza, throughput, consumo energetico, memoria, qualità, privacy e portabilità sul carico di lavoro reale.
Ruoli di CPU, GPU e NPU
Le CPU eccellono nel controllo di flusso generale e nella ampia compatibilità. Le GPU offrono throughput parallelo programmabile e un vasto ecosistema software. Le NPU sono specializzate in operazioni tensoriali ripetute e possono includere memoria locale, array di moltiplicazione‑accumulazione e flusso di dati ottimizzato per l’inferenza.
I sistemi eterogenei programmano le diverse parti dove si adattano meglio. Questo è importante per edge AI, dove potenza sostenuta e reattività possono essere più rilevanti del picco di throughput dei data center.
Compilazione ed esecuzione del modello
Un grafo di framework viene convertito in una rappresentazione intermedia, ottimizzato, quantizzato dove opportuno e compilato per gli operatori supportati. Il runtime può partizionare il grafo in modo che i layer non supportati vengano eseguiti su CPU o GPU.
I trasferimenti tra processori possono annullare i vantaggi dell’acceleratore. Forme statiche, layout, precisione, batch e riutilizzo della memoria influenzano le prestazioni. Verifica l’artefatto compilato perché la qualità del modello deep‑learning può cambiare dopo la conversione.
Comprendere i TOPS e le affermazioni di efficienza
I TOPS indicano trilioni di operazioni al secondo sotto ipotesi definite. I fornitori possono contare moltiplicazioni e addizioni separatamente, utilizzare precisione intera a pochi bit o assumere sparsità. Un valore più alto non garantisce una latenza inferiore per un modello specifico.
Misura l’avvio a freddo e a caldo, la latenza per query, il throughput, il consumo energetico, la memoria di picco, il throttling termico, le dimensioni di contesto o immagine supportate e la frazione del grafo accelerata. Usa accuratezza e versioni software equivalenti.
Compromessi dell’AI sul dispositivo
L’esecuzione locale può ridurre la dipendenza dalla rete e mantenere gli input grezzi sul dispositivo, ma i modelli scaricati, i log, i backup e i fallback cloud generano comunque flussi di dati. La consegna sicura dei modelli e gli aggiornamenti della piattaforma rimangono necessari.
Le NPU possono supportare applicazioni di visione, audio, linguaggio e sensori, inclusi carichi di lavoro correlati a TinyML. Gli sviluppatori dovrebbero progettare fallback eleganti e comunicare quando l’elaborazione esce dal dispositivo.
Architettura NPU e operazioni supportate
Una NPU accelera le operazioni tensoriali utilizzando array di unità moltiplica‑accumula, memoria locale, pianificazione del flusso di dati e formati numerici specializzati. Mantenere pesi e attivazioni vicino al calcolo riduce gli spostamenti di dati costosi. I dispositivi reali differiscono per supporto degli operatori, gerarchia della memoria, precisione, sparsità, programmabilità e modalità di condivisione del lavoro con CPU e GPU.
Le prestazioni di picco sono spesso pubblicizzate in TOPS, ma i TOPS non specificano precisione, utilizzo, limiti di memoria, copertura degli operatori o latenza end‑to‑end. Due processori con lo stesso numero di testa possono comportarsi diversamente sullo stesso modello. Esegui benchmark del modello compilato, con batch e sequenze realistiche, pre‑elaborazione, trasferimenti e modalità di alimentazione.
Le NPU sono efficaci per carichi di lavoro neurali supportati come visione, riconoscimento vocale, denoising, effetti di sfondo e modelli linguistici compatti. Gli operatori non supportati possono ricadere su CPU o GPU, creando trasferimenti e latenza imprevedibile. Ispeziona i report del compilatore e le tracce di runtime per confermare il posizionamento anziché presumere che l’intero grafo utilizzi l’acceleratore.
Conversione, quantizzazione e distribuzione del modello
Il deployment di solito passa da un framework di addestramento attraverso l’esportazione, l’ottimizzazione del grafo, la quantizzazione, la compilazione del fornitore e l’integrazione del runtime. Forme statiche e operatori comuni sono i più facili da accelerare. Flussi di controllo dinamici, kernel personalizzati, grandi tensori intermedi e pattern di normalizzazione o attenzione non supportati possono richiedere modifiche al grafo o esecuzione ibrida.
I formati interi e a precisione ridotta riducono la dimensione del modello, la larghezza di banda, l’energia e la latenza, ma i dati di calibrazione devono rappresentare input reali. Confronta la quantizzazione post‑training con la quantizzazione consapevole durante l’addestramento quando la qualità è sensibile. Valuta il comportamento per classe e nei casi peggiori, poiché l’accuratezza media può nascondere degradazioni in casi rari o critici per la sicurezza.
L’inferenza sul dispositivo migliora latenza, operatività offline e privacy limitando il trasferimento dei dati, ma il dispositivo necessita comunque di modelli sicuri, accesso ai dati consapevole dei permessi e meccanismi di aggiornamento. Proteggi i file modello dove opportuno, firma gli aggiornamenti, divulga i fallback cloud e assicurati che la telemetria non reintroduca l’esposizione alla privacy che l’architettura locale intendeva ridurre.
Valutazione delle prestazioni e compromessi a livello di sistema
Misura la latenza all’avvio a freddo e a regime stabile, il throughput, l’energia per inferenza, la memoria, il comportamento termico, l’accuratezza e l’impatto sulla batteria. Test lunghi rivelano throttling che i benchmark brevi non catturano. Includi pre‑elaborazione e post‑elaborazione perché il ridimensionamento, la tokenizzazione, la decodifica o le copie di dati possono dominare un acceleratore altrimenti veloce.
La pianificazione è un problema di sistema. La CPU gestisce la logica dell’applicazione, la GPU può renderizzare o eseguire layer non supportati, e la NPU esegue grafi compatibili. Carichi di lavoro concorrenti di fotocamera, audio, display e AI competono per la larghezza di banda della memoria e l’alimentazione. Testa lo scenario utente completo anziché un modello isolato in uno strumento del fornitore.
La portabilità rimane limitata tra compilatori e runtime. Preferisci rappresentazioni di modello standard dove funzionano, isola il codice specifico del fornitore dietro interfacce, conserva gli output di riferimento e mantieni la copertura di test del dispositivo. Scegli l’hardware basandoti su carichi di lavoro convalidati, supporto software, orizzonte di aggiornamento e costo totale del sistema, non su una singola specifica dell’acceleratore.
Esempio pratico: distribuzione di un modello di visione su un laptop con NPU
Un team addestra un modello di segmentazione per effetti di sfondo, lo esporta in un formato di scambio supportato, sostituisce gli operatori non supportati e calibra la quantizzazione intera con telecamere, illuminazione, tonalità della pelle, abbigliamento e sfondi rappresentativi. Il compilatore del fornitore segnala quali nodi vengono eseguiti sulla NPU e quali ricadono in fallback. Il team considera ogni transizione di fallback come un costo di sistema, poiché i trasferimenti di tensori possono dominare un kernel individuale veloce.
Il benchmark misura la pre‑elaborazione della fotocamera, l’esecuzione del modello, il compositing, la memoria, l’avvio a freddo, la latenza a regime stabile, la stabilità dei fotogrammi, il consumo energetico e il throttling termico durante una videochiamata reale. I risultati sono confrontati con i percorsi CPU e GPU a pari qualità di output. L’applicazione utilizza il rilevamento delle capacità e un fallback testato invece di presumere che l’acceleratore esista o supporti lo stesso grafo dopo un aggiornamento del driver.
I test di rilascio coprono i modelli di dispositivo, le versioni del sistema operativo e dei driver, i carichi di lavoro concorrenti, le modalità batteria e gli input malformati. I pacchetti modello sono firmati e versionati; la telemetria registra prestazioni e fallimenti senza raccogliere video non necessari. Il prodotto spiega quando l’elaborazione rimane sul dispositivo e quando vengono utilizzate funzionalità cloud. La NPU guadagna il suo posto migliorando l’esperienza completa sotto vincoli realistici, non ottenendo un benchmark isolato di TOPS o kernel.
Checklist pratica per l’implementazione
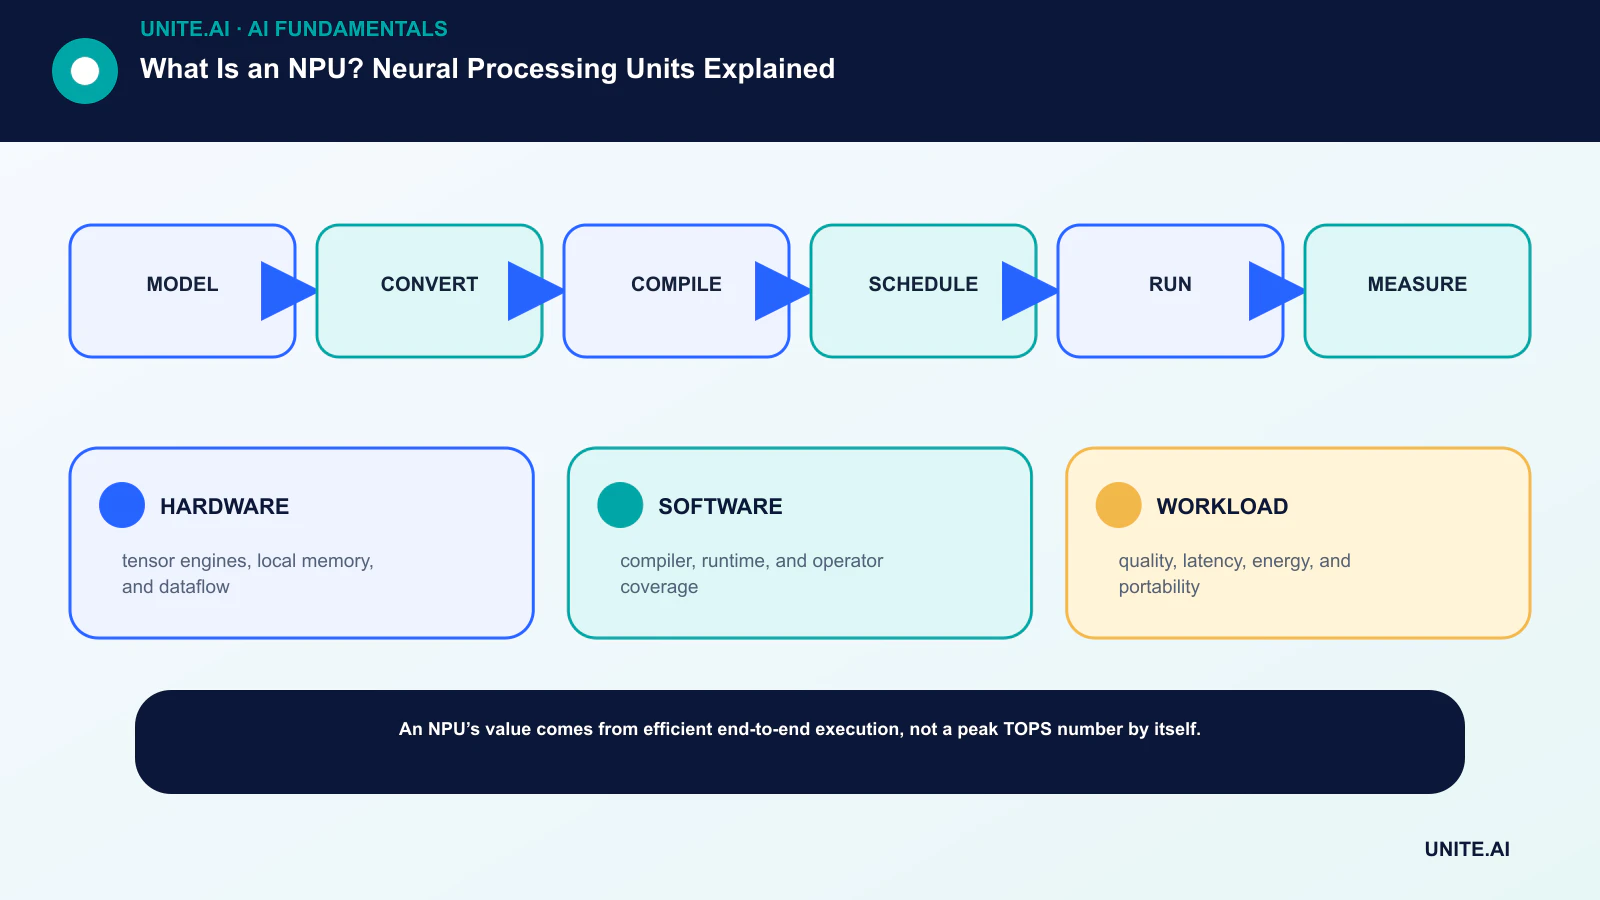
Trasforma il concetto in un flusso di lavoro limitato e verificabile: modello → conversione → compilazione → pianificazione → esecuzione → misurazione. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa i fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare lo scopo. Registra versioni e ipotesi affinché un altro team possa riprodurre il risultato e capire cosa è cambiato.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, gestiscono, mettono in sicurezza e sono interessate dal sistema. Testa casi normali, condizioni di confine, fallimenti di dipendenze e usi impropri; conserva le prove e i rischi non risolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesamina la decisione quando arrivano dati reali, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- HARDWARE: motori tensoriali, memoria locale e flusso di dati.
- SOFTWARE: compilatore, runtime e copertura degli operatori.
- WORKLOAD: qualità, latenza, energia e portabilità.
Domande frequenti
Una NPU è più veloce di una GPU?
Dipende dal modello, dalla precisione, dal supporto degli operatori, dalla dimensione del batch, dal limite di potenza e dal software. Una NPU può essere più efficiente per un carico di lavoro supportato sul dispositivo, mentre una GPU è più veloce o più flessibile altrove.
Una NPU mantiene tutti i dati AI privati?
No. Consente l’elaborazione locale, ma l’applicazione può comunque inviare dati o output a servizi cloud. La privacy dipende dall’architettura completa e dalla politica.
Riferimenti primari