
Fondamenti di IA
Che cos’è TinyML? Machine Learning su microcontrollori

 Aggiungi Unite.AI alle tue fonti preferite su Google
TinyML porta l’inferenza di machine learning su dispositivi altamente limitati come microcontrollori, piccoli processori di segnale digitale e sensori a basso consumo. Questi sistemi possono avere kilobyte o megabyte di memoria, budget energetici rigidi, nessuna connessione di rete continua e scadenze in tempo reale.
Il valore non consiste semplicemente in un modello più piccolo. L’elaborazione vicino al sensore può ridurre latenza, larghezza di banda ed esposizione dei dati grezzi, consentendo prodotti che funzionano per lunghi periodi con batterie o energia recuperata.
Punti chiave
- TinyML è definito dal budget complessivo hardware‑software, non da una soglia di dimensione del modello.
- Quantizzazione, architetture compatte, kernel ottimizzati e un attento buffering rendono possibile il deployment.
- L’inferenza sul dispositivo può migliorare la privacy, ma gli aggiornamenti sicuri e la governance dei dati rimangono importanti.
- Valutare l’accuratezza insieme a latenza, memoria di picco, energia, ciclo di lavoro e robustezza.
Lo stack TinyML
Un sensore acquisisce audio, movimento, vibrazione, immagini o un altro segnale. Il firmware lo preelabora in feature o tensori; un modello compatto viene eseguito tramite un runtime incorporato; la logica dell’applicazione decide se svegliare un sistema più grande o agire localmente.
Si tratta di una forma limitata di edge AI. L’hardware può includere un MCU, memoria, interfacce sensore e talvolta un acceleratore neurale. Ogni buffer, operatore e copia competono per risorse limitate.
Adattare il modello
La quantizzazione sostituisce i valori ad alta precisione con rappresentazioni intere più piccole. Potatura, distillazione, ingegneria delle feature e ricerca di architetture possono ridurre il calcolo o lo spazio di archiviazione. Il supporto degli operatori nel runtime di destinazione limita i modelli praticabili.
L’addestramento avviene spesso su hardware più potente, quindi il modello viene convertito e compilato per il dispositivo. Il transfer learning può ridurre le necessità di dati, ma l’artefatto finale deve essere valutato dopo la conversione perché le variazioni numeriche possono modificare l’accuratezza.
Dati e cambiamento ambientale
Le registrazioni di laboratorio raramente rappresentano ogni microfono, posizione di montaggio, temperatura, modello di vibrazione, accento o condizione di fondo. Raccogliere dati da dispositivi ed ambienti rappresentativi, mantenere indipendenti le fonti di addestramento e test, e includere casi ‘none of the above’.
Un falso trigger può sprecare energia o infastidire l’utente; un’anomalia non rilevata può essere costosa. Seleziona le soglie usando i costi reali degli errori e monitora le prestazioni sul campo tramite riepiloghi che preservano la privacy o diagnostica campionata, ove opportuno.
Misurare l’intero dispositivo
Il conteggio delle operazioni del modello non equivale alle prestazioni del prodotto. Riporta frequenza di risveglio, tempo di preelaborazione, latenza dell’inferenza, RAM di picco, utilizzo della flash, potenza media e di picco, comportamento termico e impatto sulla batteria sotto un ciclo di lavoro esplicito.
Pianifica firmware e aggiornamenti del modello firmati, rollback, identità del dispositivo e risposta alle vulnerabilità. I dispositivi Tiny possono rimanere in uso per anni, quindi la manutenibilità è parte della qualità del modello. I controlli di cybersecurity non possono essere rimandati perché il dispositivo è piccolo.
Budget di memoria e calcolo
La flash memorizza firmware, pesi del modello e costanti; la RAM contiene buffer dei sensori, attivazioni intermedie e lo stato del runtime. La memoria di attivazione di picco può superare la dimensione dei pesi, specialmente nei primi strati convoluzionali. I pianificatori di memoria riutilizzano buffer i cui cicli di vita non si sovrappongono, mentre le feature in streaming evitano di memorizzare un’intera finestra del segnale.
Il conteggio delle operazioni è una stima iniziale, ma l’efficienza del kernel dipende dalla forma del tensore, allineamento, supporto delle istruzioni e accesso alla memoria. Una convoluzione depthwise può ridurre l’aritmetica ma funzionare male su hardware senza kernel ottimizzato. Esegui benchmark del modello compilato sulla scheda di destinazione, non solo su un profiler desktop.
Il ciclo di lavoro domina molti prodotti. Il sensore e il MCU possono dormire, svegliarsi per un trigger economico, eseguire un piccolo modello e attivare una radio o un processore più grande solo quando necessario. Misura l’intero ciclo di lavoro, includendo sensore, conversione, preelaborazione, risveglio, inferenza, comunicazione e perdita in idle.
Sviluppo e conversione del modello
Inizia con i vincoli di deployment e raccogli dati sensoriali rappresentativi. La preelaborazione usata durante l’addestramento deve corrispondere esattamente all’implementazione fixed‑point o embedded. Differenze in frequenza di campionamento, finestratura, conversione del colore, normalizzazione o estrazione delle feature possono far fallire un modello anche quando la conversione ha successo.
La quantizzazione post‑training calibra gli intervalli da campioni rappresentativi; l’addestramento consapevole della quantizzazione simula precisioni inferiori durante l’apprendimento. Le scale dei pesi per canale spesso preservano meglio la qualità convoluzionale rispetto a una singola scala. Operazioni non supportate possono essere riscritte, approssimate o spostate a un fallback più lento, richiedendo una nuova valutazione.
La compressione dovrebbe essere guidata da ipotesi. Potare pesi non strutturati potrebbe non velocizzare un kernel embedded denso; la rimozione strutturata di canali è più facile da sfruttare per l’hardware. La distillazione trasferisce il comportamento da un teacher più grande ma può trasferire anche i suoi bias e errori. Confronta con baseline di elaborazione del segnale e soglie.
Applicazioni, test sul campo e manutenzione
Le attività comuni di TinyML includono il riconoscimento di parole chiave, il rilevamento di wake‑word, il riconoscimento di gesti, il rilevamento di anomalie di vibrazione, l’occupazione, eventi acustici e visione semplice. Il modello può fungere da filtro anziché da decisione finale, conservando la larghezza di banda mentre invia casi incerti o importanti a un sistema più capace.
I test sul campo dovrebbero coprire le tolleranze del dispositivo, l’invecchiamento dei sensori, il montaggio, lo stato della batteria, temperatura, condizioni atmosferiche, utenti e interferenze di fondo. Registra falsi trigger per ora o eventi mancati per ciclo operativo, non solo l’accuratezza bilanciata del test. Una soglia scelta in laboratorio potrebbe richiedere una calibrazione specifica per il prodotto.
Pianifica aggiornamenti over‑the‑air firmati, rollback, telemetria della versione del modello e lunghi periodi di supporto. Se gli aggiornamenti sono impossibili, usa modelli conservativi e documenta la deriva ambientale prevista. La dismissione deve revocare le credenziali del dispositivo e gestire i dati memorizzati, non semplicemente interrompere la vendita del prodotto.
Esempio pratico: un monitor di vibrazioni TinyML
Un piccolo accelerometro su un motore campiona le vibrazioni sotto carichi normali e condizioni di guasto note. Il dispositivo segmenta il segnale, rimuove l’offset, calcola feature compatte nel dominio temporale o di frequenza e esegue un rilevatore di anomalie o un classificatore. La frequenza di campionamento deve catturare le frequenze rilevanti di cuscinetti e alberi senza sovraccaricare memoria o energia. Le etichette devono derivare da ispezioni verificate, non semplicemente da un allarme che potrebbe essere errato.
L’addestramento avviene su una workstation, seguito da quantizzazione, conversione e compilazione per il microcontrollore di destinazione. Misura la flash del modello, la RAM di picco, il tempo di esecuzione, l’energia e l’accuratezza sul dispositivo fisico. L’aritmetica intera e la disponibilità degli operatori possono modificare gli output rispetto al modello di addestramento. Testa l’orientamento del sensore, il montaggio, temperatura, tensione, variazione dei componenti e vibrazioni di fondo reali, non solo file di laboratorio curati.
Il dispositivo distribuito necessita di calibrazione, aggiornamenti firmware sicuri, segnalazione della versione, comportamento di fail‑safe e un piano per la deriva. Può trasmettere solo un punteggio di salute o feature selezionate per risparmiare energia e proteggere i dati grezzi, ma i falsi allarmi locali generano comunque costi di manutenzione. Usa una soglia a tappe, richiedi persistenza e combina le evidenze del modello con lo stato operativo. TinyML è più utile quando latenza locale, privacy, connettività o vincoli energetici giustificano i suoi limiti ingegneristici.
I test di produzione dovrebbero includere il recupero da riavvio, deriva dell’orologio, disconnessioni del sensore, input corrotti, esaurimento della memoria e aggiornamenti interrotti. Definisci cosa succede quando il modello non può essere eseguito o la confidenza crolla: un valore predefinito sicuro, un indicatore di errore esplicito o una regola convenzionale può essere preferibile a un’ipotesi silenziosa. Traccia le versioni hardware e firmware della flotta così che un errore appena osservato possa essere isolato a una revisione del dispositivo, ambiente o rilascio del modello.
Checklist di implementazione pratica
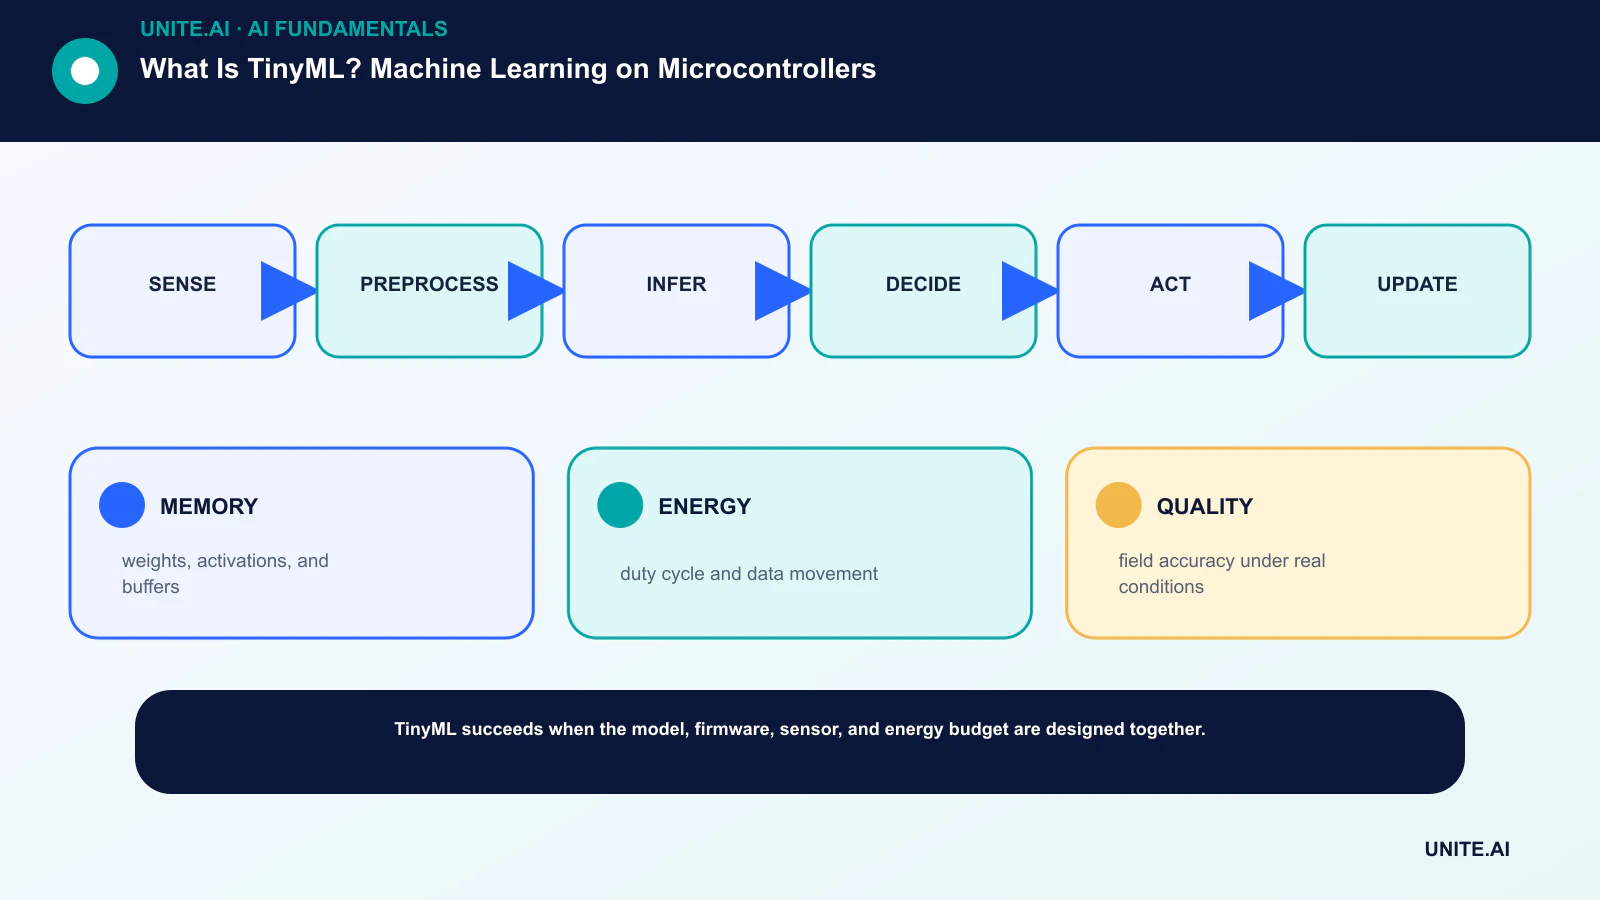
Trasforma il concetto in un flusso di lavoro delimitato e verificabile: rilevare → preelaborare → inferire → decidere → agire → aggiornare. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa guasti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare il campo d’azione. Registra versioni e assunzioni affinché un altro team possa riprodurre il risultato e capire cosa è cambiato.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, operano, mettono in sicurezza e sono influenzate dal sistema. Testa casi normali, condizioni limite, guasti di dipendenze e usi impropri; conserva le evidenze e i rischi non risolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesamina la decisione quando arrivano dati dal mondo reale, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- MEMORY: pesi, attivazioni e buffer.
- ENERGY: ciclo di lavoro e movimento dei dati.
- QUALITY: accuratezza sul campo in condizioni reali.
Domande frequenti
TinyML è lo stesso dell’AI mobile?
Non esattamente. I dispositivi mobili sono sistemi edge con processori e memoria relativamente grandi. TinyML si concentra su vincoli molto più stringenti di tipo embedded e microcontrollore.
I modelli TinyML possono apprendere sul dispositivo?
La maggior parte dei deployment addestra altrove e inferisce sul dispositivo. Un’adattamento limitato è possibile, ma memoria, energia, stabilità, privacy e rollback rendono l’addestramento sul dispositivo più difficile.
Riferimenti principali












