
Fondamenti di IA
Cos’è Albumentations? Augmentazione delle Immagini per la Visione Artificiale

 Aggiungi Unite.AI alle tue fonti preferite su Google
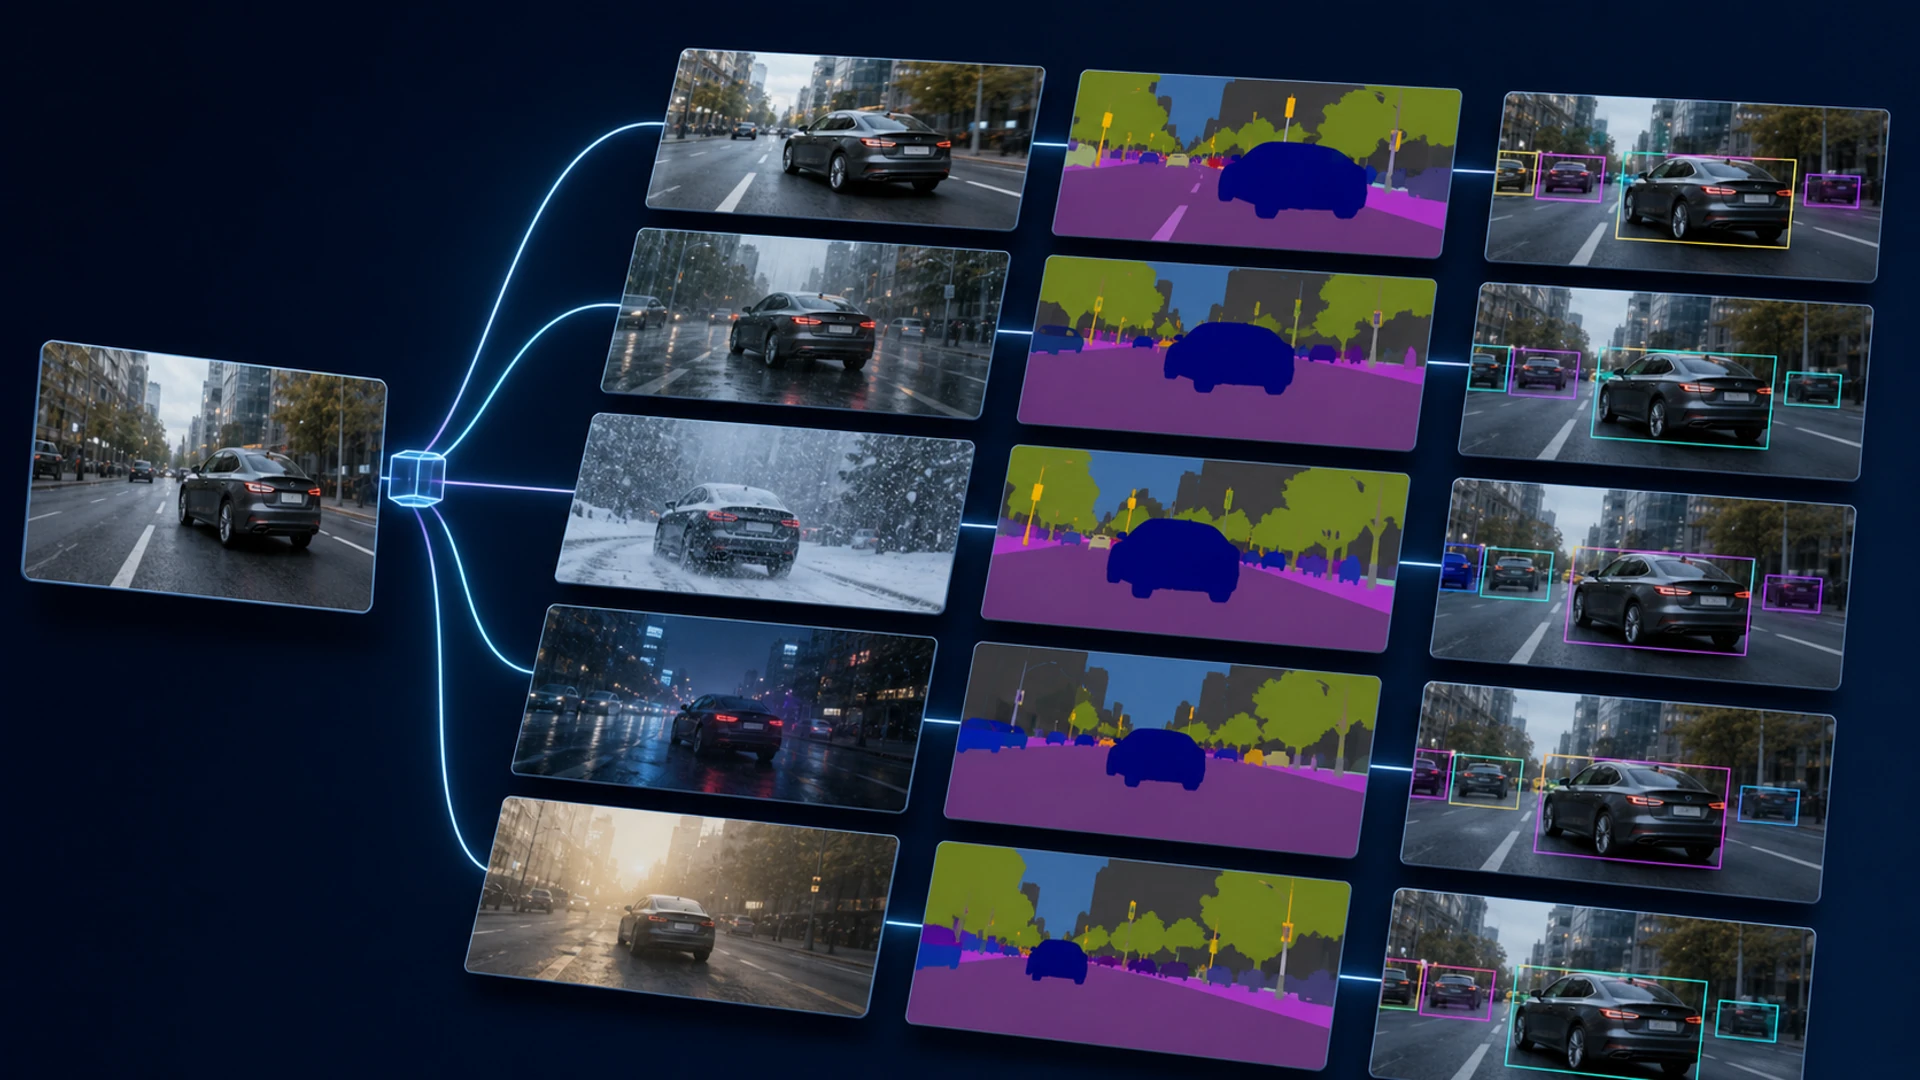
Albumentations è una libreria Python open‑source per l’augmentazione delle immagini. Applica trasformazioni geometriche e fotometriche randomizzate mantenendo allineati i target correlati — come maschere di segmentazione, bounding box e punti chiave — con l’immagine.
L’augmentazione è un’assunzione di invarianza: indica al modello che le modifiche selezionate non devono alterare l’etichetta del compito. Una libreria veloce semplifica gli esperimenti, ma solo la conoscenza del dominio e la validazione possono determinare se una trasformazione è legittima.
Punti chiave
- Componi trasformazioni probabilistiche in una pipeline di addestramento riproducibile.
- Trasforma immagini e target spaziali insieme; valida esplicitamente le convenzioni di box e punti chiave.
- Applica augmentazione casuale ai dati di addestramento, non alla distribuzione di validazione o test non modificata.
- Misura gli effetti per classe e sottogruppo perché un’augmentazione più forte può aiutare un caso e danneggiarne un altro.
Come funziona una pipeline Albumentations
Una pipeline riceve un’immagine e i target nominati, campiona le trasformazioni in base alle loro probabilità e restituisce un dizionario di output aggiornati. Le trasformazioni geometriche possono ritagliare, ruotare, capovolgere o deformare; le trasformazioni fotometriche possono modificare colore, contrasto, sfocatura o rumore.
La libreria si integra con gli stack di addestramento mantenendo il focus sull’augmentazione. Per computer vision, questa separazione consente di valutare le politiche dei dati indipendentemente dal framework del modello.
Mantieni le etichette geometricamente corrette
Un ritaglio che modifica un’immagine deve anche ritagliare la sua maschera e aggiornare o rimuovere le box e i punti chiave interessati. Configura il formato delle coordinate, i campi delle etichette, la visibilità minima, il clipping e le regole di filtraggio, quindi visualizza i batch prima dell’addestramento.
L’interpolazione varia a seconda del target: un’immagine può usare l’interpolazione bilineare, mentre una maschera di classe generalmente richiede l’interpolazione nearest‑neighbor per evitare di inventare valori di categoria. Una gestione scorretta dei target può corrompere silenziosamente il dataset.
Scegli trasformazioni dal mondo del deployment
Un flip orizzontale può essere valido per foto di fauna selvatica ma errato per testo, segnali stradali, laternalità medica o attrezzature asimmetriche. Le variazioni di colore possono migliorare la robustezza rispetto all’illuminazione, ma cancellare una caratteristica diagnostica quando il colore ha un significato.
Inizia con variazioni di disturbo plausibili, aggiungi una famiglia alla volta e ispeziona gli esempi difficili. Collega le scelte alle ipotesi di overfitting invece di presumere che una maggiore varietà sintetica sia sempre migliore.
Riproducibilità e valutazione
Registra la versione della libreria, la configurazione della pipeline, le probabilità, la strategia del seed casuale, l’ordine di preprocessing e la normalizzazione. La casualità dovrebbe variare i campioni di addestramento mentre gli esperimenti rimangono riproducibili a livello di esecuzione.
Mantieni le immagini di validazione e test rappresentative e non augmentate, tranne per il preprocessing deterministico. Confronta accuratezza, calibrazione, errori per classe e robustezza. Le matrici di confusione possono rivelare quando un’augmentazione sposta l’errore invece di ridurlo.
Composizione, probabilità e target
Compose applica una sequenza di trasformazioni, ciascuna con una probabilità. I costrutti OneOf o SomeOf campionano tra alternative, e le probabilità annidate determinano la distribuzione effettiva. La politica di augmentazione risultante è quindi un programma stocastico; registrala e ispeziona le frequenze campionate invece di leggere ogni probabilità isolatamente.
Target aggiuntivi consentono a più immagini o maschere di condividere la geometria, utile per coppie stereo, immagini prima‑e‑dopo o più annotazioni. Il supporto per bounding‑box richiede un formato dichiarato come Pascal VOC, COCO, YOLO o le coordinate di Albumentations. I formati dei punti chiave possono includere angolo o scala, e le trasformazioni devono preservare tali semantiche.
I ritagli possono rimuovere tutti i target. Decidi se ricampionare, mantenere un esempio di sfondo o filtrarlo, poiché ogni scelta modifica la distribuzione delle classi. Le pipeline di detection e segmentazione dovrebbero registrare le box scartate, le frazioni visibili e i campioni vuoti per rivelare danni silenziosi alle etichette.
Progettazione della politica per compito
La classificazione spesso tollera ritagli, variazioni di colore, sfocatura e occlusione quando la classe rimane visibile. La detection richiede che oggetti e box siano trasformati insieme. La segmentazione richiede una geometria di maschera esatta. La stima della posa deve preservare i punti chiave e può necessitare scambi di etichette sinistra‑destra dopo il flip.
L’imaging medico può vietare flip, cambiamenti di colore aggressivi o interpolazioni che alterano l’intensità quantitativa. Il telerilevamento deve considerare orientamento, stagione, bande sensoriali e scala geospaziale. L’analisi dei documenti deve preservare leggibilità e layout. Il dominio definisce l’invarianza; la libreria ne esegue solo l’implementazione.
Metodi di mix come MixUp, CutMix, Mosaic o copy‑paste creano etichette composite e possono avvenire nel data loader o nel framework anziché in Albumentations. La loro interazione con le trasformazioni di base, la normalizzazione e il batching dovrebbe essere testata. Politiche forti possono rallentare la convergenza o modificare la calibrazione anche quando l’accuratezza finale migliora.
Prestazioni, debug e progettazione degli esperimenti
L’augmentazione gira su CPU a meno che non venga usato un percorso diverso. Misura il throughput del data‑loader, il numero di worker, il costo di decodifica, le copie di memoria e il tempo di inattività della GPU. Trasformazioni più veloci sono utili solo se non alterano la semantica. Cache le fasi di decodifica o preprocessing immutabili quando lo spazio di archiviazione e la riproducibilità lo consentono.
Visualizza griglie di campioni originali e trasformati con tutti i target sovrapposti. Aggiungi test automatizzati per round‑trip di coordinate, valori delle maschere, forma, dtype e replay deterministico. Imposta i seed nello scope corretto; un’augmentazione identica su tutti i worker può ridurre involontariamente la diversità.
Esegui ablazioni rispetto a un baseline fisso: nessuna augmentazione, trasformazioni di base plausibili, poi politiche più forti. Ripeti i seed e riporta la varianza. Valuta dati puliti, corruzioni rilevanti e sottogruppi separatamente. Mantieni una politica solo quando il suo beneficio supera i test su dati tenuti da parte e le immagini trasformate rimangono credibili per gli esperti del dominio.
Progettare e convalidare una pipeline Albumentations
Inizia dalle variazioni previste dopo il deployment: angolo della fotocamera, ritaglio, scala, illuminazione, compressione, sfocatura, condizioni meteo, occlusione e rumore del sensore. Scegli trasformazioni che preservino l’etichetta e corrispondano a tali meccanismi. Un flip orizzontale può essere valido per animali ma non per testo, orientamento del traffico o anatomia asimmetrica. Forti cambiamenti di colore possono distruggere informazioni diagnostiche rilevanti anche se l’immagine sembra ancora plausibile.
Albumentations compone le trasformazioni e applica cambiamenti spaziali in modo coerente a immagini, maschere, bounding box e punti chiave quando configurato correttamente. Dichiarare esplicitamente i formati delle coordinate, la visibilità minima, l’interpolazione e la gestione delle maschere. Visualizza centinaia di campioni augmentati con annotazioni sovrapposte, testa casi vuoti e di confine, e salva i parametri randomizzati per il debug. Suddividi i dati per soggetto o scena prima dell’augmentazione così che immagini correlate non trapelino tra training e test.
Confronta nessuna augmentazione, augmentazione semplice e la politica proposta su un set di test non modificato e su set di stress realistici. Monitora accuratezza per classe, localizzazione, calibrazione ed esempi di fallimento, non solo la loss di addestramento. Un’augmentazione eccessiva può far underfit della distribuzione reale, mentre un’augmentazione debole può favorire l’apprendimento di scorciatoie. Versiona la pipeline con il modello, i seed delle valutazioni, ed evita di applicare trasformazioni di addestramento casuali durante la validazione o l’inferenza a meno che l’augmentazione in fase di test non sia valutata deliberatamente.
Per detection e segmentazione, verifica il clipping delle coordinate, l’area minima delle box, la visibilità dei punti chiave e l’interpolazione usata per le maschere categoriche. L’interpolazione nearest‑neighbor è tipicamente necessaria per gli ID di classe, mentre l’interpolazione bilineare può creare etichette non valide. Profilare anche il data‑loader: trasformazioni aggressive possono rendere l’augmentazione CPU il collo di bottiglia dell’addestramento. Cache solo le trasformazioni che sono deterministicamente riproducibili e preservano la casualità prevista attraverso epoche e worker.
Checklist pratica di implementazione
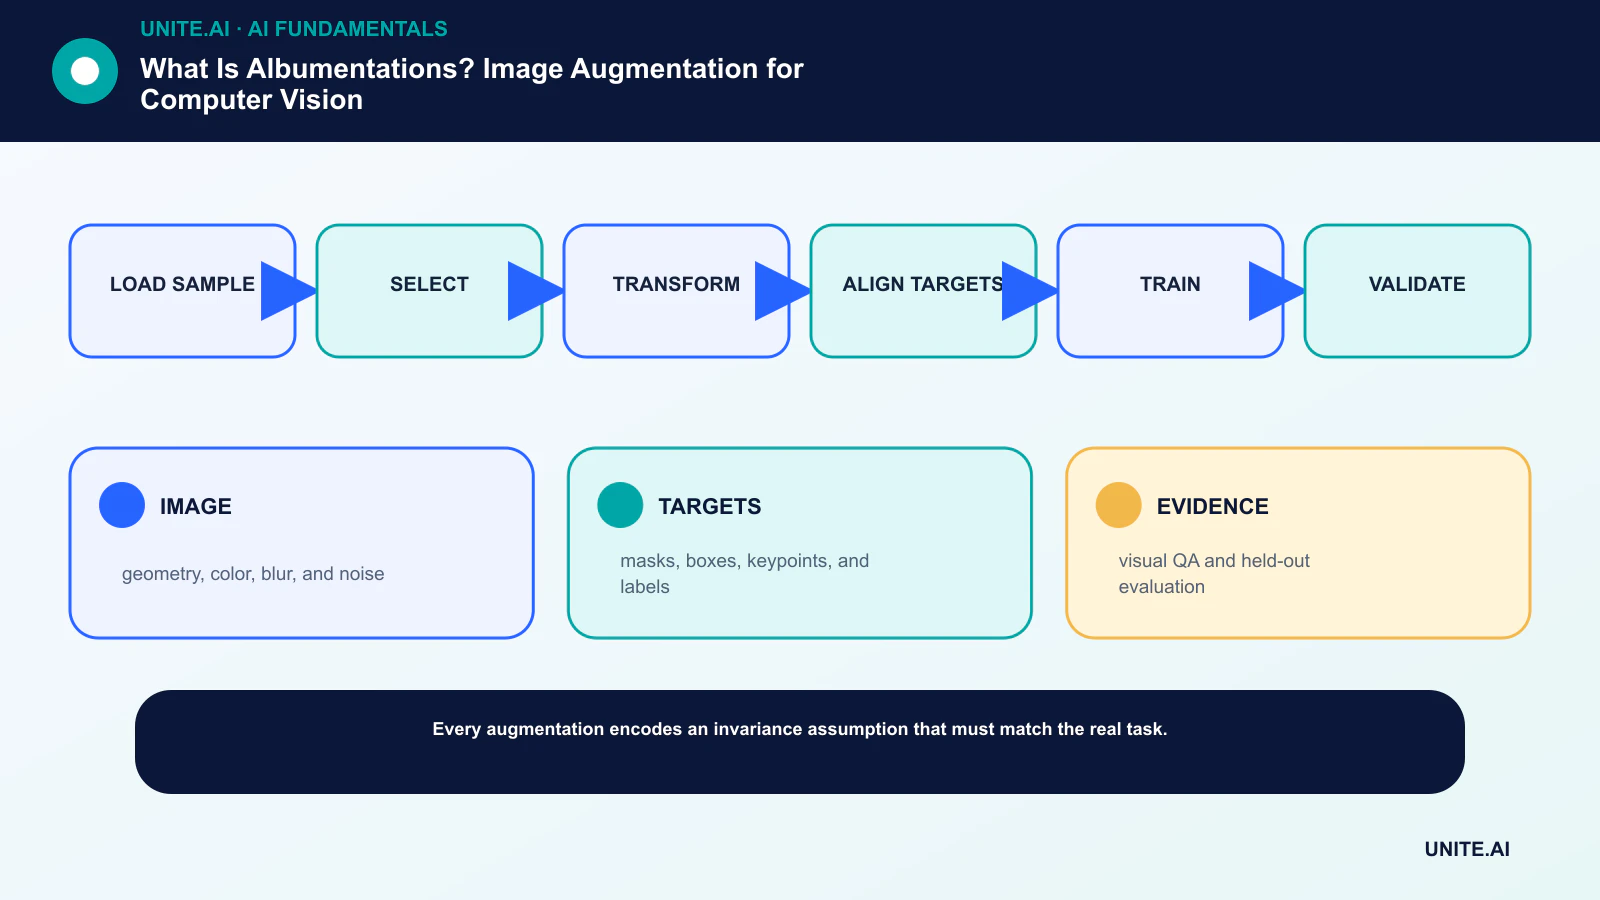
Trasforma il concetto in un flusso di lavoro delimitato e testabile: carica il campione → seleziona → trasforma → allinea i target → addestra → valida. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci un baseline semplice, definisci criteri di accettazione e di interruzione, testa i fallimenti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare il campo d’azione. Registra versioni e ipotesi affinché un altro team possa riprodurre il risultato e comprendere le modifiche.
Prima del lancio, esegui una revisione di readiness documentata con le persone che costruiscono, gestiscono, mettono in sicurezza e sono influenzate dal sistema. Testa casi normali, condizioni di confine, fallimenti di dipendenze e usi impropri; conserva le evidenze e i rischi irrisolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesamina la decisione dopo l’arrivo di dati reali, poiché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- IMAGE: geometria, colore, sfocatura e rumore.
- TARGETS: maschere, box, punti chiave e etichette.
- EVIDENCE: QA visiva e valutazione su set tenuto da parte.
Domande frequenti
L’augmentazione delle immagini crea una nuova verità di base?
No. Crea esempi di addestramento trasformati sotto l’assunzione che le etichette rimangano valide. Una trasformazione irrealistica o etichettata in modo errato introduce rumore.
Le immagini di validazione dovrebbero essere augmentate?
Usa ridimensionamento e normalizzazione deterministici richiesti dal modello, ma mantieni fissa la distribuzione di valutazione. L’augmentazione in fase di test è un metodo di inferenza separato e dovrebbe essere segnalato esplicitamente.
Riferimenti principali












