Modelli e piattaforme di IA
Cos’è la legge di Moore e come influisce sull’AI?

 Aggiungi Unite.AI alle tue fonti preferite su Google
La legge di Moore è l’osservazione storica secondo cui i circuiti integrati economicamente utili tendevano ad aumentare i componenti a un ritmo esponenziale. Non è una legge della fisica e non afferma che i computer diventino automaticamente due volte più veloci secondo un calendario fisso.
Per l’AI, la densità di transistor è importante perché consente più unità aritmetiche, memoria e interconnessioni. Tuttavia, il progresso pratico dipende anche dall’architettura, dalla precisione numerica, dal packaging, dalla larghezza di banda della memoria, dagli algoritmi, dal software, dall’energia, dal rendimento di produzione e dalla quantità di dati utili.
Punti chiave
- L’articolo originale di Moore del 1965 descriveva una tendenza economica e ingegneristica, non una garanzia fisica.
- La scalatura della frequenza di clock è rallentata; i guadagni moderni provengono sempre più dal parallelismo e dagli acceleratori specializzati.
- Le prestazioni dell’AI sono spesso limitate dal movimento della memoria e dall’energia, non solo dall’aritmetica.
- Confronta i sistemi in base a latenza, throughput, qualità, consumo energetico e costo totale a livello di carico di lavoro, non al numero di transistor.
Cosa osservò realmente Moore
Gordon Moore tracciò il numero di componenti nei circuiti integrati più avanzati e proiettò una crescita rapida continua al costo minimo per componente. In seguito il ritmo fu comunemente riassunto come un raddoppio circa ogni due anni, ma le formulazioni e le grandezze misurate sono variate.
Feature più piccole possono aumentare la densità e ridurre alcuni costi di commutazione, tuttavia la complessità e l’economia della produzione determinano se la tendenza rimanga utile. I nomi dei nodi sono etichette di marketing, quindi non dovrebbero essere considerati come un confronto fisico diretto tra le fonderie.
Da core più veloci al calcolo eterogeneo
La scalatura della tensione in stile Dennard consentiva un tempo per volta di aumentare le frequenze di clock senza una crescita proporzionale del consumo energetico, ma tale relazione si è indebolita. I progettisti si sono orientati verso CPU multicore, GPU, unità tensor, chiplet, packaging avanzato e acceleratori specifici per dominio.
Questa eterogeneità è centrale per il deep learning. Operazioni dense su matrici possono essere eseguite efficientemente su hardware parallelo, mentre le CPU coordinano logica irregolare e movimento dei dati. Il componente più veloce non è utile se la pipeline non riesce a mantenerlo alimentato.
Memoria, precisione e algoritmi
L’addestramento e l’inferenza spostano ripetutamente pesi, attivazioni e dati di cache attraverso una gerarchia di memoria on-chip e off-chip. Larghezza di banda, capacità, località e comunicazione possono dominare i costi. Una precisione numerica più bassa e la quantizzazione riducono gli spostamenti quando la qualità rimane accettabile.
Miglioramenti algoritmici possono ridurre la quantità di calcolo necessaria per raggiungere un risultato target. Modelli sparsi, metodi di efficienza dei transformer, ottimizzatori migliori e dati di qualità superiore influenzano tutti il progresso effettivo percepito dagli utenti.
Come confrontare l’hardware AI
Le operazioni di picco al secondo sono teoriche. Usa un modello rappresentativo, dimensione del batch, lunghezza della sequenza, precisione, stack software e soglia di qualità. Riporta latenza end-to-end, throughput, consumo energetico, occupazione di memoria, utilizzo e costo.
I sistemi edge possono dare più valore alla privacy e al basso consumo energetico rispetto al throughput massimo; i data center possono dare priorità al totale di token o campioni per watt. Edge AI chiarisce perché un unico numero principale non può descrivere ogni sistema utile.
Perché la scalatura dei semiconduttori è cambiata
I primi progressi dei circuiti integrati combinavano dispositivi più piccoli, una migliore produzione, costi inferiori per componente e miglioramenti di design. Per anni, la riduzione delle dimensioni dei transistor ha anche supportato commutazioni più rapide e minore energia per operazione. Alla fine, perdite, limiti di tensione, densità di calore, ritardi delle interconnessioni e costi di fabbricazione hanno indebolito la semplice relazione tra un nuovo nodo di processo e core generici più veloci.
Il progresso moderno è quindi multidimensionale. I dispositivi FinFET e gate‑all‑around migliorano il controllo elettrostatico; la litografia EUV supporta pattern più piccoli; i chiplet consentono ai progettisti di combinare die realizzati con processi diversi; il packaging avanzato avvicina calcolo e memoria. Il rendimento e il packaging determinano se un design tecnicamente impressionante è economico su larga scala.
Il rallentamento di un meccanismo di scalatura non significa che l’hardware abbia smesso di migliorare. Significa che gli architetti devono impiegare i transistor in modo più deliberato. Unità specializzate scambiano flessibilità per throughput o efficienza su carichi di lavoro selezionati, mentre cache più grandi e interconnessioni cercano di mantenere queste unità alimentate.
Come i carichi di lavoro AI sollecitano l’hardware
L’addestramento alterna computazione forward, backpropagation, aggiornamenti dell’ottimizzatore e comunicazione tra acceleratori. L’inferenza varia dal punteggio batch alla generazione interattiva di token. La moltiplicazione di matrici è importante, ma embedding, normalizzazione, funzioni di attivazione, attenzione, routing, accesso alla cache e orchestrazione dell’host contribuiscono tutti alle prestazioni reali.
L’intensità aritmetica — la quantità di calcolo eseguita per byte spostato — aiuta a spiegare se un carico di lavoro è limitato dal calcolo o dalla larghezza di banda. Batch di piccole dimensioni e decodifica autoregressiva spesso lasciano le unità aritmetiche sottoutilizzate perché i pesi o i dati della cache devono essere prelevati ripetutamente. Batch più grandi migliorano l’utilizzo ma aumentano latenza e memoria.
Il formato numerico modifica il compromesso. FP32, BF16, FP16, FP8 e i formati interi differiscono per intervallo, precisione, supporto hardware ed errore. L’addestramento a precisione mista preserva le operazioni sensibili a precisione più alta; l’inferenza quantizzata richiede calibrazione e test di qualità, piuttosto che la promessa che ogni modello tolleri la stessa larghezza di bit.
Economia dei sistemi e direzioni future
Il costo totale dell’AI comprende l’acquisto o il noleggio dell’acceleratore, l’alimentazione, il raffreddamento, la rete, lo storage, l’ingegneria del software, la capacità inattiva e gli esperimenti falliti. Un chip più veloce può costare di più complessivamente se l’utilizzo è scarso o se il modello richiede una topologia distribuita costosa. Misura l’output utile a una soglia di qualità definita.
La scalatura è anche limitata da dati e algoritmi. Più calcolo non può correggere dati etichettati erroneamente o una valutazione che premia scorciatoie. Attenzione efficiente, ottimizzatori migliori, sparsità, recupero, distillazione e scoperte algoritmiche possono migliorare i risultati senza un aumento proporzionale dell’hardware, sebbene possano spostare i costi altrove.
I sistemi futuri combineranno progressi di processo con impilamento tridimensionale, memoria ad alta larghezza di banda, interconnessioni ottiche o elettriche avanzate, flusso di dati specifico per dominio e software co‑progettato. La legge di Moore rimane un contesto storico prezioso, ma la pianificazione dovrebbe basarsi su curve di carico di lavoro misurate e su vincoli realistici di fornitura, energia e distribuzione.
Leggere correttamente la legge di Moore nella progettazione di un sistema AI
Un’analisi utile separa densità di transistor, prestazioni della CPU a uso generale, throughput dell’acceleratore, capacità di memoria, larghezza di banda della memoria, interconnessione, energia, rendimento di produzione e costo. Questi non migliorano allo stesso ritmo. Un carico di lavoro AI dominato dallo spostamento dei pesi del modello può trarre poco vantaggio da più unità aritmetiche, mentre un piccolo modello on‑chip può beneficiare notevolmente da hardware specializzato a bassa precisione. Riporta la metrica esatta, la precisione, il carico di lavoro e l’involucro di potenza invece di trattare un nodo di processo come prestazione.
Scalare un modello AI modifica anche le esigenze di software e sistema. Esecuzioni di addestramento più grandi richiedono algoritmi paralleli, checkpoint affidabili, rete ad alta velocità, pipeline di storage e dati sufficienti per sfruttare la capacità aggiuntiva. Nell’inferenza, la latenza dipende dalla lunghezza del prompt, dai token generati, dal batching, dalla memoria cache e dagli obiettivi di livello di servizio. Miglioramenti algoritmici, sparsità, quantizzazione, recupero e dati migliori possono fornire guadagni indipendenti dalle tendenze dei transistor e talvolta superare una generazione hardware.
Per la pianificazione, esegui benchmark su modelli rappresentativi su sistemi candidati e modello il costo totale durante il ciclo di vita della distribuzione: prezzo di acquisizione o cloud, energia, raffreddamento, utilizzo, ingegneria, migrazione e rischio di fornitura. Usa scenari invece di una singola previsione esponenziale. La legge di Moore rimane un’osservazione storica preziosa sull’economia dell’integrazione, ma non garantisce che l’AI diventi proporzionalmente più veloce, più economica, più capace o più sostenibile secondo un calendario fisso.
Checklist di implementazione pratica
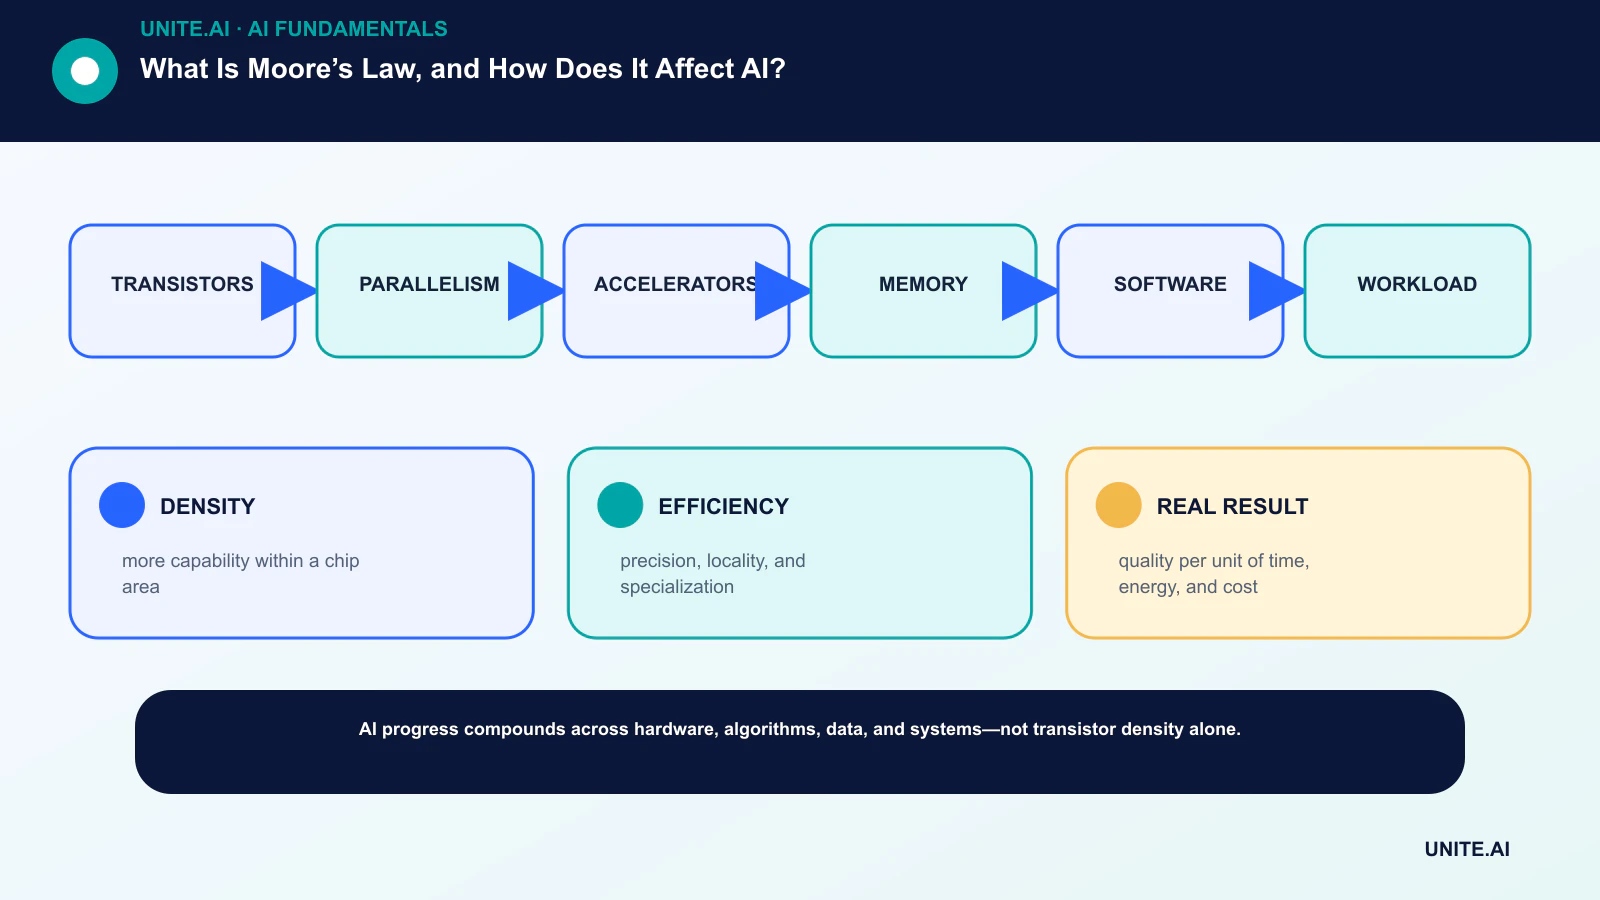
Trasforma il concetto in un flusso di lavoro delimitato e verificabile: transistor → parallelismo → acceleratori → memoria → software → carico di lavoro. Assegna un responsabile, documenta i dati e le dipendenze, stabilisci una baseline semplice, definisci criteri di accettazione e di interruzione, testa guasti rappresentativi e definisci monitoraggio, rollback e revisione prima di ampliare l’ambito. Registra versioni e ipotesi affinché un altro team possa riprodurre il risultato e comprendere cosa è cambiato.
Prima del lancio, esegui una revisione di prontezza documentata con le persone che costruiscono, gestiscono, mettono in sicurezza e sono influenzate dal sistema. Testa casi normali, condizioni limite, guasti di dipendenza e usi impropri; conserva le evidenze e i rischi irrisolti. Definisci chi può approvare il rilascio, modificare una soglia, sovrascrivere un output o interrompere l’operazione. Riesamina la decisione quando arrivano dati reali, perché un pilota tecnicamente riuscito non garantisce prestazioni affidabili su scala più ampia.
- DENSITÀ: più capacità all’interno di un’area del chip.
- EFFICIENZA: precisione, località e specializzazione.
- RISULTATO REALE: qualità per unità di tempo, energia e costo.
Domande frequenti
La legge di Moore è finita?
La semplice tendenza storica si è rallentata e ha cambiato carattere, ma il progresso dei semiconduttori continua attraverso dispositivi, architettura, packaging, memoria e software. Se l’espressione sia ancora adeguata dipende dalla metrica.
Il doppio dei transistor significa il doppio delle prestazioni AI?
No. Le prestazioni dipendono da come i transistor vengono utilizzati e da larghezza di banda, precisione, struttura del modello, efficienza del software, potenza e vincoli del carico di lavoro.
Riferimenti principali