Fundamentele AI
Ce sunt modelele lingvistice mari (LLM-uri)?

 Adaugă Unite.AI la sursele tale preferate pe Google
Un model lingvistic mare (LLM) este o rețea neuronală antrenată pe colecții mari de secvențe pentru a prezice tokenuri sau obiective lingvistice conexe. Majoritatea LLM-urilor actuale utilizează arhitecturi transformer și pot genera, clasifica, rezuma, traduce, recupera și transforma limbajul printr-o interfață comună.
Un LLM nu este o bază de date sau un raționator garantat. Ieșirea sa este o predicție condițională modelată de datele de antrenament, de post-antrenament, de context, de instrumente și de decodare. Fluenta poate coexista cu erori factuale, incertitudine, părtinire sau comportament nesigur.
Aspecte cheie
- Tokenizarea convertește textul în unități discrete; încorporările și atenția construiesc reprezentări contextuale.
- Pre-antrenarea învață tipare largi, în timp ce ajustarea fină și metodele de preferință modelează comportamentul sarcinii.
- Recuperarea și instrumentele pot adăuga dovezi sau acțiuni actuale, dar necesită permisiuni și validări separate.
- Evaluați sistemul implementat pentru calitate, fundamentare, siguranță, latență, cost și deriva.
Tokenuri, transformere și pre-antrenare
Textul este împărțit în tokenuri. Un transformer le transformă în vectori, amestecă informația prin straturi de atenție și feed‑forward și produce o distribuție de probabilitate pentru tokenul următor sau lipsă.
Obiectivele auto‑supervizate generează semnale de antrenament din secvențe brute. Scalarea în parametri, date și calcul poate îmbunătăți pierderea în mod previzibil pe intervale, însă calitatea setului de date, arhitectura, optimizarea și evaluarea determină ce capabilități apar în practică.
Post‑antrenare și inferență
Ajustarea prin instrucțiuni folosește demonstrații; optimizarea preferințelor poate face ca ieșirile să se potrivească mai bine cu judecățile umane sau cu o politică. În timpul inferenței, un prompt și istoricul conversației definesc contextul, în timp ce temperatura și setările de eșantionare influențează variabilitatea.
RLHF și metode similare modelează comportamentul în loc să instaleze un verificator complet de fapte. Modelul poate totuși să genereze un răspuns plauzibil, dar neîntemeiat.
Recuperare, instrumente și agenți
Generarea augmentată prin recuperare furnizează pasaje selectate dintr-o colecție externă. Apelarea de instrumente permite codului aplicației să interogheze baze de date, să calculeze, să caute sau să acționeze. Aceste tipare separă o parte din cunoaștere și execuție de greutățile modelului.
Aplicația trebuie să valideze argumentele instrumentelor, să impună permisiuni, să păstreze citările și să trateze conținutul recuperat ca intrare neîncrezătoare. Vector similarity search ajută la recuperare, dar nu demonstrează că un pasaj susține răspunsul.
Limitări și evaluare
LLM-urile pot hallucina, pot expune conținut memorat, pot urma instrucțiuni malițioase, pot reproduce părtiniri și pot eșua la sarcini care par similare cu exemplele de antrenament. Un context lung nu garantează că fiecare fapt este utilizat sau reconciliat corect.
Evaluați pe sarcini private reprezentative cu prompturi și versiuni documentate. Măsurați susținerea prin surse, refuzul, calibrul, securitatea, rezultatele subgrupurilor, volumul de muncă uman, latența și costul. Monitorizați după lansare, deoarece modelele, datele și comportamentul utilizatorilor se schimbă.
Date de antrenament și dezvoltarea modelului
Corpurile de pre-antrenare combină pagini web, cărți, cod, materiale academice, conversații și surse licențiate sau curate. Conductele detectează limba, elimină duplicatele, filtrează conținutul de calitate și nesigur, gestionează datele personale și aleg ponderile de amestec. Aceste alegeri modelează cunoașterea, acoperirea lingvistică, stilul, părtinirea și memorarea.
Procesele de optimizare lucrează cu loturi de secvențe de tokenuri și minimizează pierderea de predicție prin gradient descendent. Antrenarea distribuită împarte datele, tensorii modelului, etapele conductei sau experții pe acceleratoare. Salvarea punctelor de control, stabilitatea numerică, comunicarea în rețea și recuperarea de erori devin preocupări majore de inginerie la scară.
Evaluarea în timpul antrenamentului urmărește pierderea și suitele de capabilități, dar contaminarea benchmark-urilor poate umfla rezultatele. Se rețin perioade de timp și sarcini proprietare, se caută suprapuneri și se raportează prompturile exacte, decodarea, instrumentele și scorarea. Un model poate îmbunătăți pierderea medie, în timp ce regresii apar în siguranță sau în limbi cu resurse reduse.
Ferestre de context, decodare și inferență
În timpul inferenței, memoria cache cheie‑valoare stochează proiecțiile de atenție pentru tokenurile anterioare, astfel încât să nu fie recalculate la fiecare pas. Memoria cache crește odată cu numărul de straturi, secvență, lot și reprezentare. Cuantizarea și paginarea reduc presiunea, dar pot modifica calitatea sau latența.
Decodarea lacomă selectează tokenul cu cea mai mare probabilitate; temperatura reescalează probabilitățile; top‑k și top‑p restricționează setul de candidați; căutarea cu fascicul (beam search) urmărește mai multe secvențe. Cea mai bună strategie depinde de faptul dacă sarcina valorizează determinismul, diversitatea, ieșirea structurată sau probabilitatea secvenței. Validați întotdeauna schema după generare.
Un context lung crește cantitatea de informație disponibilă, dar nu garantează reamintirea sau raționamentul. Poziția, distragerile, contradicțiile și structura promptului afectează utilizarea. Recuperarea poate selecta un set de dovezi mai mic, în timp ce rezumarea comprimă istoricul cu riscul de a pierde detalii. Măsurați performanța în funcție de lungimea și poziția contextului.
Adaptare, implementare și economie
Ajustarea fină completă actualizează toți parametrii; metodele eficiente din punct de vedere al parametrilor actualizează adaptoare sau matrici de rang scăzut; pre-antrenarea continuă adaptează distribuția domeniului; ajustarea prin instrucțiuni și preferințe modelează răspunsurile. Recuperarea este adesea mai bună pentru fapte care se schimbă frecvent, în timp ce ajustarea este mai potrivită pentru comportament și formatul sarcinii. Metodele pot fi combinate.
Opțiunile de implementare includ API-uri găzduite, puncte finale gestionate, greutăți deschise auto-găzduite, modele pe dispozitiv și hibride. Comparați gestionarea datelor, controlul versiunilor, latența, debitul, regiunile, disponibilitatea, portabilitatea modelului, suportul și costul total. Auto-găzduirea transferă responsabilitatea pentru securitate, scalare, actualizări și monitorizarea abuzurilor.
Costul per token este incomplet. Un model slab poate necesita reîncercări, prompturi mai lungi, mai multe revizuiri sau erori costisitoare. Măsurați costul per sarcină finalizată cu succes la nivelul de calitate și risc necesar. Folosiți cache, loturi, modele mai mici direcționate și cod determinist acolo unde îmbunătățesc fluxul complet de lucru.
Exemplu practicat: ancorarea unui LLM în documente enterprise
Un asistent de documente ar trebui să înceapă cu un corpus conștient de permisiuni, identificatori de documente stabili, versiuni și date de intrare în vigoare, structură parsabilă și un set de evaluare de întrebări răspunzătoare, nerăspunzătoare, ambigue și contradictorii. Recuperarea indexează fragmentele și metadatele, dar dimensiunea și suprapunerea fragmentelor trebuie să corespundă structurii documentului. Calitatea căutării este măsurată independent înainte de generare, astfel încât un model fluent nu poate ascunde dovezi lipsă.
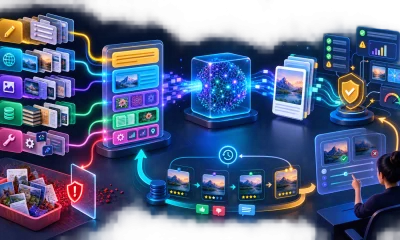
În timpul execuției, autentificați utilizatorul, filtrați recuperarea în funcție de acces, recuperați și reordonați dovezile, construiți un prompt limitat, generați un răspuns citat și validați ieșirea necesară. Modelul ar trebui să indice când sursele sunt în conflict sau nu susțin un răspuns. Utilizarea instrumentelor și acțiunile externe necesită autorizație separată. Protejați-vă împotriva instrucțiunilor încorporate în documentele recuperate tratând conținutul ca date, nu ca o politică de sistem cu prioritate superioară.
Evaluați recurența recuperării, precizia citărilor, corectitudinea răspunsului, fundamentarea, refuzul, latența și costul în funcție de roluri și tipuri de documente. Urmăriți versiunile modelului, promptului, indexului, parserului și corpusului pentru fiecare test. În producție, înregistrați ID-urile dovezilor și feedbackul fără a expune textul privat, monitorizați noile întrebări nerăspunzătoare după modificări de conținut și mențineți o alternativă sigură. O interfață LLM nu înlocuiește gestionarea înregistrărilor, controlul accesului sau revizuirea responsabilă a subiectului.
Planificarea capacității ar trebui să modeleze distribuțiile lungimii promptului și ale ieșirii, utilizatorii concurenți, comportamentul cache-ului, latența instrumentelor și ratele de reîncercare. Streamingul îmbunătățește latența percepută, dar complică moderarea și anularea deoarece conținutul nesigur sau incorect poate ajunge la utilizator înainte ca răspunsul complet să fie verificat. Stabiliți bugete pentru tokenuri și instrumente, izolați chiriașii, protejați acreditările furnizorului și exersați trecerea la o versiune alternativă a modelului fără a schimba silențios comportamentul de care utilizatorii depind.
Lista de verificare pentru implementare practică
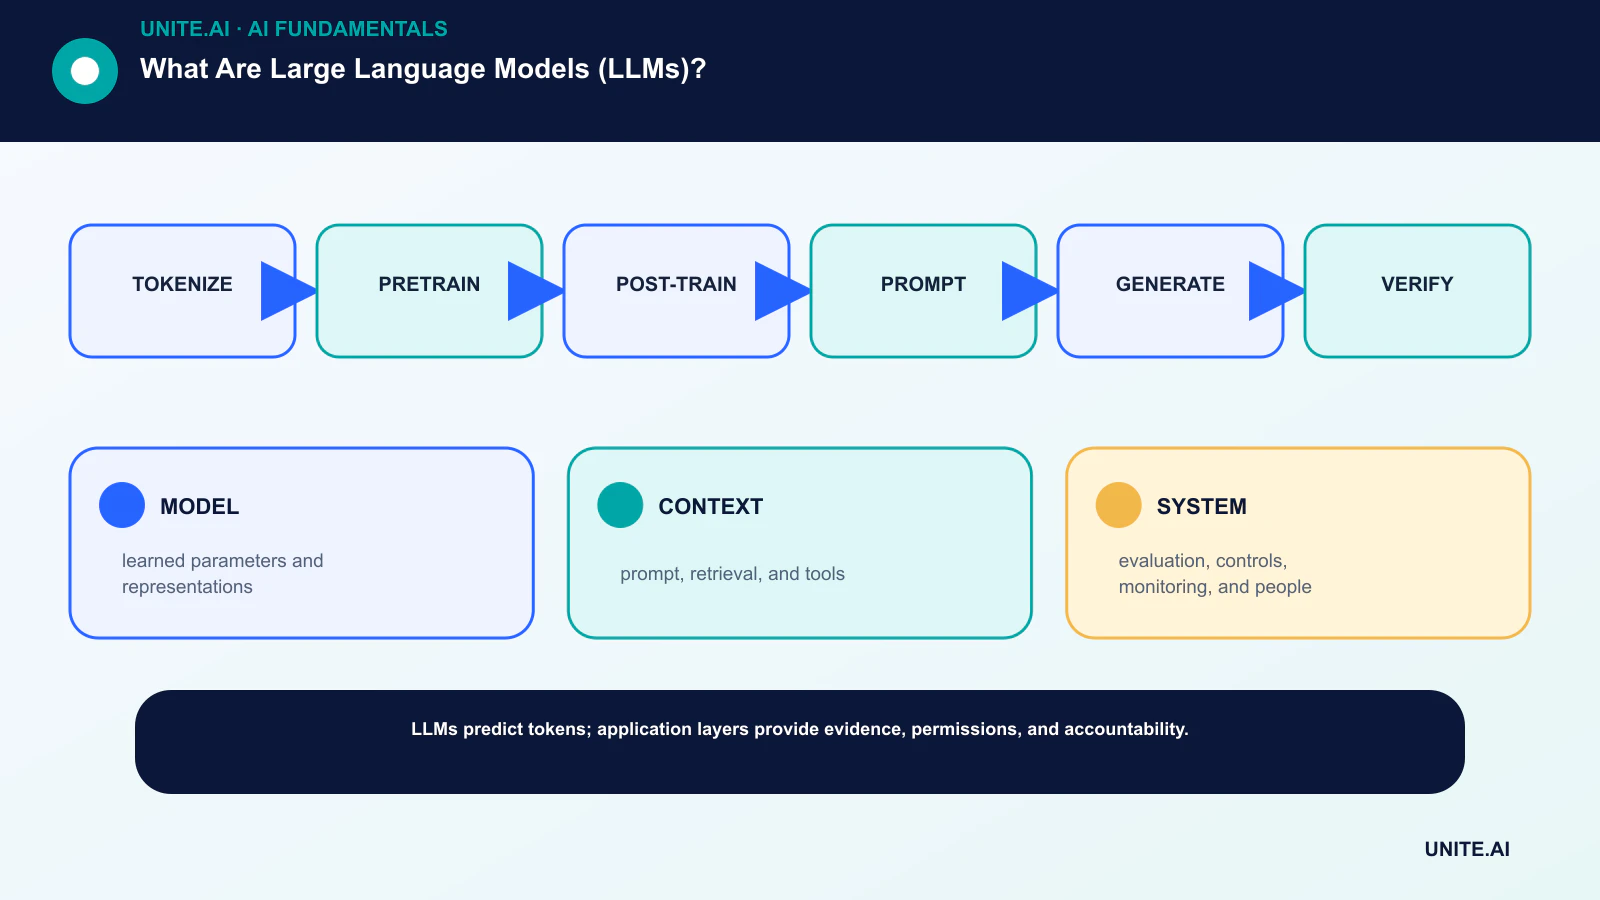
Transformați conceptul într-un flux de lucru limitat și testabil: tokenizare → pre-antrenare → post-antrenare → prompt → generare → verificare. Numiți un responsabil răspunzător, documentați datele și dependențele, stabiliți o linie de bază simplă, definiți criterii de acceptare și oprire, testați eșecuri reprezentative și definiți monitorizarea, revenirea și revizuirea înainte de a extinde domeniul. Înregistrați versiunile și presupunerile pentru ca o altă echipă să poată reproduce rezultatul și să înțeleagă ce s‑a schimbat.
Înainte de lansare, efectuați o revizuire documentată a pregătirii cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testați cazuri normale, condiții de frontieră, eșecuri de dependență și utilizări abuzive; păstrați dovezile și riscurile nerezolvate. Definiți cine poate aproba lansarea, modifica un prag, suprascrie o ieșire sau opri funcționarea. Reexaminați decizia după ce sosesc date din lumea reală, deoarece un pilot tehnic de succes nu garantează o performanță fiabilă la scară mai largă.
- MODEL: parametri învățați și reprezentări.
- CONTEXT: prompt, recuperare și instrumente.
- SYSTEM: evaluare, controale, monitorizare și persoane.
Întrebări frecvente
De ce sunt LLM-urile denumite mari?
Nu există un prag universal de parametri. „Mare” se referă la scară în raport cu modelele lingvistice anterioare, incluzând parametri, date de antrenament, calcul și amploarea utilizării.
Înțeleg LLM-urile limbajul?
Ele construiesc reprezentări interne utile și afișează un comportament complex, dar cuvântul „înțelege” are mai multe înțelesuri. Performanța ar trebui demonstrată sarcină cu sarcină, nu inferată din fluenta.
Referințe principale