
Fundamentele AI
Ce este Învățarea profundă?

 Adaugă Unite.AI la sursele tale preferate pe Google
Învățarea profundă este o familie de metode de învățare automată care utilizează rețele neuronale cu multiple straturi de procesare pentru a învăța reprezentări utile ale datelor. Aceste modele alimentează numeroase sisteme moderne pentru limbaj, imagini, audio, recomandări, predicții științifice și AI generativ.
Cuvântul deep se referă la numărul de transformări dintre intrare și ieșire, nu la o mașină care deține o înțelegere mai profundă. Un model profund învață relații numerice utile pentru obiectivul său de antrenare, iar performanța trebuie totuși testată pe date noi.
Aspecte cheie
- Învățarea profundă este un subset al învățării automate.
- Straturile transformă tensorii utilizând parametri învățați, activări neliniare, normalizare și alte operații.
- Propagarea înapoi calculează gradientele; un optimizer folosește acele gradienti pentru a actualiza parametrii antrenabili, inclusiv greutățile și biasele.
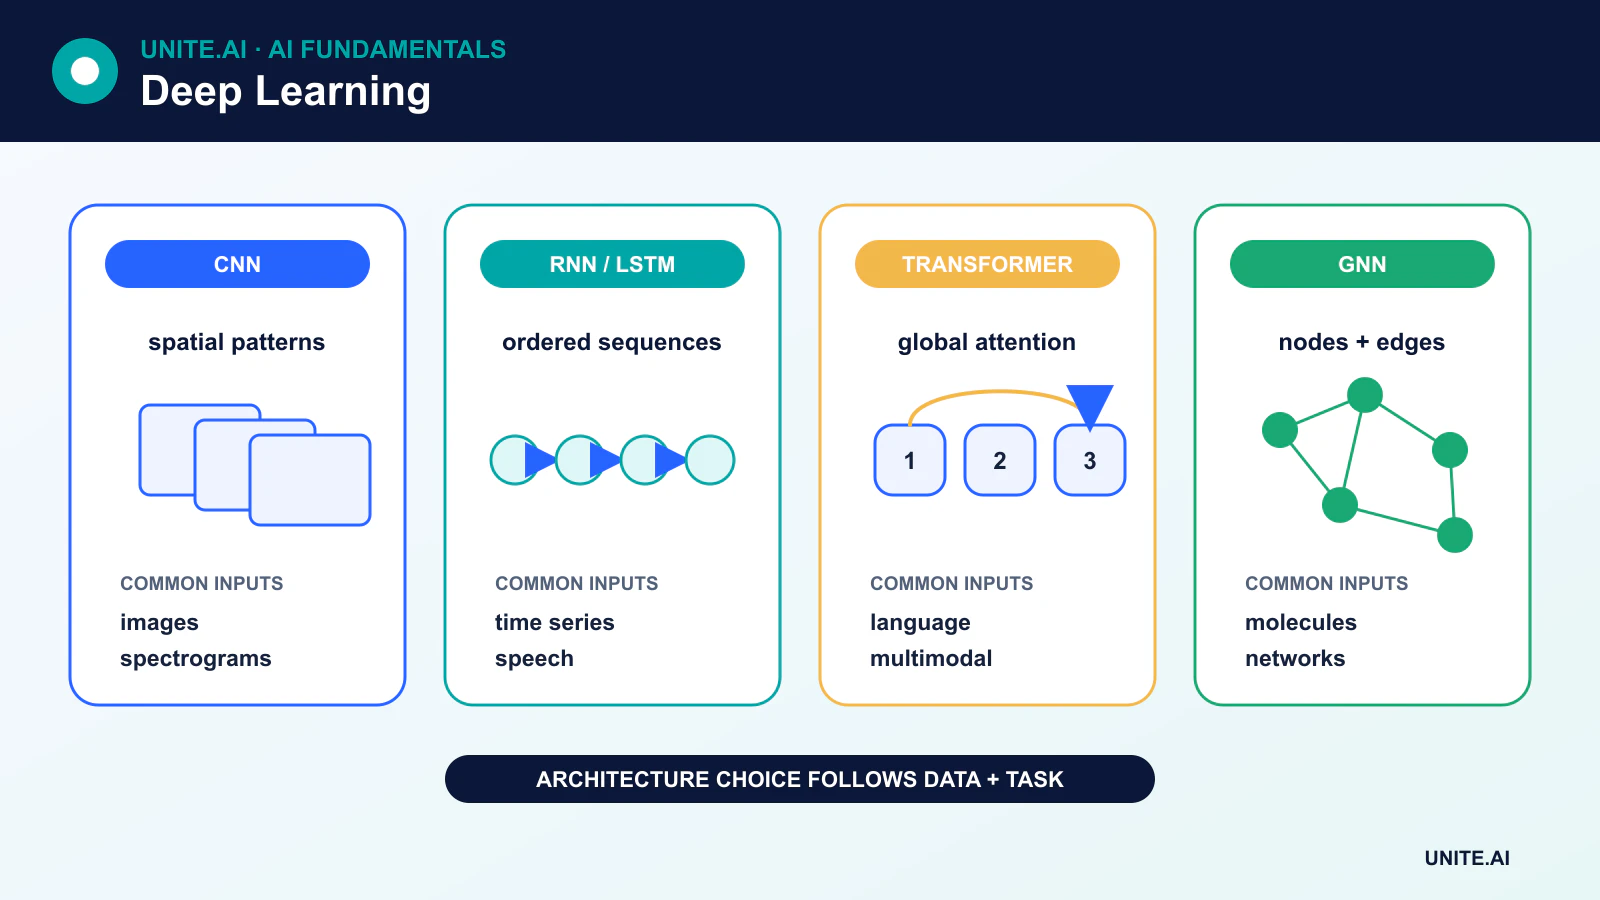
- CNN-urile, rețelele recurente, transformerele, autoencoderele și modelele de difuzie au structuri și avantaje diferite.
Cum învață o rețea neuronală profundă
O rețea neuronală primește date sub formă de tensori, adică matrice multidimensionale de numere. Un tensor de imagine poate codifica canalele de pixeli, în timp ce un model de limbaj utilizează vectori ce reprezintă tokenuri. Fiecare strat efectuează o transformare diferențiabilă și transmite rezultatul stratului următor.
Într-un strat dens de bază, modelul calculează o sumă ponderată a intrărilor, adaugă un bias antrenabil și apoi aplică o funcție de activare:
output = activation(Wx + b)
Funcția de activare introduce neliniaritate. Fără ea, stivuirea de straturi liniare obișnuite ar reprezenta tot o transformare liniară. ReLU și variantele sale sunt comune în straturile ascunse, în timp ce activările de ieșire depind de sarcină.
Antrenarea urmează, de obicei, patru pași:
- O trecere înainte generează predicții.
- O funcție de pierdere măsoară cât de diferite sunt predicțiile față de obiectiv.
- Propagarea înapoi aplică regula lanțului pentru a calcula gradientul pierderii față de fiecare parametru antrenabil.
- Un optimizer, cum ar fi gradientul descendent stochastic sau AdamW, actualizează parametrii.
Repetarea acestor pași pe multe loturi poate îmbunătăți modelul, dar o pierdere de antrenare mai mică nu garantează un comportament fiabil în lumea reală. Validarea, regularizarea, datele reprezentative și monitorizarea rămân esențiale.
Principalele arhitecturi de învățare profundă
Perceptroni cu mai multe straturi
Un perceptron cu mai multe straturi (MLP) folosește straturi complet conectate în care fiecare unitate de ieșire depinde de toate intrările din stratul precedent. MLP-urile sunt utile pentru caracteristici tabelare și ca componente în sisteme mai mari, dar nu includ presupuneri despre localitatea imaginii sau ordinea secvenței.
Rețele neuronale convoluționale
Rețelele neuronale convoluționale (CNN-uri) aplică filtre învățate pe regiuni locale. Partajarea greutăților le face eficiente pentru grile precum imagini și spectrograme. CNN-urile rămân importante pentru viziune și implementări la margine, deși transformerele vizuale și modelele hibride sunt, de asemenea, utilizate pe scară largă.
Rețele recurente, LSTM-uri și GRU-uri
Rețelele neuronale recurente (RNN-uri) actualizează o stare ascunsă pe măsură ce o secvență este procesată. LSTM-urile și unitățile recurente cu poartă ajută la păstrarea informației și reduc problema gradientului care dispare, ce face ca RNN-urile de bază să aibă dificultăți cu dependențe lungi. Ele nu elimină toate limitările de context lung, dar rămân utile pentru semnale în flux, date de serii temporale și modele secvențiale compacte.
Transformere
Transformerele utilizează atenția pentru a modela relațiile dintre elementele unei secvențe sau set. Capacitatea lor de a procesa multe poziții în paralel i-a ajutat să înlocuiască recurența în majoritatea sistemelor de limbaj la scară largă, iar variantele de transformere procesează acum imagini, audio, video, proteine și date multimodale.
Autoencodere și modele generative
Un autoencoder comprimă o intrare într-o reprezentare și reconstruieste intrarea din aceasta. Acest lucru creează un obiectiv de reconstrucție auto-supervizat; nu convertește automat datele neetichetate în exemple etichetate.
Rețelele generative adversariale antrenează un generator și un discriminator în competiție. Modelele de difuzie învață să inverseze un proces de zgomotare graduală. Transformerele autoregresive generează un token sau o unitate pe rând. Aceste abordări au dinamici de antrenare, control și cerințe de calcul diferite.
De ce adâncimea ajută — și de ce arhitectura contează
Mai multe straturi permit unui model să combine transformări simple în altele mai complexe. În viziune, unele caracteristici învățate pot evolua de la texturi locale spre tipare specifice sarcinii. În limbaj, straturile de atenție construiesc reprezentări de tokenuri dependente de context. Aceste descrieri sunt intuiții utile, nu reguli fixe despre ce trebuie să învețe fiecare strat.
Rețelele moderne se bazează și pe conexiuni reziduale, normalizare, inițializare atentă, regularizare și hardware optimizat. Simplă adăugare de straturi sau parametri poate face un model mai greu de antrenat, mai lent sau mai predispus la suprapunere. Scara modelului ajută doar când datele, obiectivul, optimizarea și mediul de implementare o susțin.
Antrenare vs inferență
Antrenarea ajustează parametrii și este de obicei etapa cu consum intens de calcul. Inferența rulează modelul antrenat pentru a produce o ieșire. Inferența poate fi încă costisitoare pentru modele mari, motiv pentru care echipele folosesc cuantizare, distilare, batch‑uri, caching, sparsitate și hardware specializat, cum ar fi unități de procesare neurală.
Limitări și utilizare responsabilă
Modelele profunde pot moșteni părtinire, memora informații sensibile, eșua în fața schimbărilor de distribuție și pot produce rezultate convingătoare, dar incorecte. De asemenea, pot fi dificil de interpretat și costisitoare de antrenat. Evaluarea ar trebui să acopere mai mult decât media unui benchmark: echipele au nevoie de performanță la nivel de clasă sau subgrup, robustețe, calibrare, securitate, latență, consum de energie și consecințele unui eșec.
Reprezentări, optimizare și alegeri de arhitectură
Rețelele profunde învață reprezentări succesive prin straturi parametrizate. Transformările liniare amestecă intrările; activările neliniare permit rețelei să aproximeze funcții complexe; normalizarea și conexiunile reziduale ajută la optimizare; atenția, convoluția, recurența sau operațiile de tip state‑space codifică diferite presupuneri structurale. Adâncimea crește numărul de transformări, nu inteligența garantată. Arhitectura ar trebui să reflecte modalitatea, volumul de date, latența, memoria și invarianțele sarcinii. Un model convoluțional mai mic poate depăși un transformer când datele sunt limitate și structura spațială locală domină.
Antrenarea calculează o pierdere, o diferențiază cu propagarea înapoi și actualizează parametrii cu un optimizer, cum ar fi gradientul descendent stochastic sau Adam. Dimensiunea batch‑ului, rata de învățare, programarea, inițializarea, regularizarea și precizia numerică interacționează. Curbele pentru pierderea de antrenare și validare ajută la distingerea sub‑încadrării, suprapuneri, instabilității și scurgerii, dar nu stabilesc utilitatea în lumea reală. Folosiți date de evaluare independente, rulări repetate când variabilitatea contează, ablații și comparații cu linii de bază mai simple. Numărul mare de parametri crește, de asemenea, necesitatea guvernanței datelor, planificării compute‑ului și configurării reproductibile.
Servirea modelelor profunde în siguranță și eficiență
Implementarea poate folosi un punct final găzduit, un accelerator dedicat, browser, telefon sau dispozitiv încorporat. Exportul și compilarea pot fuziona operatori, cuantiza greutăți și activări sau modifica comportamentul numeric, așa că validați artefactul implementat, nu doar punctul de control al antrenamentului. Măsurați pornirea rece, latența constantă, debitul, memoria, consumul de energie și calitatea la dimensiuni realiste de batch și secvență. Metodele de comprimare — tăiere, distilare, cuantizare și adaptare de rang scăzut — fac un compromis între dimensiune sau viteză și acuratețe și complexitatea ingineriei și trebuie evaluate pe clase sensibile și cazuri limită.
Modelele profunde pot eșua cu încredere în fața schimbărilor de distribuție, intrărilor adversariale, corelațiilor spurioase și grupurilor prost reprezentate. Monitorizați distribuțiile de intrare și ieșire, rezultatele sarcinii, calibrarea, consumul de resurse și versiunile dependențelor. Utilizați control de acces, artefacte semnate, date de antrenament protejate, red‑team‑ing și limite de rată adecvate modelului de amenințare. Explicațiile, cum ar fi hărțile de saliență sau vizualizările de atenție, sunt dovezi diagnostice, nu dovezi de cauzalitate. Combinați-le cu teste comportamentale, contra‑factuale, revizuire umană, răspuns la incidente și limite explicite ale deciziilor automate.
Exemplu practic: antrenarea unui detector de defecte în imagini
O fabrică colectează imagini ale produselor din diverse camere, schimburi, materiale și clase de defecte cunoscute, apoi împarte datele pe loturi de producție astfel încât elementele aproape duplicate să nu poată traversa partițiile. Un baseline convoluțional mic este comparat cu o rețea profundă pre‑antrenată. Augmentarea reproduce variații validate de iluminare și unghi de vizualizare fără a șterge defectele. Evaluarea raportează recall per defect, rată de respingere falsă, calibrare, latență de inferență și robustețe la neclaritate, reflexii, înlocuirea camerei și culori rare ale materialului.
Modelul exportat și codul exact de redimensionare, culoare și normalizare sunt testate pe hardware‑ul liniei pentru debit susținut și comportament termic. Cazurile cu încredere scăzută sunt trimise la inspectori; o regulă independentă oprește linia în caz de defecțiune a senzorului critic pentru siguranță. Imaginile sunt păstrate doar în conformitate cu permisiunile și artefactele modelului sunt semnate. Monitorizarea leagă predicțiile de rezultatele ulterioare ale inspecției și loturile de producție. O cameră sau un material nou declanșează o reevaluare controlată în loc de învățarea online silențioasă din etichete neverificate.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți un baseline reproductibil și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții limită, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare abuzivă și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag pentru ca un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, rollback și retragere. Utilizați o lansare etapizată, păstrați o revenire sigură și verificați monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem menținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Referințe principale












