
Fundamentele AI
Ce sunt RNN-urile și LSTM-urile în învățarea profundă?

 Adaugă Unite.AI la sursele tale preferate pe Google
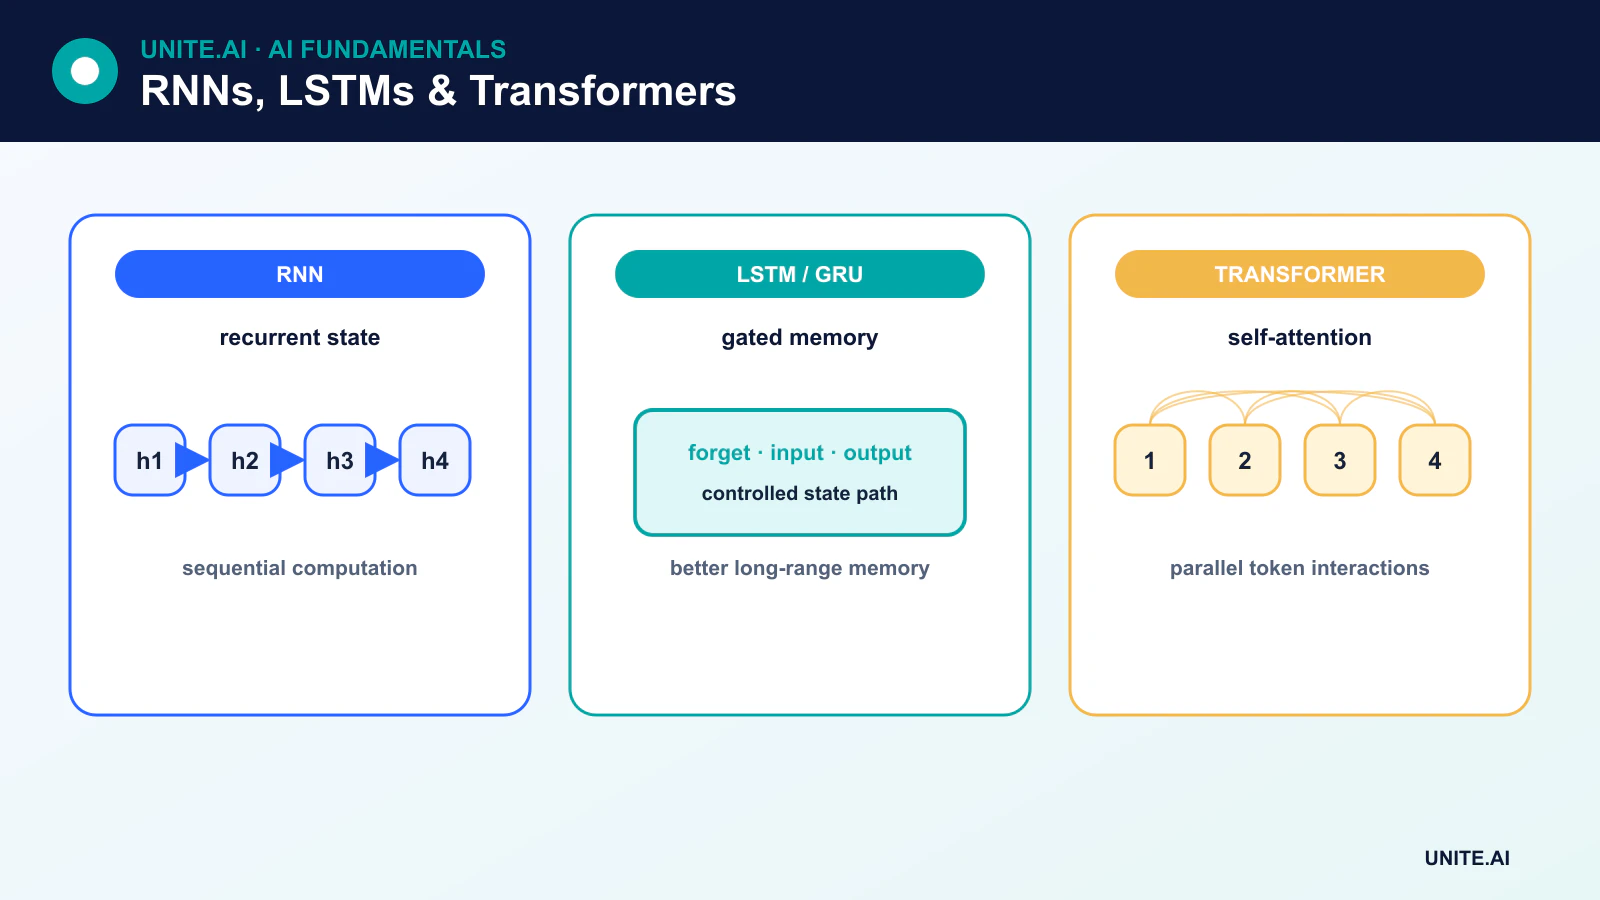
Rețelele neuronale recurente (RNN-uri) procesează secvențe prin actualizarea unei stări ascunse în timp. Rețelele cu memorie pe termen scurt (LSTM) sunt RNN-uri cu porți (gated) concepute pentru a păstra și controla informația mult mai eficient decât o unitate recurentă de bază.
RNN-urile și LSTM-urile au dominat odată numeroase sarcini lingvistice, dar chatbot-urile mari moderne se bazează în principal pe transformere. Modelele recurente rămân utile pentru fluxuri în timp real, serii temporale, vorbire, control și sisteme cu resurse limitate, unde starea incrementală și latența scăzută sunt importante.
Aspecte cheie
- Un RNN reutilizează aceiași parametri la fiecare pas al secvenței și transmite în față o stare ascunsă.
- Antrenarea în timp poate genera gradienti care dispar (vanishing) sau explodează.
- Un LSTM adaugă o stare de celulă și porți de intrare, uitare și ieșire.
- Transformerele gestionează relațiile pe distanțe mari și antrenamentul paralel diferit; niciuna dintre arhitecturi nu este cea mai bună pentru fiecare implementare.
Cum funcționează un RNN de bază
La pasul t, o unitate recurentă simplă combină intrarea curentă xₜ cu starea ascunsă anterioară hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Starea ascunsă este un rezumat învățat utilizat pentru pasul următor și, în funcție de sarcină, ca ieșire. O diagramă „desfășurată” (unrolled) arată o copie pentru fiecare pas de timp, dar toate copiile împărtășesc parametrii. Ieșirea nu este pur și simplu copiată înapoi ca o nouă intrare brută; recurența transmite starea ascunsă printr-o transformare definită.
Propagarea înapoi prin timp
RNN-urile sunt antrenate cu propagarea înapoi prin timp (BPTT). Secvența desfășurată formează un graf computațional adânc, iar propagarea înapoi calculează cum depinde pierderea de parametrii recurenti partajați.
Multiplicarea repetată poate face ca gradientii să scadă spre zero sau să crească fără limită. Gradientii care dispar împiedică învățarea dependențelor pe termen lung; gradientii care explodează generează actualizări instabile. Tăierea gradientului (gradient clipping) rezolvă gradientii explozivi, în timp ce porțile, inițializarea, normalizarea și ferestrele de antrenament mai scurte pot ajuta.
În interiorul unei celule LSTM
Un LSTM menține un stare de celulă cₜ pe lângă starea ascunsă hₜ. Porțile sale sunt controale învățate, dependente de date:
- Porțile de uitare controlează câtă parte a stării de celulă anterioare este păstrată.
- Porțile de intrare controlează câtă informație candidată este scrisă.
- Porțile de ieșire controlează câtă informație a celulei contribuie la starea ascunsă.
Ieșirile sigmoid între zero și unu acționează ca porți moi, în timp ce un candidat transformat prin tanh furnizează conținut nou. Calea aditivă a stării de celulă ajută la persistența gradientilor, dar LSTM-urile nu garantează memorie nelimitată sau elimină toate problemele de optimizare.
GRU-uri și recurență bidirecțională
O unitate recurentă cu porți (GRU) combină mecanismele de poartă într-o celulă recurentă mai simplă, fără o stare de celulă separată în stil LSTM. GRU-urile pot fi antrenate mai rapid și pot performa similar în unele sarcini.
Un RNN bidirecțional procesează o secvență completă în ambele direcții și combină stările. Poate folosi contextul viitor pentru etichetare sau codare, dar nu este adecvat pentru fluxuri cauzale când intrările viitoare nu sunt încă disponibile.
Modele secvență-la-secvență
RNN-urile encoder-decoder mapă o secvență pe alta. Atenția a fost introdusă pentru a permite unui decodor să consulte diferite stări ale encoder-ului în loc să se bazeze pe un singur vector fix. Această linie de cercetare a condus la arhitectura transformer, care a înlocuit recurența cu blocuri bazate pe atenție.
RNN-uri versus transformere
Transformerele procesează pozițiile de antrenament în paralel și creează căi scurte de atenție între token-uri îndepărtate. RNN-urile procesează starea secvențial, limitând paralelismul, dar oferind o stare recurentă de dimensiune constantă în timpul fluxului. Inferența cu transformere poate necesita un cache în creștere de chei-valori, în timp ce un RNN comprimă istoricul în starea sa ascunsă și poate pierde detalii.
Alegeți în funcție de lungimea secvenței, dimensiunea datelor, hardware, latență, memorie și dacă sarcina este offline sau în flux. Arhitecturile hibride și cele de tip state-space oferă compromisuri suplimentare.
Cazuri de utilizare curente
RNN-urile și LSTM-urile rămân relevante pentru prognoză, detectarea anomaliilor, procesarea senzorilor, componente de vorbire, scriere de mână, control încorporat și modelarea secvențelor cu latență scăzută. Ele nu sunt explicația implicită pentru modelele lingvistice mari actuale sau pentru chatbot-urile AI.
Recurență, porți și memorie de secvență
O rețea neuronală recurentă procesează o secvență prin combinarea intrării curente cu o stare ascunsă transportată din pașii precedenți. Greutățile partajate permit lungimi variabile ale secvenței, iar desfășurarea expune calculul în timp pentru antrenament. RNN-urile de bază pot reprezenta dependențe temporale, dar gradientii multiplicați repetat pe secvențe lungi tind să dispară sau să explodeze. Propagarea înapoi trunchiată limitează memoria și calculul, în timp ce tăierea gradientului controlează actualizările extreme. Starea ascunsă este un rezumat învățat, nu o stocare fidelă a fiecărui token anterior.
Rețelele cu memorie pe termen scurt (LSTM) adaugă o stare de celulă și porți de intrare, uitare și ieșire care reglează scrierea, păstrarea și expunerea informației. Unitățile recurente cu porți (GRU) utilizează o structură mai simplă de resetare și actualizare. Variantele bidirecționale folosesc contextul viitor și, prin urmare, nu pot fluxa cauzal fără întârziere. Modelele recurente stivuite, reziduale și augmentate cu atenție adaugă capacitate. Umplerea (padding) și măștile trebuie să împiedice elementele artificiale ale secvenței să influențeze starea sau pierderea, iar starea ar trebui resetată la limitele reale ale secvenței pentru a evita scurgerile între exemple.
Antrenament, comparație și servire cu stare
RNN-urile și LSTM-urile rămân utile pentru fluxuri în timp real, modele compacte pe dispozitiv, serii temporale și sarcini unde starea secvențială este eficientă. Transformerele paralelizează antrenamentul și modelează interacțiunile pe distanțe mari diferit, dar pot necesita memorie și cache mai mari. Comparați arhitecturile în funcție de acuratețe, latență, debit, memorie, consum și performanță pe măsură ce lungimea secvenței se modifică. Evaluați prognoza cu diviziuni temporale rulante, limbajul cu metrici sensibile la secvență și detectarea anomaliilor cu măsuri la nivel de eveniment. Examinați eșecurile după intervale lungi, schimbări de regim, mostre lipsă și limite de secvență bruște.
Implementarea cu stare trebuie să asocieze starea ascunsă cu sesiunea corectă, să o expire, să o cripteze dacă este sensibilă și să o reseteze după erori sau modificări ale modelului. Evenimentele în afara ordinii sau duplicate pot corupe starea; includeți marcaje temporale, numere de secvență și idempotentă. Monitorizați vârsta stării, lungimea secvenței, lipsurile, deriva ieșirii și latența. Cuantizarea necesită validare sensibilă la porți, deoarece mici modificări numerice se pot acumula în timp. Memoria RNN permite context, dar poate păstra și informații private sau învechite, astfel că retenția și controalele utilizatorului trebuie integrate în proiectare.
Exemplu practic: un LSTM pentru secvențe de senzori în flux
Un utilitar folosește un LSTM pentru a prognoza sarcina pe termen scurt pe baza măsurătorilor recente, calendarului și vremii. Secvențele sunt construite cu o ordine strictă în timp; starea ascunsă se resetează la limitele alimentatorului, iar umplerea este mască. Bazele naive sezoniere și cele bazate pe gradient boosting sunt comparate cu LSTM-ul pe ferestre rulante. Testele acoperă intervale lipsă, vreme întârziată, sărbători, pene de curent și lungimi de secvență peste cele tipice de antrenament.
Serviciul de flux asociază starea cu un singur alimentator, respinge duplicatele în afara ordinii și expiră starea după intervale lungi sau actualizări ale modelului. O prognoză statistică sigură înlocuiește ieșirea când senzorii sau starea sunt invalide. Inferența cuantizată este verificată pe secvențe lungi pentru deriva acumulată. Monitorizarea urmărește vârsta stării, lipsurile, latența, biasul și eroarea de interval. Modelul este re-antrenat doar după modificări ale rețelei și rezultatele revizuite arată că relațiile temporale învățate nu mai generalizează.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, responsabilul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare incorectă și grupurile sau mediile cel mai probabil neacoperite. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o implementare în etape, păstrați o alternativă sigură și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil pentru răspuns, apoi revizuiți dovezile din viața reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și retenție, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Este un LSTM întotdeauna mai bun decât un RNN de bază?
Nu. Porțile ajută la multe probleme de dependență pe termen lung, dar adaugă calcule și parametri. Un RNN de bază poate fi adecvat pentru secvențe scurte și simple, iar o altă arhitectură poate fi mai potrivită pentru contexte foarte lungi.
Poate un LSTM să proceseze o istorie nelimitată?
Nu. Starea sa are o capacitate finită, gradientii și datele de antrenament impun limite, iar detaliile relevante pot fi suprascrise. Performanța pe contexte lungi trebuie măsurată, nu dedusă din denumirea arhitecturii.
Referințe principale












