Fundamentele AI
Ce este învățarea automată?

 Adaugă Unite.AI la sursele tale preferate pe Google
Învățarea automată (ML) este o ramură a inteligenței artificiale în care un sistem învață modele din date pentru a putea face predicții, clasificări, recomandări sau decizii fără ca un dezvoltator să scrie o regulă separată pentru fiecare caz posibil. Rezultatul nu este o mașină care „gândește” ca o persoană. Este un model statistic care asociază intrările cu ieșiri utile și poate fi evaluat pe date pe care nu le-a văzut în timpul antrenamentului.
Învățarea automată se încadrează în domeniul mai larg al AI, în timp ce învățarea profundă este o familie de metode de învățare automată construite în jurul rețelelor neuronale cu mai multe straturi. Această distincție contează: nu fiecare sistem AI folosește ML și nu fiecare problemă de ML necesită o rețea neuronală.
Aspecte cheie
- ML învață o relație din exemple, în loc să se bazeze doar pe reguli scrise manual.
- Un model util trebuie să se generalizeze la date noi, nu doar să memoreze setul de antrenament.
- Învățarea supervizată, nesupervizată, semi‑supervizată, auto‑supervizată și învățarea prin recompensă rezolvă tipuri diferite de probleme.
- Calitatea datelor, designul evaluării și monitorizarea sunt la fel de importante ca algoritmul.
Cum funcționează învățarea automată
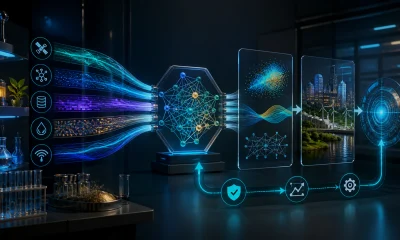
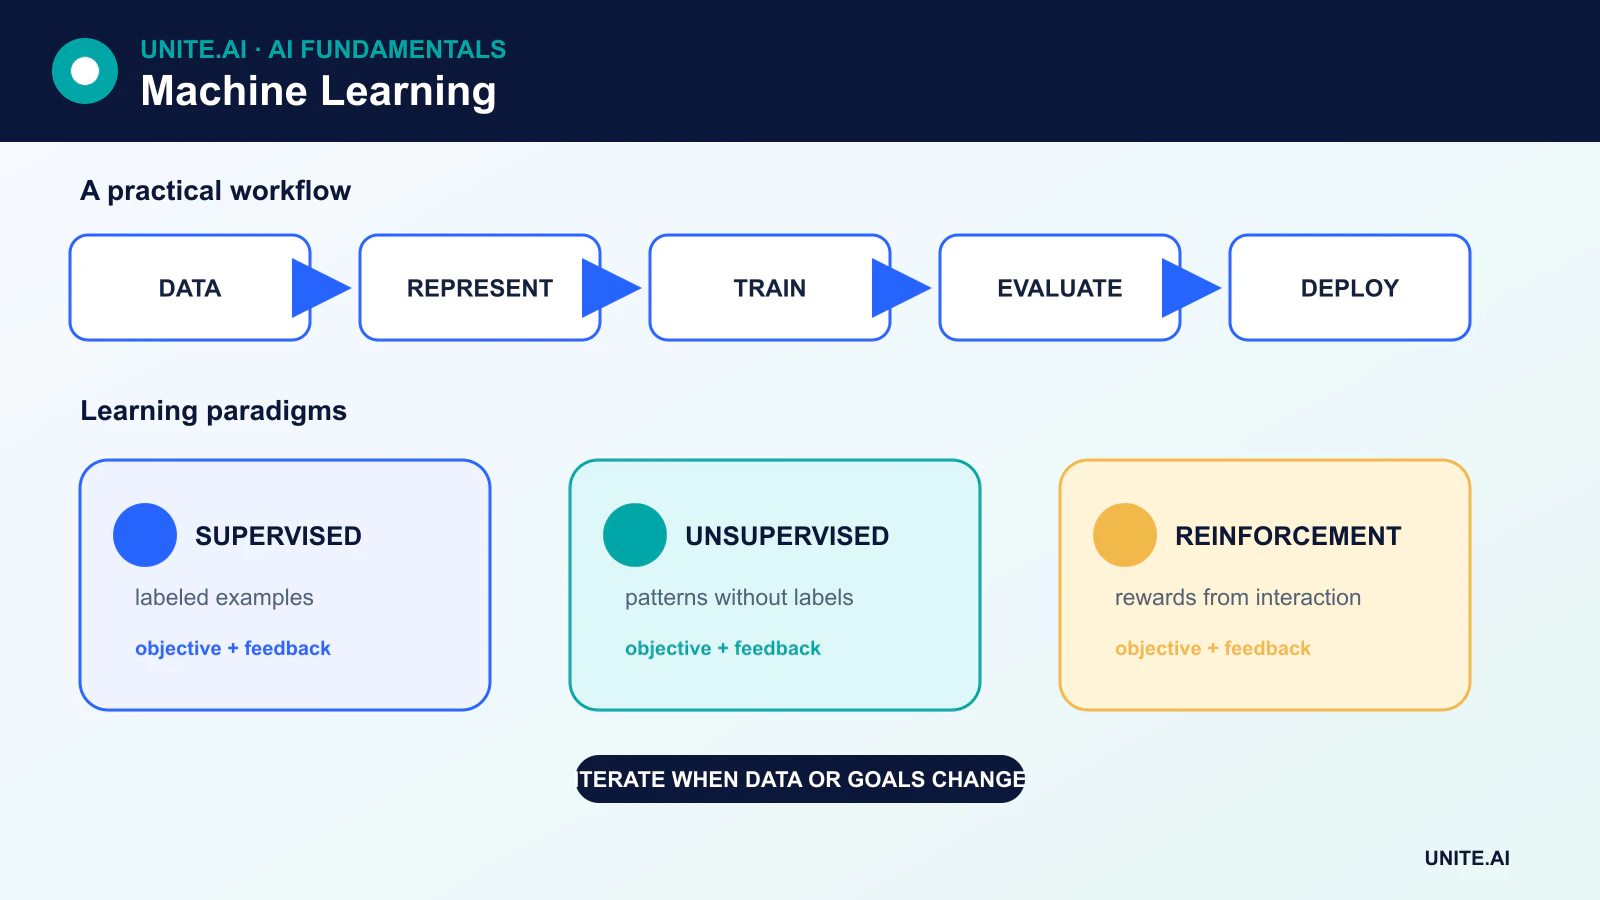
Majoritatea proiectelor de ML pot fi înțelese ca o succesiune de șase etape:
- Definește sarcina. Decide ce ar trebui să prezică sau să descopere sistemul și ce înseamnă succesul în aplicația reală.
- Colectează și pregătește datele. Curăță înregistrările, gestionează valorile lipsă, creează caracteristici utile și documentează sursa datelor.
- Împarte datele. Un set de antrenament este folosit pentru a ajusta modelul, un set de validare ajută la selectarea parametrilor, iar un set de testare oferă o estimare finală pe date neatinse.
- Antrenează modelul. Un algoritm ajustează parametrii modelului pentru a reduce o funcție de pierdere sau pentru a satisface un alt obiectiv de învățare.
- Evaluează generalizarea. Metriile trebuie să reflecte sarcina, echilibrul claselor, costurile erorilor și populația pe care modelul va opera.
- Implementează și monitorizează. Datele din lumea reală pot varia, astfel încât echipele să monitorizeze driftul, degradarea performanței, părtinirea și defecțiunile operaționale.
Variabilele furnizate unui model sunt denumite în mod obișnuit caracteristici. În învățarea supervizată, răspunsul dorit se numește etichetă sau țintă. Parametrii învățați de model codifică o relație între caracteristici și ieșire; ei nu reprezintă o bază de date de reguli explicite.
Principalele paradigme de învățare
Învățare supervizată
În învățarea supervizată, exemplele includ atât intrări, cât și ținte cunoscute. Un model de clasificare prezice categorii, cum ar fi dacă o tranzacție este frauduloasă. Un model de regresie prezice o valoare continuă, cum ar fi cererea de energie așteptată.
Algoritmi supervizați comuni includ arbori de decizie, mașini cu vectori de susținere, vecinii cei mai apropiați K, regresie liniară și logistică, arbori cu gradient boost, și rețele neuronale. Un prag de clasificare, cum ar fi 0,5, este o decizie aleasă după ce modelul generează un scor sau o probabilitate; nu este o proprietate imuabilă a regresiei logistice.
Învățare nesupervizată
Învățarea nesupervizată lucrează cu date care nu includ etichete țintă. Obiectivul poate fi găsirea de grupuri, detectarea de observații neobișnuite, estimarea unei distribuții sau crearea unei reprezentări cu dimensiuni reduse. Un cluster este un grup sugerat de o regulă de similaritate; nu este automat o clasă semnificativă în lumea reală.
Exemple includ clusterizarea K-means, analiza componentelor principale, estimarea densității și unele forme de autoencodere. Un autoencoder învață să reconstruiască intrarea printr-o reprezentare comprimată. Nu creează automat etichete de adevăr.
Învățare semi‑supervizată și auto‑supervizată
Învățarea semi‑supervizată combină un set de date mic etichetat cu un set de date mai mare neetichetat. Învățarea auto‑supervizată creează un semnal de antrenament din datele în sine—de exemplu, prezicerea cuvintelor mascate sau potrivirea a două viziuni transformate ale aceleiași imagini. Auto‑supervizarea este esențială pentru multe conducte moderne de transformere și modele de bază, deoarece poate folosi colecții mari de text, imagini, audio sau video fără ca o persoană să eticheteze fiecare exemplu.
Învățare prin recompensă
În învățarea prin recompensă, un agent ia acțiuni într-un mediu și primește recompense sau costuri. Obiectivul este să învețe o politică care să maximizeze recompensa cumulativă așteptată. Acest lucru diferă de învățarea supervizată deoarece acțiunea corectă nu este furnizată pentru fiecare stare, iar o acțiune poate influența ce date întâlnește agentul în continuare.
Antrenament, validare și generalizare
Un model care performează bine pe exemplele de antrenament poate totuși să eșueze pe date noi. Această eroare este cunoscută sub denumirea de overfitting. Echipele o reduc prin capacitate adecvată a modelului, regularizare, validare încrucișată, augmentare de date, prevenirea scurgerilor și un set de testare cu adevărat independent.
Nu există o metrică unică pentru fiecare sarcină de ML. Clasificarea poate necesita precizie, recall, F1, calibrare sau o măsură ponderată pe cost în loc de acuratețea brută. Regresia poate folosi eroarea medie absolută, rădăcina pătrată a erorii medii sau o funcție de pierdere specifică domeniului. Clusterizarea necesită forme diferite de evaluare internă sau validată extern. Metriile ar trebui să reflecte ce înseamnă o eroare pentru utilizator sau organizație.
Algoritmii de învățare automată sunt instrumente, nu garanții
Un algoritm are presupuneri. Modelele liniare presupun o formă particulară de relație. K-nearest neighbors presupune că distanța selectată reprezintă o similaritate semnificativă. Naive Bayes presupune că caracteristicile sunt condiționat independente în raport cu clasa. Arborii de decizie împarte spațiul caracteristicilor utilizând reguli de împărțire învățate; frunzele lor conțin predicții bazate pe grupuri de observații de antrenament, nu neapărat pe o singură observație fiecare.
Alegerea modelului depinde, așadar, de dimensiunea datelor, tipurile de caracteristici, cerințele de latență, nevoile de interpretabilitate și costul greșelilor. Un model mai simplu poate depăși un model mai mare atunci când datele sunt limitate sau constrângerile operaționale favorizează viteza și transparența.
Unde se folosește învățarea automată
ML susține clasificarea în căutări, recomandări, prognoze, detectarea anomaliilor, traducerea, recunoașterea vorbirii, viziunea computerizată, întreținerea predictivă, detectarea fraudei și analiza științifică. Aceleași tehnici pot, de asemenea, amplifica părtinirea istorică, expune informații sensibile sau se pot comporta imprevizibil în fața schimbărilor de distribuție. Implementarea responsabilă necesită documentație, supraveghere umană acolo unde este cazul, testare de securitate și monitorizare continuă.
De la definirea problemei la un experiment valid de învățare automată
Un proiect de învățare automată ar trebui să înceapă cu o decizie și un rezultat măsurabil, nu cu un algoritm. Definește unitatea de predicție, ținta, timpul de observație, timpul de decizie, caracteristicile disponibile și costul fiecărei erori. Pentru un model de churn, de exemplu, utilizarea evenimentelor înregistrate după anulare ar scurge răspunsul. Stabilește o regulă simplă sau un punct de referință statistic, apoi împarte datele în funcție de timp, client, locație sau altă limită care reflectă implementarea. Împărțirile aleatoare pe rânduri pot plasa observații aproape identice în seturile de antrenament și test și pot produce un scor înșelător.
Ingineria caracteristicilor convertește înregistrările brute în reprezentări pe care modelul le poate utiliza, dar fiecare caracteristică necesită proveniență și o garanție de disponibilitate. Aplică normalizarea, vocabularul, imputarea și reducerea dimensională doar pe datele de antrenament, apoi aplică transformarea învățată pe datele de validare și test. Validarea încrucișată estimează variația între eșantioane; un set final de testare neatins susține decizia de lansare. Selectează metrici în funcție de consecințe: precizie și recall pentru erori de clasificare inegale, calibrare când probabilitățile conduc la acțiune și măsuri ponderate pe cost sau utilitate când greșelile au efecte operaționale diferite.
Implementare, monitorizare și operare responsabilă
Inferența în producție repetă transformarea completă de la timpul de antrenament și returnează o predicție sub constrângerile de latență, debit și disponibilitate. Împachetează preprocesarea cu modelul, validează schemele de intrare, versionează artefactele și compară rezultatele între implementările offline și cele de servire. Alege un prag utilizând capacitatea operațională și compromisurile de eroare în loc să folosești implicit 0,5. Lansează prin evaluare shadow, un cohort limitat sau un experiment cu metrici de protecție. Păstrează un fallback determinist și o cale de rollback pentru eșecuri de dependență sau comportament inacceptabil.
Monitorizează calitatea intrărilor, driftul caracteristicilor, distribuția predicțiilor, calibrarea, rezultatele subgrupurilor, latența, costul și etichetele confirmate când acestea sosesc. Driftul este un semnal de investigat, nu o dovadă automată că reantrenarea va ajuta. Reantrenarea necesită date revizuite, teste repetabile, aprobare și comparare cu campionul curent. Documentează utilizările intenționate și nevalide, drepturile asupra datelor, confidențialitatea, securitatea, intervenția umană și căile de apel unde oamenii sunt afectați. Învățarea automată este un sistem de decizie întreținut; fișierul modelului este doar o componentă înlocuibilă.
Exemplu practic: prezicerea defectării echipamentelor
Un producător definește o predicție pe mașină‑zi: dacă va avea loc o defecțiune verificată în decurs de șapte zile, utilizând doar telemetria disponibilă la începutul zilei respective. Împarte datele pe mașină și timp, compară cu reguli bazate pe vârstă și praguri, aplică preprocesarea pe datele de antrenament și evaluează recall‑ul evenimentelor, alertele false, timpul de avertizare, calibrarea și capacitatea de întreținere. Înlocuirea senzorilor și opririle planificate sunt modelate ca context operațional, nu ca observații obișnuite.
Modelul rulează mai întâi în modul shadow. Alertele afișează telemetria contributivă și incertitudinea, dar mentenanții decid dacă să inspecteze. Constatările și cauzele confirmate devin etichete guvernate; absența unei comenzi de lucru nu se presupune că înseamnă că nu există defecțiune. O lansare etapizată folosește limite de alertă și un fallback manual, în timp ce monitorizarea urmărește starea senzorilor, driftul intrărilor, precizia revizuită, timpul de nefuncționare și întreținerea inutilă. Reantrenarea are loc numai după ce revizuirea datelor și a pragurilor demonstrează o îmbunătățire probabilă față de sistemul implementat curent.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definește utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabilește o bază reproducibilă și un set de evaluare versionat înainte de ajustare. Testează cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare greșită și grupurile sau mediile cel mai probabil subreprezentate. Măsoară calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrează fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuie autoritatea pentru eliberare, excepții, modificări, rollback și retragere. Folosește o lansare etapizată, păstrează un fallback sigur și verifică monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definește pragurile de alertă și responsabilul pentru răspuns, apoi revizuiește dovezile din viața reală după implementare în loc să presupui că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, recuperare documentată, învățare din incidente, proceduri de ștergere și păstrare și un punct clar la care să fie dezactivat sau înlocuit.
Referințe primare