
Fundamentele AI
Ce este învățarea prin recompensă?

 Adaugă Unite.AI la sursele tale preferate pe Google
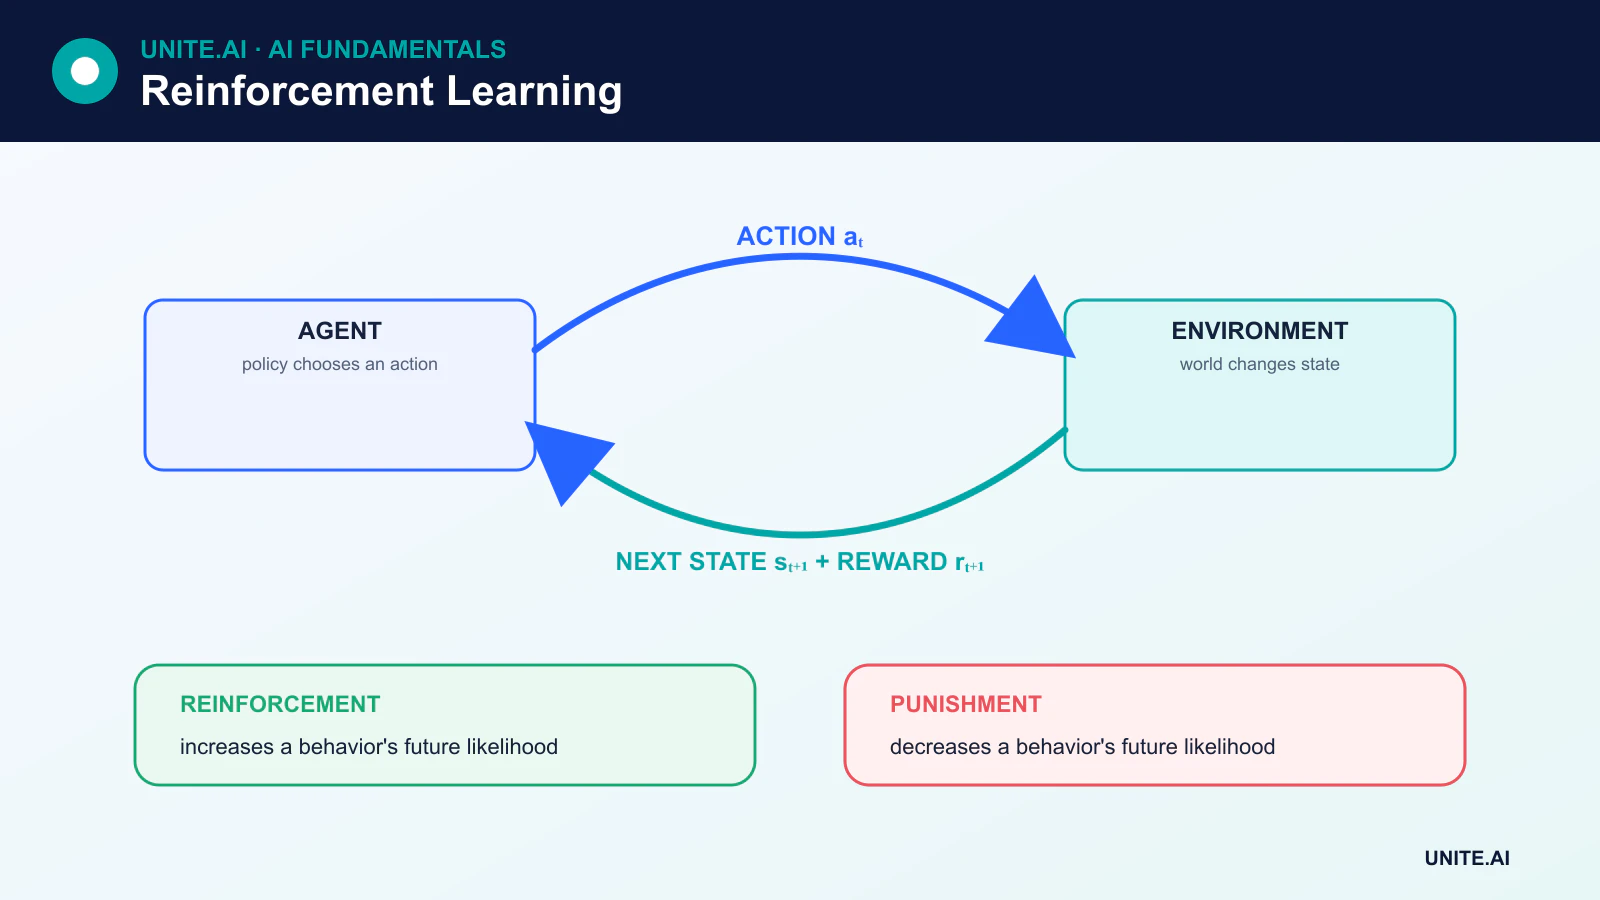
Învățarea prin recompensă (RL) este un cadru de învățare automată în care un agent învață cum să acționeze prin interacțiunea cu un mediu. După fiecare acțiune, mediul se modifică și poate oferi o recompensă. Obiectivul agentului este să învețe o politică care să maximizeze recompensa cumulativă așteptată, nu doar recompensa pentru următoarea mișcare.
Învățarea prin recompensă este utilizată când deciziile se desfășoară în timp și o acțiune influențează ce se întâmplă în continuare. Este conceptual diferită de învățarea supravegheată, în care un set de date furnizează un răspuns țintă pentru fiecare exemplu de antrenament.
Aspecte cheie
- O problemă de învățare prin recompensă conține un agent, un mediu, stări, acțiuni, recompense și o politică.
- Recompensa pozitivă și cea negativă ambele cresc comportamentul; pedeapsa îl scade.
- Agentul trebuie să echilibreze explorarea acțiunilor necunoscute cu exploatarea acțiunilor deja cunoscute ca fiind eficiente.
- Metodele bazate pe valoare, pe politică, actor‑critic, bazate pe model și offline rezolvă diferite scenarii de învățare prin recompensă.
Componentele învățării prin recompensă
Multe probleme de învățare prin recompensă sunt modelate ca un proces de decizie Markov (MDP). Un MDP include:
- Stare: informații care descriu situația curentă.
- Acțiune: o alegere disponibilă agentului.
- Tranziție: modul în care starea se modifică după o acțiune.
- Recompensă: feedback imediat generat de o tranziție.
- Politică: strategia agentului pentru selectarea acțiunilor.
- Factor de discount: cât de mult contează recompensele viitoare în raport cu cele imediate.
O stare nu trebuie să expună totul despre lume. Când informații importante sunt ascunse, problema poate fi parțial observabilă și agentul poate avea nevoie de o memorie sau de o stare de credință.
Recompensa nu este același lucru cu pedeapsa
Terminologia provine din psihologia comportamentală. Recompensa pozitivă adaugă o consecință care face ca un comportament să fie mai probabil. Recompensa negativă elimină o condiție neplăcută și, de asemenea, face ca un comportament să fie mai probabil. O penalizare menită să facă o acțiune mai puțin probabilă este pedeapsa, nu recompensa negativă.
În învățarea automată, practicienii vorbesc mai des direct despre recompense pozitive, recompense negative, costuri și penalizări. Problema esențială este cum aceste semnale modelează rentabilitatea pe care agentul încearcă să o maximizeze.
Rentabilitate, valoare și atribuirea creditului
O recompensă descrie o tranziție. Rentabilitatea combină recompensele în timp, de obicei discountând recompensele care apar mai târziu în viitor. O funcție de valoare a stării estimează rentabilitatea așteptată dintr-o stare, în timp ce o funcție de valoare a acțiunii estimează rentabilitatea așteptată după ce se ia o anumită acțiune în acea stare.
Acest lucru creează problema atribuirii creditului: dacă un rezultat util apare mult mai târziu, care acțiuni anterioare merită credit? Algoritmii de învățare prin recompensă diferă în modul în care estimează această relație.
Învățarea Monte Carlo și diferențială în timp
Metodele Monte Carlo învață din rentabilități eșantionate complete, de obicei după încheierea unui episod. Metodele diferențiale în timp (TD) actualizează o estimare înainte de rezultatul final combinând recompensa observată cu o estimare a ceea ce urmează. Învățarea TD pornește astfel de la estimările sale curente de valoare.
Niciuna dintre familii nu este universal superioară. Țintele Monte Carlo sunt neînclinate sub politica eșantionată, dar pot avea variabilitate ridicată și necesită finalizarea episodului. Metodele TD pot învăța online și din sarcini continue, dar țintele lor bootstrap introduc un bias.
Explorare versus exploatare
Explorarea adună informații prin încercarea de acțiuni a căror valoare este incertă. Exploatarea selectează acțiunea considerată în prezent cea cu cea mai bună rentabilitate. Un agent care nu explorează niciodată poate adopta o strategie slabă; un agent care nu exploatează niciodată nu profită de ceea ce a învățat.
Strategii simple includ selecția de acțiuni epsilon‑greedy, explorarea bazată pe încredere, bonusuri de entropie și metode de recompensă intrinsecă. În medii critice pentru siguranță, explorarea nelimitată poate fi inacceptabilă, astfel că simularea, constrângerile, datele offline sau supravegherea umană devin importante.
Principalele abordări ale învățării prin recompensă
Metode bazate pe valoare
Q‑learning și algoritmi înrudiți învață valori ale acțiunilor și derivă o politică prin selectarea acțiunilor cu valoare ridicată. Învățarea profundă prin recompensă folosește rețele neuronale pentru a aproxima funcțiile de valoare sau politicile când spațiile de stare sunt prea mari pentru un tabel.
Metode gradient de politică
Metodele gradient de politică ajustează direct o politică parametrizată pentru a îmbunătăți rentabilitatea așteptată. Sunt utile pentru acțiuni continue și politici stocastice, dar pot avea estimări de gradient cu variabilitate ridicată.
Metode actor‑critic
Un actor alege acțiuni în timp ce un critic estimează valoarea și furnizează un semnal de învățare. Aceasta combină optimizarea directă a politicii cu estimarea valorii.
Învățare prin recompensă bazată pe model și fără model
Sistemele bazate pe model învață sau utilizează un model al tranzițiilor și recompenselor pentru a putea planifica. Sistemele fără model învață valori sau politici fără a modela explicit mediul. Metodele bazate pe model pot folosi experiența eficient, dar erorile din modelul învățat pot induce în eroare planificarea.
Învățare prin recompensă offline
Învățarea prin recompensă offline învață dintr-un set de date fix, în loc să colecteze noi interacțiuni în timpul antrenamentului. Poate reduce costul sau riscul explorării, dar agentul trebuie să evite supraestimarea acțiunilor slab reprezentate în date.
RLHF și preferințele umane
Învățarea prin recompensă din feedback uman (RLHF) folosește date de preferință pentru a antrena un semnal de recompensă sau pentru a optimiza direct o politică. A fost utilizată pentru a alinia comportamentul modelelor de limbaj cu judecățile umane. Optimizarea preferințelor nu garantează adevărul sau siguranța: rezultatele depind de cine a furnizat feedback‑ul, ce i s‑a cerut să evalueze și cum a fost conceput obiectivul.
Limitări
Învățarea prin recompensă poate necesita un număr enorm de interacțiuni, poate avea un comportament instabil în timpul antrenamentului și poate exploata scurtături neintenționate într‑o funcție de recompensă. Evaluarea este dificilă deoarece rezultatele pot varia în funcție de semințele aleatoare și detaliile mediului. Practicile solide includ rulări multiple, linii de bază transparente, obiective constrainte, testare în afara distribuției și monitorizare pentru manipularea recompenselor.
Proiectarea unei probleme de învățare prin recompensă: stare, acțiune, recompensă și orizont
Învățarea prin recompensă modelează decizii secvențiale. Mediul produce o observație, agentul selectează o acțiune conform unei politici, iar o tranziție generează o recompensă și următoarea observație. Un proces de decizie Markov presupune că starea conține informațiile necesare pentru a prezice tranzițiile și recompensele viitoare; parțiala observabilitate necesită memorie, stare de credință sau reprezentări recurente. Discountarea controlează ponderea rezultatelor întârziate, în timp ce sarcinile episodice și continue necesită definiții diferite ale rentabilității. Un design prost al stării sau al acțiunii poate face un obiectiv rezolvabil imposibil de învățat.
Proiectarea recompensei specifică comportamentul indirect și este o sursă majoră de eșec. Un proxy poate fi exploatat: un agent recompensat pentru viteză poate ignora siguranța, în timp ce unul recompensat doar la finalizarea sarcinii poate primi un semnal de învățare prea slab. Adăugați constrângeri și reguli de terminare bazate pe cerințe reale, testați sensibilitatea recompensei și inspectați traiectoriile pentru strategii neintenționate. Metodele de explorare echilibrează colectarea informațiilor cu exploatarea cunoștințelor curente. Datele off‑policy pot îmbunătăți eficiența eșantionului, dar nepotrivirea dintre comportament și politica țintă necesită algoritmi concepuți pentru aceasta.
Evaluare, simulare și implementare sigură
Metodele bazate pe valoare estimează rentabilitatea așteptată pentru stări sau acțiuni; metodele gradient de politică optimizează o politică parametrizată; metodele actor‑critic învață ambele. Învățarea prin recompensă bazată pe model învață sau folosește dinamica tranzițiilor pentru a planifica. Familia adecvată depinde de tipul acțiunii, datele, fidelitatea simulatorului, orizontul și cerințele de stabilitate. Comparați cu linii de bază euristice, supravegheate și din teoria controlului. Evaluați rentabilitatea medie și în cel mai rău caz, încălcările de constrângere, eficiența eșantionului, robustețea la schimbări ale mediului și variabilitatea între semințe, în loc să alegeți o rulare cu cea mai bună curbă de învățare.
Explorarea online poate fi inacceptabilă în domenii precum sănătatea, finanțele, robotică și infrastructura. Antrenați în simulare sau pe date înregistrate acolo unde este posibil, cuantificați diferența dintre simulator și realitate și folosiți evaluarea off‑policy cu grijă, deoarece acțiunile nevăzute nu au suport. Implementarea ar trebui să limiteze acțiunile, rata, resursele și zona de operare; să includă aprobarea umană pentru decizii cu consecințe și să ofere un controler sigur sau oprire de urgență. Monitorizați recompensa alături de rezultatele reale, deoarece un agent poate îmbunătăți scorul în timp ce dăunează obiectivului dorit. Revalidați după modificări ale mediului, politicii sau recompensei.
Exemplu practic: controlul energetic cu învățarea prin recompensă
Un operator de clădire modelează temperatura, ocuparea, vremea, starea echipamentelor și prețul electricității, cu acțiuni limitate la ajustări sigure ale punctului de referință. Recompensa combină confortul, energia, taxele de cerere și constrângerile echipamentelor, dar încălcările reale ale confortului sunt evaluate separat, astfel încât optimizarea recompensei nu poate ascunde daunele. Controlul istoric și controlul predictiv pe model oferă linii de bază. Antrenarea folosește un simulator calibrat cu vreme aleatorie, zgomot de senzor și eficiență a echipamentelor.
Înainte de a influența clădirea, politica rulează pe observații în timp real fără a acționa. Inginerii inspectează traiectoriile, marjele de constrângere și comportamentul în timpul sărbătorilor, valurilor de căldură, penelor de curent și senzorilor lipsă. Implementarea limitează rata și gama acțiunilor și păstrează controlerul de siguranță existent. Un om poate interveni în orice moment. Monitorizarea compară energia și confortul cu perioadele corespunzătoare, înregistrează intervențiile și revine la starea anterioară dacă încălcările, ciclarea neașteptată sau nepotrivirea modelului depășesc pragurile definite.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare incorectă și grupurile sau mediile care ar putea fi subservite. Măsurați calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru lansare, excepții, modificări, rollback și retragere. Utilizați o implementare în etape, păstrați o soluție de rezervă sigură și verificați monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care trebuie dezactivat sau înlocuit.
Referințe principale












