Fundamentele AI
Ce este reducerea dimensională?

 Adaugă Unite.AI la sursele tale preferate pe Google
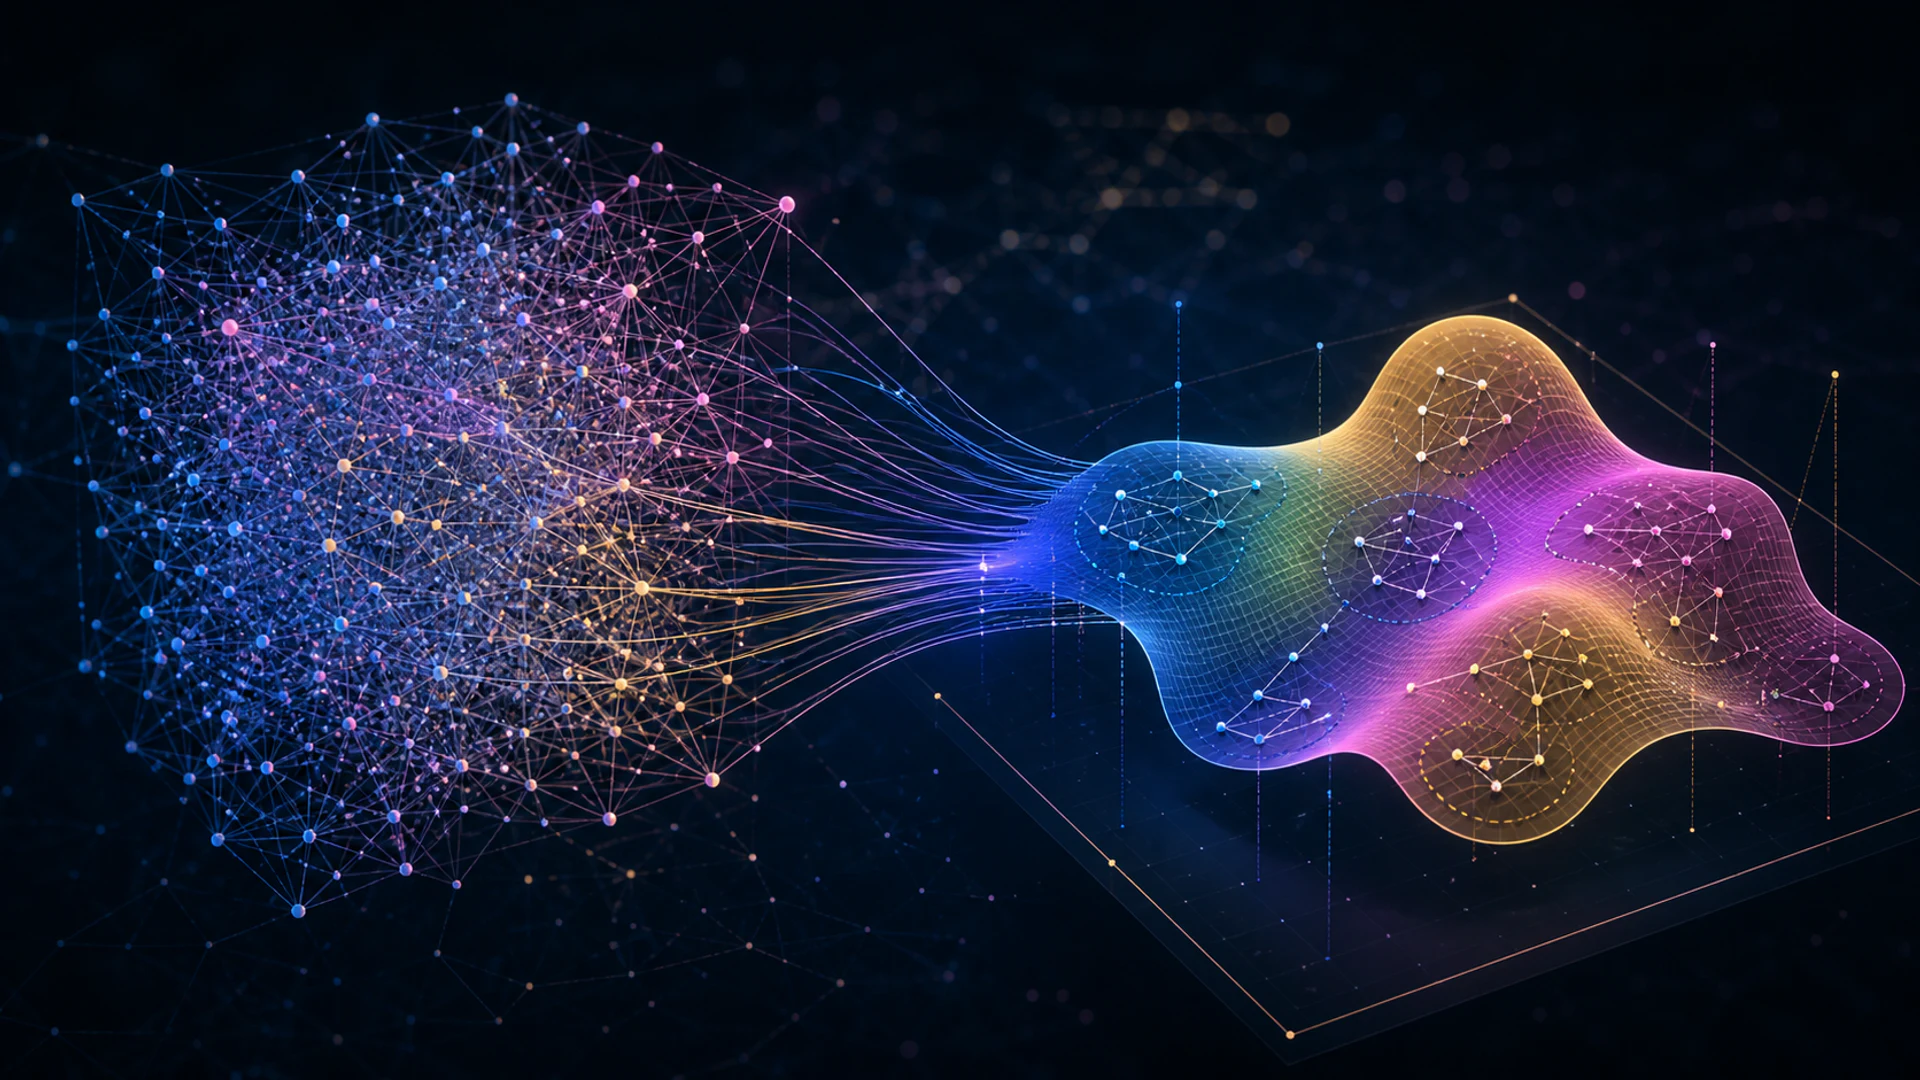
Reducerea dimensională reprezintă datele cu un număr mai mic de variabile, păstrând informațiile utile pentru o sarcină. Poate reduce spațiul de stocare și zgomotul, îmbunătăţi vizualizarea, atenua caracteristicile redundante și face modelele ulterioare mai ușor de antrenat.
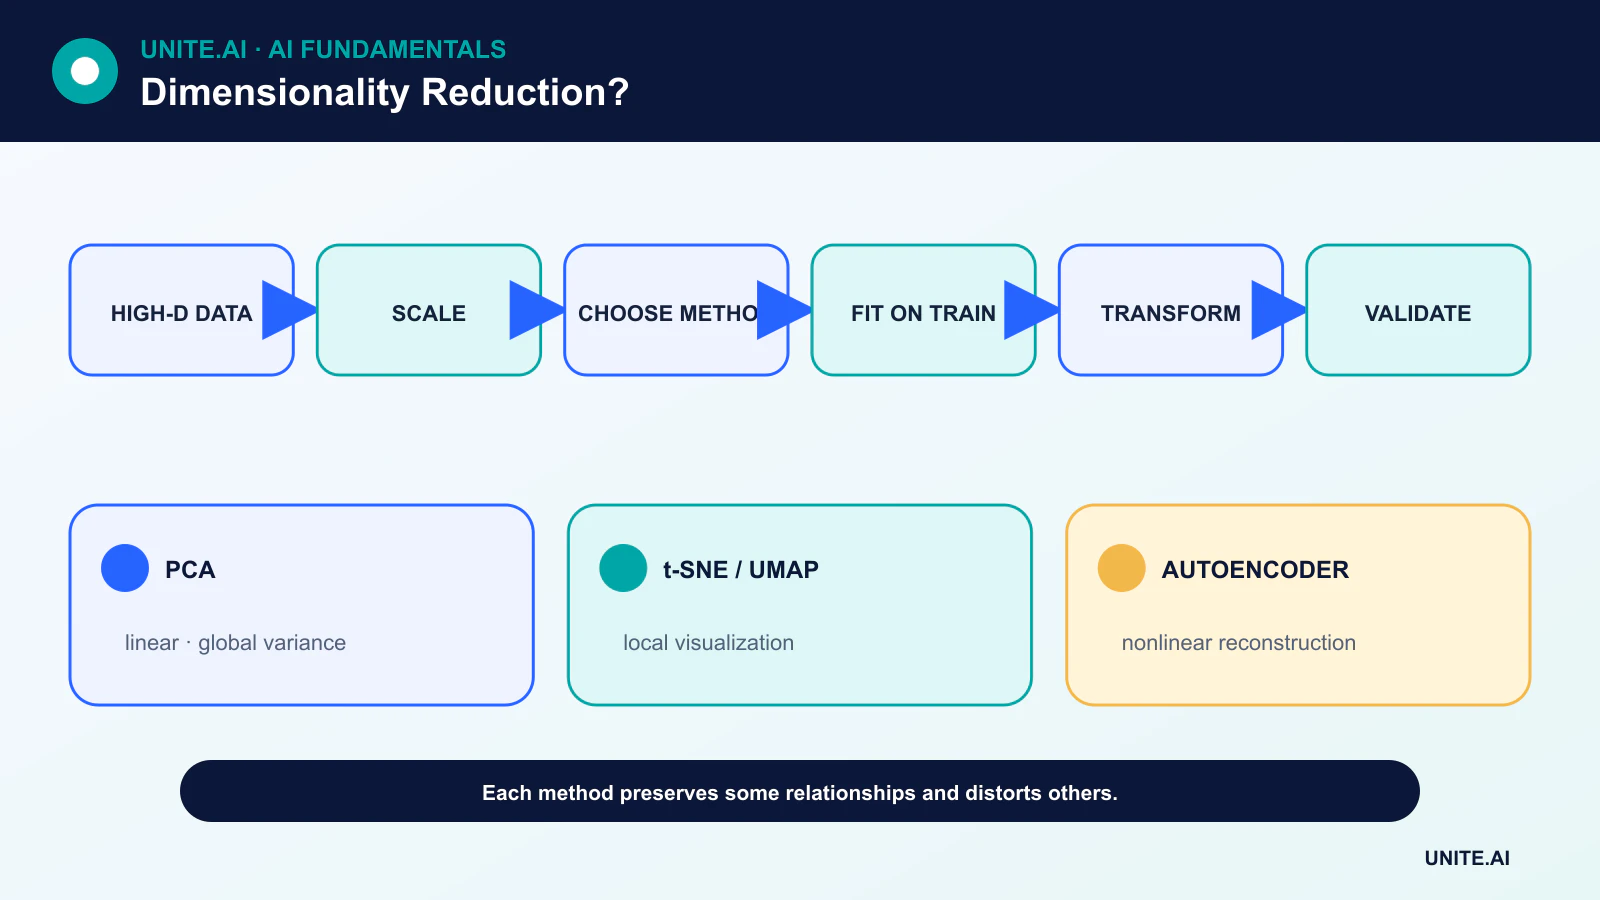
Nicio metodă nu păstrează toate relaţiile. O reducere utilă începe prin a stabili ce ar trebui să supravieţuiască: variaţia, separarea claselor, vecinătăţile locale, geometria globală, calitatea reconstrucţiei sau interpretabilitatea.
Aspecte principale
- Selecţia caracteristicilor păstrează variabilele originale; extragerea caracteristicilor creează noi coordonate cu dimensiune redusă.
- PCA este liniară şi orientată pe variaţie; t‑SNE şi UMAP pun accent pe structura vecinătăţii pentru vizualizare.
- Încărcările pentru vizualizare pot distorsiona distanţele, dimensiunile clusterelor şi separarea globală.
- Antrenează reducerea doar pe datele de antrenament, apoi aplică transformarea învăţată pe datele de validare şi test.
Selecţia caracteristicilor versus proiecţia
Selecţia caracteristicilor elimină variabilele utilizând reguli de domeniu, lipsă de date, redundanţă, teste predictive sau regularizare. Păstrează semnificaţiile originale, ceea ce poate sprijini guvernanţa şi explicarea.
Metodele de proiecţie combină variabilele în noi coordonate. Pot captura structuri distribuite, dar pot face fiecare coordonată mai greu de interpretat. Un autoencoder învaţă o proiecţie neliniară prin reconstrucţie.
PCA şi SVD
Analiza componentelor principale identifică direcţii ortogonale de variaţie descrescătoare după centrare datelor. Decompoziţia în valori singulare oferă o cale numerică comună. Scalarea contează: o unitate de măsură cu variaţie mare poate domina componentele.
PCA este deterministică, cu excepţia semnului şi valorilor proprii repetate, suportă transformarea pe date noi şi furnizează rezumate ale variaţiei explicate. Variaţia mare nu este întotdeauna relevantă pentru sarcină, iar componentele liniare nu pot desfăşura fiecare varietate curbată.
t‑SNE şi UMAP
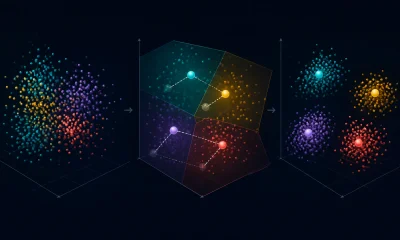
t‑SNE construieşte distribuţii de probabilitate asupra vecinilor şi optimizează o hartă cu dimensiune redusă care accentuează similaritatea locală. UMAP construieşte un graf de vecinătate ponderat şi optimizează o reprezentare cu dimensiune redusă cu obiective legate de structura locală.
Ambele sunt instrumente exploratorii puternice, dar sunt sensibile la preprocesare, metrică de distanţă şi hiperparametri. Spaţiul gol, zona clusterului şi distanţa dintre clustere într-un grafic 2D nu ar trebui să primească automat o interpretare în lumea reală.
Metode supravegheate şi reprezentări conştiente de sarcină
Analiza discriminantă liniară foloseşte etichetele de clasă pentru a căuta separarea, făcând‑o diferită de PCA nesupravegheată. Învăţarea neurală a reprezentărilor poate optimiza obiective de predicţie sau contrastive în loc de reconstrucţie.
Dacă etichetele ghidează reducerea, toate ajustările şi reglajele trebuie să rămână în interiorul procesului de antrenament. În caz contrar, informaţiile din setul de testare pot pătrunde în selecţia modelului şi pot genera un rezultat optimist.
Alegerea şi validarea unei metode
Începe cu preprocesarea şi o bază simplă. Pentru comprimare, măsoară reconstrucţia sau performanţa ulterioară pe diferite dimensiuni. Pentru vizualizare, testează stabilitatea pe diferite seed‑uri şi hiperparametri şi compară păstrarea vecinătăţilor cu cunoştinţele de domeniu.
Pentru producţie, întreabă dacă metoda poate transforma înregistrări noi, cum gestionează valorile lipsă, dacă se modifică la re‑antrenare şi dacă utilizatorii au nevoie de explicaţii ale caracteristicilor originale. Overfitting poate apărea în etapa de reducere la fel ca în modelul final.
Metode de reducere liniare şi neliniare
Reducerea dimensională mapă datele cu dimensiuni mari în coordonate mai puţine, păstrând structura selectată. Analiza componentelor principale găseşte direcţii ortogonale de variaţie maximă după centrare; scalarea este necesară când unităţile trebuie să contribuie în mod comparabil. Decompoziţia în valori singulare calculează structuri de rang scăzut înrudite şi suportă matrici sparse. Analiza discriminantă liniară foloseşte etichetele pentru a găsi direcţii care separă clasele. Aceste metode furnizează transformări explicite, dar variaţia sau separarea claselor poate să nu păstreze informaţia necesară pentru o sarcină ulterioară.
Metodele de tip manifold, cum ar fi t‑SNE şi UMAP, construiesc vecinătăţi şi optimizează o dispunere cu dimensiune redusă. Sunt puternice pentru explorare, dar distorsionează distanţa globală, densitatea, dimensiunea clusterelor şi uneori separarea. Rezultatele depind de preprocesare, metrică, vecini sau perplexitate, iniţializare şi seed. Un cluster atrăgător în două dimensiuni poate apărea chiar şi fără grupuri discrete. Foloseşte setări multiple, colorează doar pe baza metadatelor neutilizate la antrenare şi validează structura aparentă în spaţiul original sau cu etichete independente.
Selecţia caracteristicilor, încorporări şi evaluare
Selecţia caracteristicilor păstrează variabilele originale prin filtre, wrapper‑e sau importanţă bazată pe model; învăţarea de reprezentări creează noi caracteristici latente utilizând autoencodere sau modele supravegheate. Proiecţiile aleatoare păstrează distanţele aproximativ în anumite condiţii şi oferă linii de bază eficiente. Alege metoda în funcţie de comprimare, vizualizare, reducerea zgomotului, viteză, stocare sau performanţa modelului. Antrenează reducătorul doar pe datele de antrenament, apoi transformă seturile de validare şi test. Reducerea supravegheată trebuie să fie încorporată în cross‑validare pentru a evita scurgerea etichetelor.
Evaluează variaţia explicată sau reconstrucţia pentru comprimarea liniară, încrederea şi păstrarea vecinătăţilor pentru vizualizare şi acurateţea ulterioară, calibrul, latenţa şi robusteţea pentru predicţie. Măsoară stabilitatea pe diferite eşantioane şi seed‑uri. Verifică dacă clasele rare sau grupurile sensibile sunt comprimate şi dacă maparea inversă este posibilă. Coordonatele reduse pot încă conţine informaţii private; un grafic bidimensional nu este anonimizare. Documentează transformarea, scalarea, ordinea caracteristicilor şi limitările.
Utilizare în producție
Servirea necesită transformarea exactă antrenată şi schema de intrare. Monitorizează caracteristicile lipsă, schimbarea intervalului, distribuţia scorurilor componentelor, eroarea de reconstrucţie şi rezultatele ulterioare. Dacă apar noi categorii sau senzori, re‑antrenează şi versionează întregul pipeline în loc să adaugi coloane în tăcere. Reducerea poate îmbunătăţi calculul şi poate elimina zgomotul unui model, dar poate şi elimina semnale slabe importante pentru evenimente rare. Trateaz‑o ca pe un pas de măsurare învăţat, a cărei informaţie păstrată şi pierdută trebuie testată în raport cu decizia.
Exemplu practic: reducerea caracteristicilor de comportament ale clienţilor
Un analist standardizează 200 de măsuri de comportament şi aplică PCA doar pe clienţii de antrenament. Cross‑validarea alege numărul de componente pe baza performanţei de churn ulterioară şi a stabilităţii, nu pe un grafic de dispersie bidimensional. Încărcăturile sunt inspectate pentru surse dominante şi lipsă de date. PCA, selecţia caracteristicilor, proiecţia aleatoare şi un model regulatizat neredus sunt comparate în termeni de calibratură, latenţă şi rezultate pentru segmente rare de clienţi. Eşantioane repetate testează, de asemenea, dacă componentele principale şi concluziile ulterioare rămân stabile.
Pipeline‑ul implementat fixează ordinea caracteristicilor, scalarea şi componentele şi respinge versiunile de schemă lipsă. Monitorizarea urmăreşte distribuţiile componentelor, eroarea de reconstrucţie şi rezultatele ulterioare. O vizualizare cu clustere aparente este folosită pentru a genera întrebări, nu pentru a atribui personaje de client. Deoarece componentele latente încă codifică comportamentul, accesul şi retenţia rămân controlate. Dacă definiţiile sursă se modifică, transformarea şi modelul complet sunt reconstruite şi validate în loc să se proiecteze date incompatibile în componentele vechi.
Dovezi de implementare şi pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Defineşte utilizatorii vizaţi, mediul de operare, intrările, ieşirile, dependenţele, proprietarul şi consecinţele fiecărui eșec important. Stabileşte o bază reproducibilă şi un set de evaluare versionat înainte de ajustare. Testează cazuri obișnuite, condiţii limită, intrări defecte sau lipsă, schimbări de distribuție, căderi de dependență, utilizare incorectă şi grupurile sau mediile cel mai probabil neacoperite. Măsoară calitatea sarcinii împreună cu calibrul sau incertitudinea, latenţa, debitul, costul resurselor, accesibilitatea, confidenţialitatea şi securitatea. Înregistrează fiecare transformare şi prag astfel încât un evaluator independent să poată reproduce rezultatul şi să distingă dovezile de un prototip atrăgător.
Înainte de lansare, desemnează autoritatea pentru eliberare, excepţii, modificări, revenire şi retragere. Foloseşte o lansare etapizată, păstrează un fallback sigur şi verifică monitorizarea cu defecţiuni introduse deliberat. Telemetria operaţională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieşirilor, versiunea modelului sau a regulii, starea dependenţelor, intervenţiile umane şi rezultatele confirmate fără a colecta date sensibile inutile. Defineşte pragurile de alertă şi responsabilul pentru răspuns, apoi revizuieşte dovezile din lumea reală după implementare în loc să presupui că performanţa offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreţinut necesită, de asemenea, proceduri documentate de recuperare, învăţare din incidente, ştergere şi păstrare, şi un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Reduce reducerea dimensională întotdeauna un model?
Nu. Poate elimina informaţii predictive sau poate complica interpretarea. Compară cu o bază fără reducere pe datele reţinute.
Demonstrează clusterele separate de t‑SNE existenţa claselor reale?
Nu. Harta este o vizualizare optimizată a relaţiilor de vecinătate şi poate crea o separare aparentă. Validează clusterele cu dovezi independente.
Referințe principale