Fundamentele AI
Ce este învățarea prin ansambluri?

 Adaugă Unite.AI la sursele tale preferate pe Google
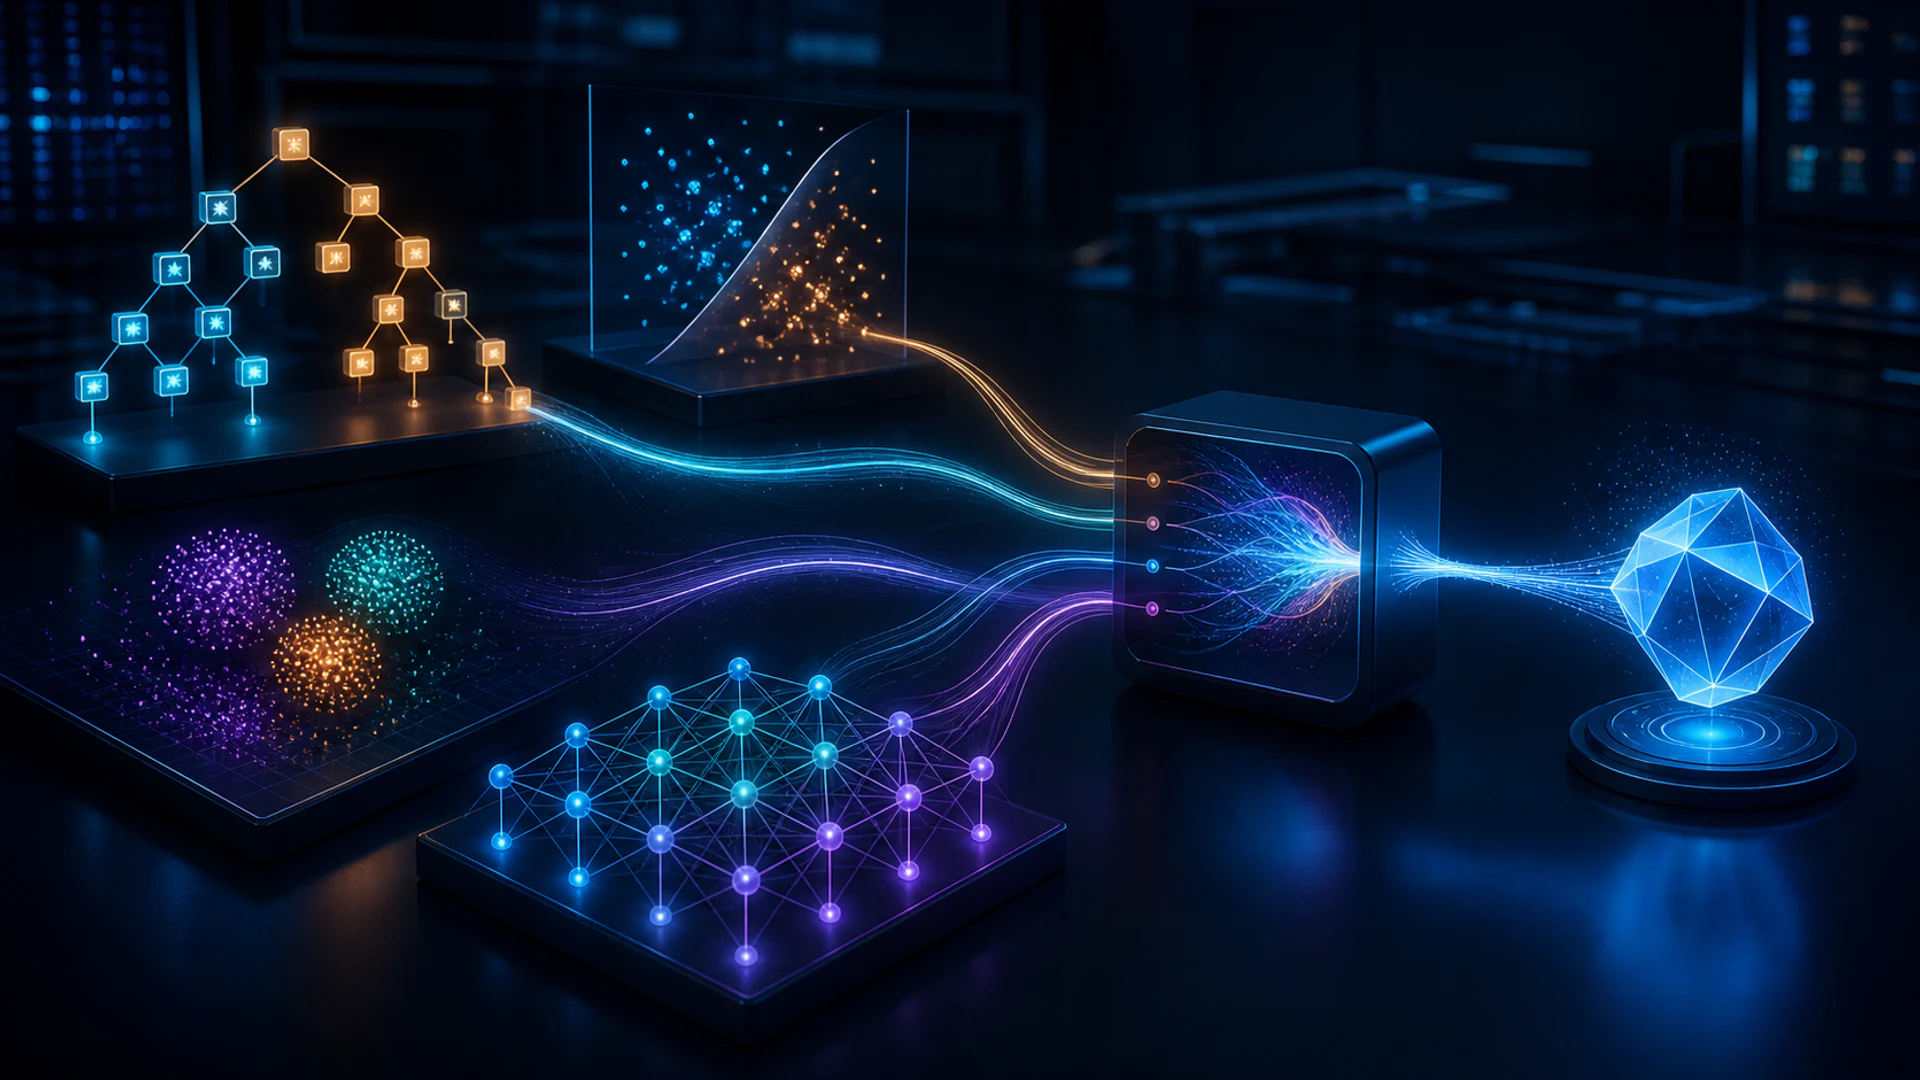
Ensemble learning combină predicțiile provenite din mai multe modele. Ideea centrală este că modele cu erori diferite pot genera un rezultat mai precis sau mai stabil atunci când ieșirile lor sunt mediate, supuse votului sau transmise unui meta‑învățător.
Adăugarea de modele nu este suficientă. Dacă fiecare membru a învățat aceeași scurtătură, erorile lor vor fi corelate și ansamblul poate deveni pur și simplu mai încrezător în aceeași greșeală.
Idei principale
- Ansamblurile funcționează cel mai bine când modelele membre sunt utile individual și produc erori semnificativ diferite.
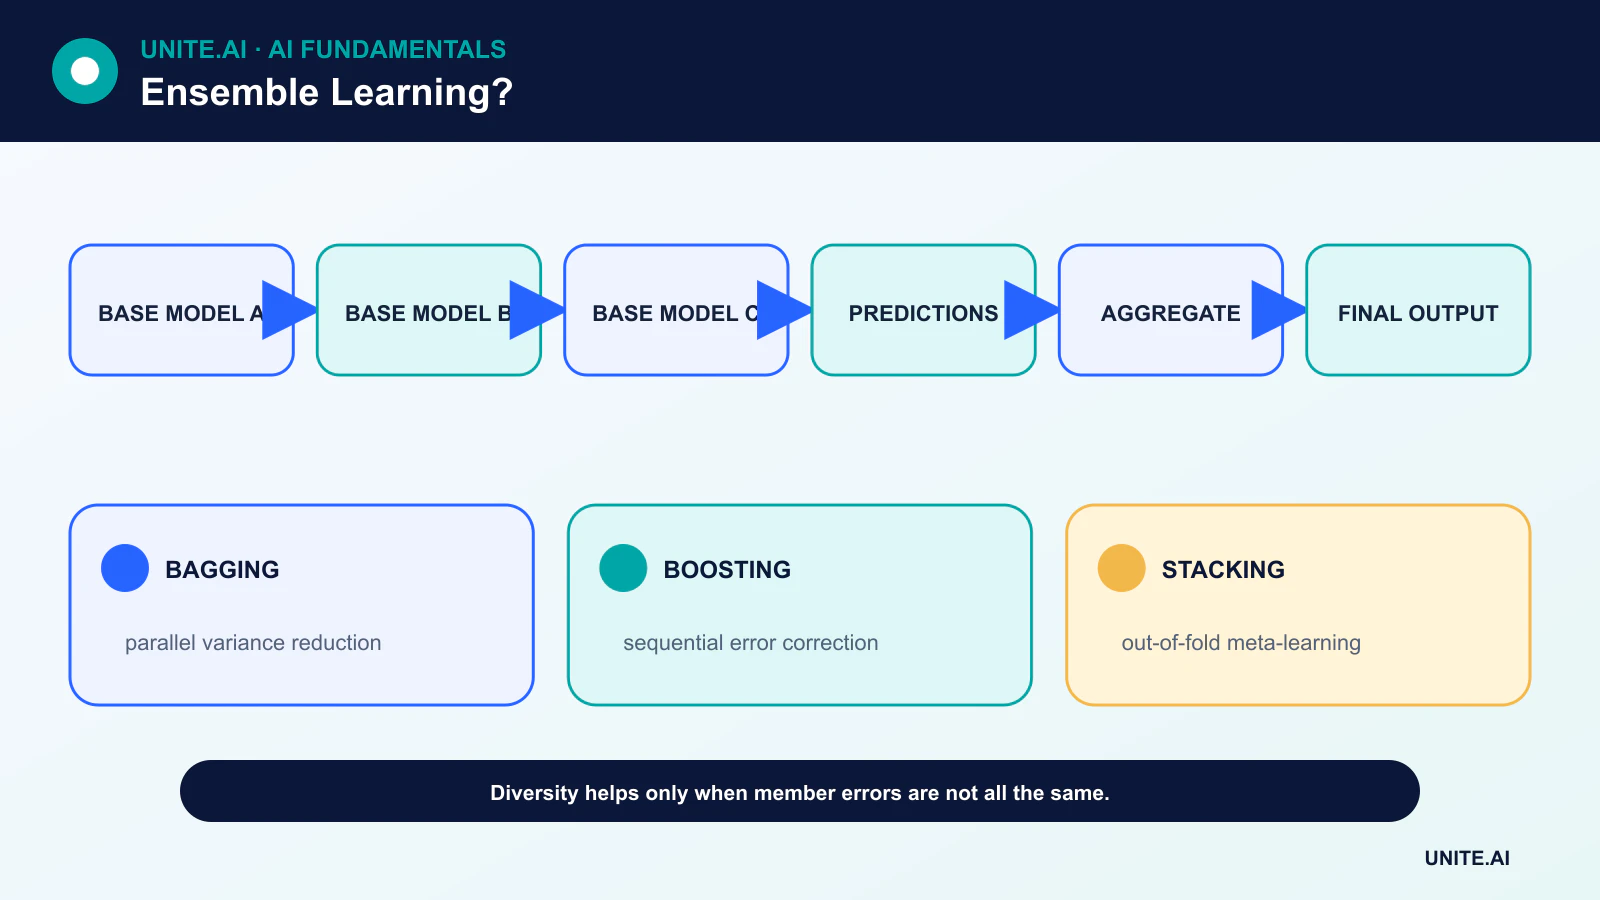
- Bagging antrenează membrii în paralel pe date reîncadrate; boosting antrenează învățătorii secvențial pentru a corecta erorile.
- Stacking antrenează un meta‑model pe predicții out‑of‑fold, nu pe predicții din eșantion.
- Câștigurile în acuratețe trebuie cântărite în raport cu latența, calibrul, interpretabilitatea și costul de mentenanță.
Votarea și media
Votul dur (hard voting) selectează clasa cu cele mai multe voturi. Votul moale (soft voting) mediază probabilitățile claselor, de obicei după calibrări. Ansamblurile de regresie mediează adesea predicțiile numerice. Versiunile ponderate acordă o influență mai mare membrilor mai puternici.
O medie poate reduce varianta atunci când erorile nu sunt perfect corelate. Nu poate repara un defect de date comun, o eroare de etichetă sau un subgrup lipsă. Diversitatea trebuie măsurată prin dezacord și suprapunere de erori, nu presupusă din numele diferite ale modelelor.
Bagging și păduri aleatoare
Bootstrap aggregating antrenează modele pe seturi de date reîncadrate și le mediază. Un arbore de decizie are o variansă ridicată, ceea ce îl face un candidat natural pentru bagging.
Pădurile aleatoare adaugă selecție aleatorie a caracteristicilor la împărțiri, reducând corelația dintre arbori. Exemplele out‑of‑bag pot estima performanța, dar un set final de test neatinse rămâne valoros pentru selecția modelelor și susținerea implementării.
Boosting
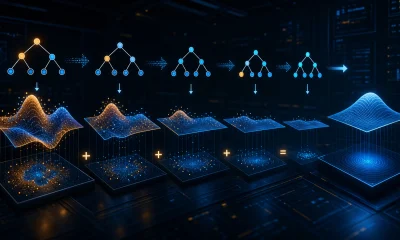
Boosting construiește un model aditiv în etape. Învățătorii ulteriori se concentrează pe exemple sau tipare reziduale pe care ansamblul curent le gestionează slab. AdaBoost modifică ponderile exemplarelor; gradient boosting ajustează învățătorii la gradientele negative ale unei funcții de pierdere alese.
Arborii boostați pot modela relații tabelare complexe, dar arborii adânci, numărul excesiv de iterații și scurgerile pot duce totuși la supraînvățare. Rata de învățare, adâncimea arborelui, subeșantionarea și oprirea timpurie sunt controale cheie.
Stacking și blending
Stacking creează un model de nivel secundar care învață cum să combine predicțiile de bază. Pentru a evita scurgerile, fiecare rând de antrenament pentru meta‑model trebuie să provină de la un model de bază care nu a fost antrenat pe acel rând. Validarea încrucișată generează aceste predicții out‑of‑fold.
Blending folosește un set de reținere separat pentru meta‑model, ceea ce este mai simplu, dar reduce datele disponibile pentru antrenament. Ambele abordări necesită aceeași preprocesare și control de versiune în timpul inferenței.
Compromisuri operaționale
Un ansamblu poate multiplica memoria, calculul și modurile de eșec. Poate fi mai dificil de explicat, calibrat și actualizat în mod consistent. Distilarea poate comprima un ansamblu într-un model mai mic, dar modelul student trebuie evaluat independent.
O selecție practică compară performanța, latența la coadă, calibrul, utilizarea resurselor și costul erorilor. Uneori, un model bine regularizat este preferabil față de un mic câștig de acuratețe obținut dintr-un stack fragil.
De ce funcționează ansamblurile
Învățarea prin ansambluri combină mai multe modele astfel încât erorile lor să se anuleze parțial sau punctele forte să acopere regiuni diferite. Bagging antrenează modele pe date reîncadrate și mediază predicțiile, reducând varianta; pădurile aleatoare adaugă selecție aleatorie a caracteristicilor pentru a decorrela arborii. Boosting antrenează învățătorii secvențial pentru a se concentra pe eroarea reziduală, reducând adesea bias‑ul, dar crescând sensibilitatea la zgomot și la reglare. Stacking antrenează un meta‑model pe predicțiile modelelor de bază. Diversitatea trebuie să fie utilă: mediarea modelelor identice aduce cost fără o reducere semnificativă a erorii.
Corelația dintre erori determină beneficiul. Diversitatea poate proveni din eșantioane de date, caracteristici, algoritmi, hiperparametri, inițializare aleatoare sau ferestre temporale. Votul dur renunță la încredere; votul moale mediază probabilitățile, dar necesită o calibră compatibilă. Regresia poate media sau poate folosi agregare robustă. În stacking, predicțiile out‑of‑fold sunt esențiale — antrenarea meta‑modelului pe predicții de bază din aceleași date ajustate cauzează scurgeri. Menține o bază simplă de mediere înainte de a adopta un combinator complex.
Evaluare, calibrul și incertitudinea
Compară fiecare membru și ansamblul pe un set reținut cu preprocesare identică. Raportează metricile sarcinii, calibrul, erorile subgrupurilor, varianta între plieri sau semințe și costul resurselor. Un ansamblu poate îmbunătăți calitatea medie în timp ce maschează un punct orb comun cauzat de date sau etichete comune. Inspectează dezacordul: poate identifica incertitudinea, dar modele corelate și încrezător greșite pot fi de acord. Calibrează ansamblul final, nu doar membrii, și validează pragurile de abstinență în raport cu capacitatea de revizuire și consecințele.
Estimările out‑of‑bag sunt utile pentru modele bagged, dar nu înlocuiesc un test final reprezentativ pentru implementare. Pentru date temporale, evită reîncadrarea care rupe ordinea. Pentru utilizări legate de siguranță, testează eșecul membrilor, modelele învechite și intrările adversariale. Ansamblurile ponderate pot supra‑învăța datele de validare când se încearcă mulți candidați. Înregistrează selecția candidaților și folosește validare încorporată atunci când reglarea este amplă.
Servire și mentenanță
Ansamblurile multiplică memoria, latența, energia și dependențele operaționale. Distilarea poate comprima comportamentul combinat într-un singur model, cu o nouă cerință de validare. Versionează membrii, preprocesarea, ponderile și rutarea ca un singur artefact; definește comportamentul când un membru expiră sau produce un rezultat invalid. Monitorizează predicțiile membrilor și dezacordul pentru ca eșecurile silențioase să fie vizibile. Retrage membrii redundanți și reantrenează în mod deliberat. Ansamblurile îmbunătățesc predicția când diversitatea erorilor este reală, dar nu transformă datele de antrenament părtinitoare sau o țintă invalidă în dovezi fiabile.
Exemplu practic: un ansamblu pentru alerte de vreme severă
O echipă de prognoză combină un set de caracteristici din modelul fizic, un arbore gradient‑boosted, un model neural secvențial și o bază statistică calibrată. Predicțiile out‑of‑fold antrenează un meta‑model simplu, iar evaluarea folosește furtuni viitoare excluse complet din antrenamentul membrilor. Metricile includ recall‑ul evenimentelor, alarme false, timpul de anticipare, calibrul, performanța geografică și fiabilitatea în condiții extreme rare. Corelația erorilor membrilor este examinată deoarece datele de intrare comune pot crea puncte oarbe comune.
Servirea păstrează fiecare predicție și rezultatul combinat. Dacă un membru nu este disponibil, sistemul folosește o configurație degradată prevalidată în loc să renormalizeze silențios. Dezacordul declanșează o revizuire suplimentară, dar nu este tratat ca incertitudine în toate cazurile. Monitorizarea urmărește deriva membrilor, latența și rezultatele furtunilor, cu ponderi actualizate doar prin validare controlată. Avertismentele publice rămân sub procesele de decizie meteorologică autorizate; ansamblul îmbunătățește dovezile, dar nu redefinește autonom politica de alertă.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definește utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabilește o bază reproductibilă și un set de evaluare versionat înainte de reglare. Testează cazuri obișnuite, condiții de frontieră, intrări malformate sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare incorectă și grupurile sau mediile cel mai probabil subreprezentate. Măsoară calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrează fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuie autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Folosește o lansare etapizată, păstrează un fallback sigur și verifică monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, starea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definește pragurile de alertă și un responsabil de răspuns, apoi revizuiește dovezile din lumea reală după implementare în loc să presupui că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care trebuie dezactivat sau înlocuit.
Întrebări frecvente
Este o pădure aleatoare un ansamblu?
Da. Combină numeroase arbori de decizie aleatori, de obicei prin vot sau mediere.
Pot modelele identice să formeze un ansamblu util?
Pot, dacă datele de antrenament, inițializarea sau eșantionarea generează erori suficient de diferite, dar simpla duplicare nu aduce niciun beneficiu.
Referințe principale