Fundamentele AI
Ce este învățarea cu puține exemple?

 Adaugă Unite.AI la sursele tale preferate pe Google
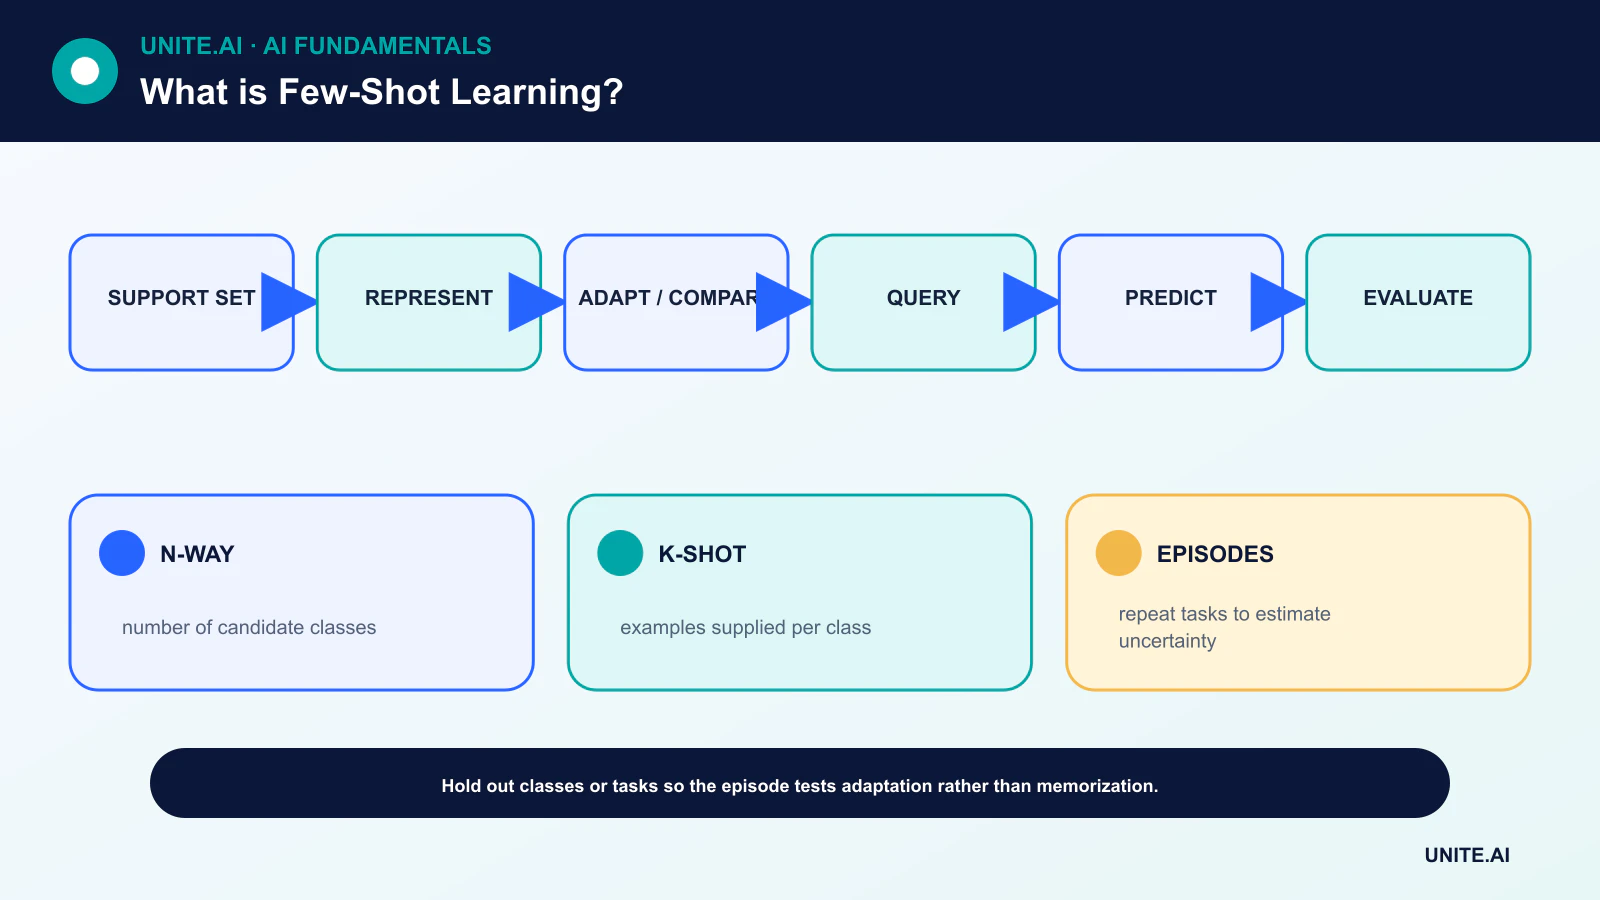
Învățarea cu puține exemple studiază cum un model poate să se adapteze la o sarcină sau clasă nouă folosind doar un număr mic de exemple etichetate. În benchmark-urile clasice, un episod furnizează un set de suport — cum ar fi cinci clase cu unul sau cinci exemple pe clasă — și cere modelului să clasifice interogări nevăzute.
Termenul este folosit și pentru învățarea în context, în care un model de limbaj pre-antrenat primește câteva demonstrații în promptul său fără a actualiza parametrii. Aceste setări împărtășesc obiectivul de a învăța din puține exemple, dar utilizează mecanisme de adaptare diferite și necesită proiectări de evaluare distincte.
Aspecte cheie
- N-way K-shot descrie N clase și K exemple de suport etichetate pe clasă.
- Metodele de învățare metrică compară interogările cu reprezentările învățate ale exemplelor de suport.
- Meta-învățarea optimizează peste multe sarcini astfel încât o sarcină nouă să poată fi învățată rapid.
- Puține exemple amplifică erorile de etichetare, scurgerile, ambiguitatea claselor și incertitudinea, astfel încât bazele de referință și raportarea încrederii sunt importante.
Episoade, seturi de suport și seturi de interogare
Un episod cu puține exemple separă un set mic de suport etichetat de un set de interogare utilizat pentru evaluare. În timpul meta-antrenamentului, modelul întâlnește numeroase astfel de episoade. O evaluare riguroasă reține clase, sarcini sau domenii întregi, astfel încât episodul de testare să măsoare adaptarea în loc de memorare.
Raportați distribuțiile de acuratețe pe parcursul multor episoade, nu doar pe un singur eșantion convenabil. Comparați cu bazele simple de tip cel mai apropiat vecin și cele liniare; o metodă sofisticată care nu poate depăși o reprezentare bine antrenată plus un clasificator de bază s-ar putea să nu-și justifice complexitatea.
Învățare metrică și prototipuri
Rețelele de potrivire și metodele înrudite încorporează exemplele de suport și interogare într-un spațiu în care vectorii apropiați ar trebui să aibă aceeași etichetă. Rețelele prototipice calculează media încorporărilor de suport pentru fiecare clasă și clasifică o interogare în funcție de distanța față de prototipurile acelor clase.
Acest lucru leagă învățarea cu puține exemple de calitatea reprezentării. Un model deep-learning pre-antrenat poate deja să organizeze bine caracteristicile relevante, în timp ce o reprezentare nepotrivită poate face ca fiecare distanță să fie înșelătoare.
Meta-învățare bazată pe optimizare
Model-Agnostic Meta-Learning caută parametri care pot fi adaptați cu un număr mic de pași de gradient. Alte metode învață un optimizer, o inițializare sau o regulă de actualizare a parametrilor. Bucla exterioară evaluează performanța post-adaptare pe parcursul sarcinilor.
Meta-învățarea presupune că structura utilă este partajată între sarcinile de antrenament și cele țintă. Când distribuția țintă diferă semnificativ, adaptarea rapidă poate eșua. Validarea ar trebui să varieze numărul de exemple, clasele, domeniile și dificultatea sarcinilor în loc să trateze un singur benchmark ca universal.
Învățare prin transfer și strategii la nivel de date
Învățarea prin transfer este adesea cel mai puternic punct de plecare practic: înghețarea unui encoder pre-antrenat, antrenarea unei capete mici, apoi ajustarea fină selectivă dacă există suficiente date. Augmentarea datelor poate introduce invariantențe, dar exemplele sintetice nerealiste pot amplifica bias-ul sau pot crea scurtături.
Învățarea activă poate prioritiza care exemple să fie etichetate, în timp ce învățarea semi-supervizată poate folosi date suplimentare neetichetate. Acestea sunt strategii complementare, nu sinonime pentru învățarea cu puține exemple.
Promptarea cu puține exemple este diferită
Un transformer poate deduce un tipar din demonstrațiile plasate în contextul său. Nu este necesară actualizarea persistentă a parametrilor. Ordinea, formularea și echilibrul etichetelor pot modifica semnificativ rezultatul, iar exemplele pot consuma o parte mare din fereastra de context.
Folosiți un set de evaluare reprezentativ, versionați fiecare prompt și demonstrație și testați alternative zero-shot, few-shot și cu ajustare fină. Un set de suport foarte mic nu susține afirmații puternice la scară largă, în special pentru cazuri rare sau critice din punct de vedere al siguranței.
Paradigme de învățare cu puține exemple și construcția sarcinilor
Învățarea cu puține exemple își propune să execute o sarcină din foarte puține exemple etichetate. În metodele bazate pe metrică, un encoder mapă exemplele într-un spațiu în care prototipurile sau vecinii cei mai apropiați reprezintă clasele. Meta-învățarea bazată pe optimizare antrenează o inițializare sau o regulă de actualizare pentru adaptare rapidă. Învățarea prin transfer ajustează fin un model pre-antrenat pe un set țintă mic. Învățarea în context furnizează exemple în prompt fără a actualiza greutățile. Aceste mecanisme diferă, astfel că afirmațiile ar trebui să specifice dacă parametrii se schimbă, ce antrenament prealabil a avut loc și cum sunt selectate exemplele.
Evaluarea ar trebui să separe clasele, sarcinile, subiectele sau domeniile de antrenament și testare conform generalizării revendicate. Un episod N-way K-shot conține N clase și K exemple de suport pe clasă, plus exemple de interogare pentru evaluare. Episoadele repetate estimează variabilitatea datorată selecției de suport. Pentru promptare, ordinea exemplului, formularea etichetelor, formatul și similaritatea demonstrațiilor pot schimba semnificativ rezultatele. Comparați cu bazele zero-shot, cel mai apropiat vecin, linear-probe și ajustarea fină obișnuită utilizând aceeași reprezentare și buget de date.
Calitatea datelor, incertitudinea și transferul negativ
Cu puține exemple, cazurile etichetate greșit sau atipice au o influență disproporționată. Definiți reguli de adnotare, inspectați fiecare element de suport și păstrați un rezultat necunoscut sau de abstinență. Augmentarea datelor și exemplele sintetice pot ajuta doar când păstrează sarcina și adaugă variații realiste. Un model pre-antrenat poate transfera scurtături sau bias din domeniul său sursă. Testați cazuri din afara domeniului, grupuri rare și sensibilitatea la eliminarea unui exemplu de suport. Raportați intervale de încredere pe parcursul sarcinilor și semințelor aleatoare, nu un singur prompt favorabil.
Învățarea activă poate solicita etichete pentru cazuri informative, în timp ce metodele semi-supervizate folosesc date neetichetate sub presupuneri suplimentare. Recuperarea poate selecta demonstrații relevante dinamic, dar trebuie să evite scurgerile de etichete în testare. Adaptarea poate supraînvața rapid, așa că restricționați actualizările, utilizați regularizare și validați pe exemple separate. Pentru sarcini critice, câteva etichete rareori justifică decizii autonome; folosiți modelul pentru a prioritiza sau a asista revizuirea până când există suficiente dovezi ale rezultatului.
Operare în producție
Versionați modelul de bază, încorporarea sau șablonul de prompt, demonstrațiile, schema de etichete și parametrii de adaptare. Protejați exemplele deoarece prompturile sau gradientele pot expune înregistrări sensibile. Monitorizați performanța pe măsură ce clasele și limbajul se schimbă și reîmprospătați exemplele de suport prin revizuire guvernată, nu prin auto-etichetare automată. Învățarea cu puține exemple reduce cerința de etichetare a țintei prin exploatarea structurii anterioare; nu elimină nevoia de evaluare reprezentativă, definiție atentă a sarcinii, expertiză de domeniu sau un fallback sigur când sarcina nouă se află în afara acelei structuri.
Exemplu practic: clasificare cu puține exemple pentru un produs nou
O echipă de suport are nevoie de etichete de rutare pentru un produs cu doar cinci exemple revizuite pe problemă. Compară prototipurile cele mai apropiate într-o încorporare pre-antrenată, o capetă liniară, ajustarea fină eficientă din punct de vedere al parametrilor și promptarea în context. Familiile de produse, clienții și mesajele ulterioare sunt excluse din meta-antrenament și selecția modelului. Eșantionarea repetată a setului de suport raportează reamintirea pe clase, calibrarea, variabilitatea și sensibilitatea la o demonstrație etichetată greșit.
Mesajele cu încredere scăzută și cele neacoperite sunt direcționate către suportul general, iar recenzorii corectează etichetele printr-o coadă guvernată. Exemplele sunt de-identificate, versionate și nu sunt niciodată selectate din setul final de testare. Monitorizarea urmărește vocabularul nou, ratele pe clase, corecțiile și dezacordurile. Când se acumulează suficiente etichete, sistemul cu puține exemple este comparat cu antrenamentul supravegheat obișnuit. Configurarea rapidă este utilă, dar nu justifică automatizarea dacă performanța rămâne instabilă sau dacă produsul nou diferă substanțial de familiile de sarcini anterioare.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare incorectă și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare etapizată, păstrați un fallback sigur și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, starea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Este învățarea one-shot aceeași cu învățarea cu puține exemple?
Învățarea one-shot este cazul special în care există un singur exemplu de suport etichetat pe clasă sau sarcină. Învățarea zero-shot nu folosește niciun exemplu etichetat pentru țintă.
Învățarea cu puține exemple elimină nevoia de date?
Nu. Ea mută dependența către datele de pre-antrenament, sarcini înrudite, reprezentări și presupuneri. Etichetele țintă sunt puține; istoricul total de învățare este de obicei mare.
Referințe principale