
Fundamentele AI
Ce sunt rețelele neuronale?

 Adaugă Unite.AI la sursele tale preferate pe Google
Un rețea neuronală artificială este un model matematic parametrizat format din straturi de operații conectate. În timpul antrenării, rețeaua își ajustează parametrii astfel încât intrările să fie mapate la ieșiri utile. Rețelele neuronale pot aproxima relații neliniare complexe și pot învăța reprezentări direct din text, imagini, audio, serii temporale și alte date.
Numele este inspirat istoric de neuroni biologici, dar rețelele moderne sunt sisteme inginerești, nu simulări realiste ale creierului. Termeni precum „neuron” și „învățare” sunt abrevieri utile și nu trebuie interpretați ca dovezi ale unei cogniții asemănătoare cu cea umană.
Aspecte cheie
- Un neuron calculează o sumă ponderată, adaugă un bias antrenabil și aplică o funcție de activare.
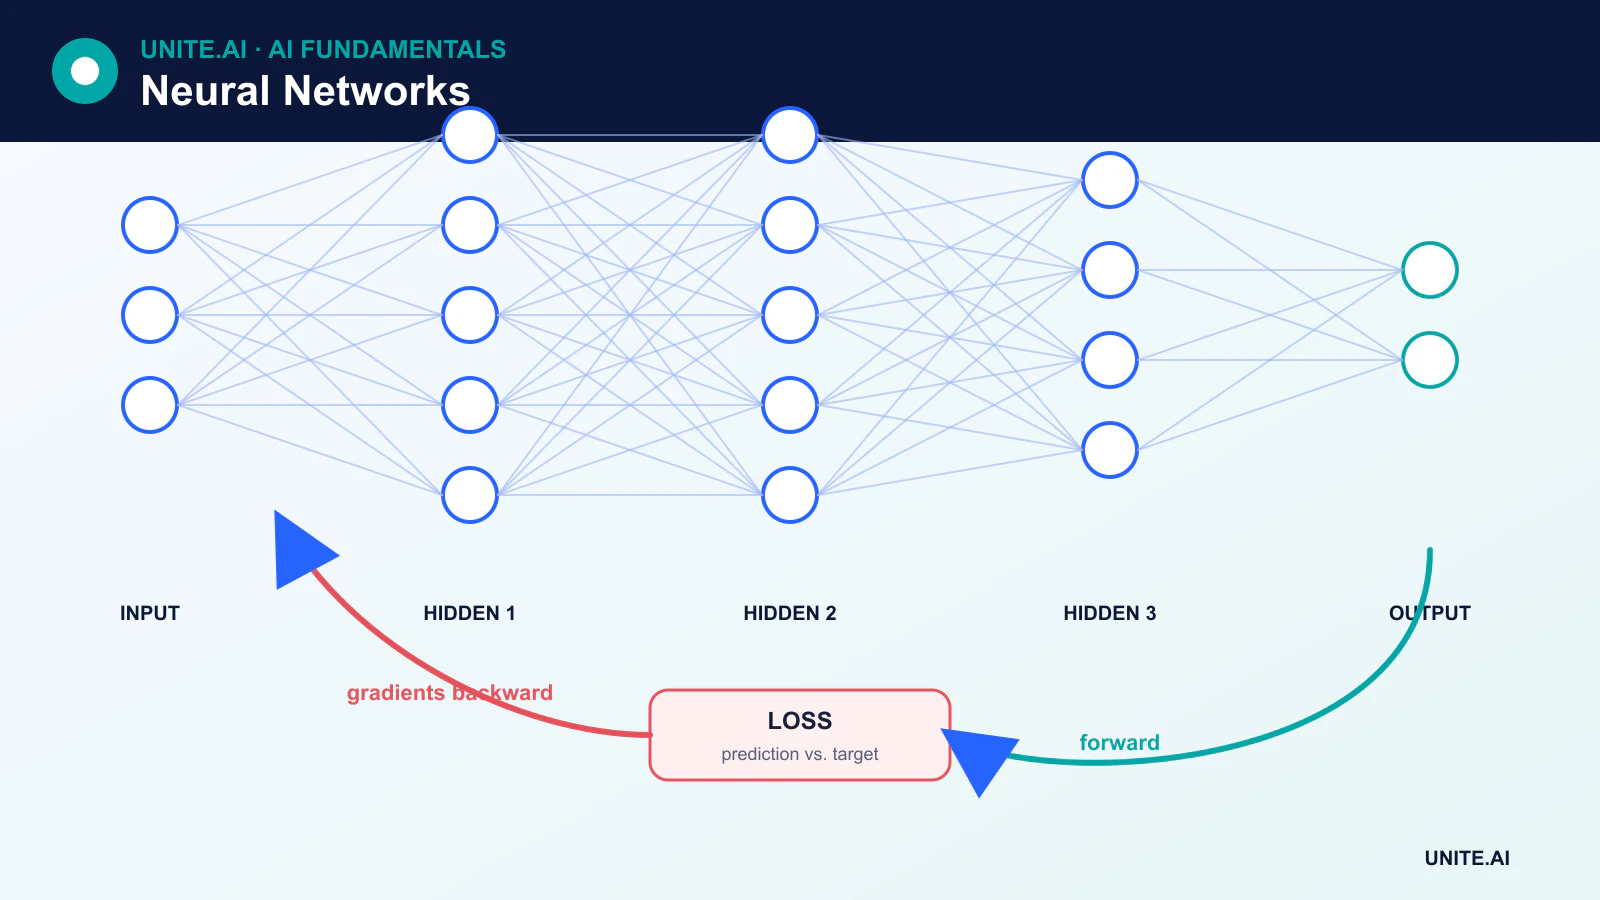
- O trecere înainte generează predicții; o funcție de pierdere măsoară eroarea; backpropagation calculează gradientele; un optimizer actualizează parametrii.
- MLP-urile, CNN-urile, RNN-urile și transformerele organizează conexiunile diferit.
- Mai multe straturi sau parametri nu produc automat un model mai bun sau mai de încredere.
De la un neuron artificial singular la o rețea
Pentru un vector de intrare x, o unitate de bază calculează:
z = Wx + boutput = activation(z)
W conține greutăți antrenabile și b este un bias antrenabil. Funcția de activare introduce neliniaritate. Greutățile nu „trec prin” activare de la sine; activarea se aplică sumei ponderate și bias-ului.
Un perceptron multistrat (MLP) suprapune straturi dense. Stratul de intrare reprezintă caracteristicile, straturile ascunse le transformă, iar stratul de ieșire este conceput pentru sarcină — de exemplu, logit-uri de clasă sau o valoare de regresie.
Cum învață rețelele neuronale
- Modelul inițializează parametrii antrenabili.
- O trecere înainte procesează un batch și produce predicții.
- O funcție de pierdere compară predicțiile cu obiectivul de antrenament.
- Backpropagation folosește regula lanțului pentru a calcula gradientele.
- Un optimizer, cum ar fi stochastic gradient descent sau AdamW, actualizează greutățile și bias-urile.
Backpropagation a devenit central pentru antrenarea rețelelor neuronale prin munca dezvoltată și popularizată de-a lungul mai multor decenii; nu a fost creat prima dată în era recentă a deep learning-ului. Cadrele moderne implementează diferențiere automată în mod invers, astfel încât practicienii nu trebuie să deriveze manual fiecare gradient.
De ce contează funcțiile de activare
Fără activări neliniare, mai multe straturi liniare obișnuite se reduc la o singură transformare liniară. ReLU este utilizat pe scară largă deoarece este simplu și eficient. GELU și SiLU sunt comune în arhitecturi moderne. Sigmoid și softmax rămân utile pentru interpretări specifice ale ieșirilor, dar sigmoid poate satura în straturile ascunse și poate contribui la dispariția gradientelor.
Arhitecturi majore de rețele neuronale
Rețele neuronale convoluționale
CNN-urile aplică filtre învățate pe vecinătăți locale și împart parametrii pe poziții. Aceste proprietăți le fac eficiente pentru imagini și alte semnale de tip grilă.
Rețele recurente
RNN-urile, LSTM-urile și GRU-urile actualizează un stat ascuns pe parcursul unei secvențe. Ele rămân utile pentru fluxuri și sarcini de serii temporale, deși recurența limitează procesarea paralelă și poate avea dificultăți cu dependențe lungi.
Transformere
Transformerele folosesc atenția pentru a crea reprezentări dependente de context. Conexiunile reziduale, normalizarea, informația de poziție și blocurile feed-forward sunt părți esențiale ale arhitecturii. Transformerele susțin acum multe modele mari de limbaj și multimodale.
Autoencodere și rețele generative
Autoencoderele învață reprezentări prin reconstrucție. GAN-urile, modelele de difuzie și rețelele autoregresive generează noi mostre utilizând obiective și proceduri de antrenament diferite.
Componente care fac rețelele profunde antrenabile
Sistemele moderne folosesc mai mult decât straturi și activări. Conexiunile reziduale permit informației și gradientelor să ocolească blocurile. Normalizarea stabilizează activările. Regularizarea, augmentarea datelor, dropout-ul și decăderea greutăților pot reduce overfitting. Straturile de embedding mapează elemente discrete, cum ar fi tokenii, în vectori. Atenția permite unei reprezentări să depindă dinamic de alte elemente.
Puncte forte și limitări
Rețelele neuronale pot învăța caracteristici din date brute de înaltă dimensiune și se pot scala odată cu datele și calculul. Ele pot, de asemenea, să necesite seturi de date mari, hardware specializat și reglări atente. Predicțiile lor pot fi prost calibrate, fragile la schimbarea distribuției, vulnerabile la manipulări adversariale sau greu de explicat.
Arhitectura ar trebui să se potrivească sarcinii și constrângerilor de implementare. Pentru multe probleme tabelare, un ansamblu de arbori sau un model liniar poate fi mai rapid și mai ușor de validat. Pentru aplicații cu risc ridicat, performanța modelului trebuie evaluată pe subgrupe și moduri de eșec, nu doar printr-un benchmark agregat.
Straturi, activări și flux de informație
O rețea neuronală compune funcții parametrizate. Fiecare unitate formează o combinație ponderată a intrărilor, adaugă un bias și trece rezultatul printr-o activare precum ReLU, sigmoid, tanh sau GELU. Suprapunerea straturilor permite caracteristici ierarhice și frontiere de decizie neliniare. Lățimea controlează numărul de unități pe strat; adâncimea controlează transformările succesive; conectivitatea și partajarea greutăților definesc arhitectura. Ieșirea rețelei depinde de preprocesare, parametri, normalizare și modul de inferență în ansamblu. Un neuron este o operație matematică, nu un neuron biologic literal sau un concept independent semnificativ.
Propagarea înainte calculează predicțiile; o funcție de pierdere cuantifică eroarea; backpropagation aplică regula lanțului la gradienti; un optimizer actualizează parametrii. Inițializarea, rata de învățare, statisticile batch-ului, căile reziduale și normalizarea influențează dacă gradientii dispar, explodează sau rămân utili. Regularizarea include decăderea greutăților, dropout, augmentarea, oprirea timpurie și constrângerile arhitecturale. Trasați comportamentul antrenamentului și validării, inspectați statisticile gradientului și activării și comparați execuțiile repetate. O rețea mare poate memora datele de antrenament, în timp ce una mică poate subîncadra sau omite structura necesară.
Selecția arhitecturii, evaluarea și implementarea
Perceptronii multistrat procesează vectori fixați; rețelele convoluționale exploatează structura locală; modelele recurente și cele de tip state-space procesează secvențe; transformerele folosesc atenția; rețelele grafice schimbă informații de-a lungul muchiilor. Hibrizii sunt comuni. Alegeți pe baza bias-ului inductiv, datelor, dimensiunii secvenței sau imaginii, latenței, memoriei, interpretabilității și hardware-ului disponibil. Evaluați față de un baseline liniar sau de arbori și efectuați ablații pentru a afla ce complexitate contează. Numărul de parametri singur nu prezice calitatea, costul inferenței sau cerințele de date.
Servirea necesită preprocesare înghețată, un graf exportat sau compilat, validare numerică și teste de resurse la sarcină realistă. Cuantizarea și tăierea pot reduce dimensiunea, dar pot modifica comportamentul claselor rare. Monitorizați intrările, ieșirile, calibrările, latența și rezultatele confirmate; testați date adversare și date cu distribuție schimbată. Protejați modelele, dependențele și datele prin artefacte semnate, control de acces și revizuire a lanțului de aprovizionare. Explicațiile din activări individuale sau saliență necesită verificare cauzală și comportamentală. Rețelele neuronale sunt aproximatori de funcții flexibili, nu garanții de înțelegere, adevăr sau robustețe.
Exemplu practic: un prognozator neural de cerere
Un retailer prezice cererea săptămânală a unui articol din vânzări, promoții, preț, sărbători, disponibilitate și vreme. Rețeaua este comparată cu baseline-uri sezoniere naive, liniare și de tip arbore utilizând divizări temporale în rulare. Promoțiile viitoare sunt incluse doar când sunt cunoscute cu adevărat la momentul prognozei, în timp ce lipsurile de stoc sunt modelate deoarece vânzările observate pot subestima cererea. Evaluarea folosește eroarea absolută ponderată, bias-ul, acoperirea intervalului și rezultate pe viteza articolului și magazin.
Linia de servire a pipeline-ului versionează disponibilitatea funcționalității, modelul și orizontul și refuză o prognoză când intrările necesare sunt învechite. Planificatorii văd intervalele și pot suprascrie cu motive înregistrate. Monitorizarea detectează fluxuri lipsă, erori în schimbare, bias și prognoze neobișnuite; rezultatele de business sunt separate de acuratețea prognozei deoarece politica de comandă influențează și inventarul. O actualizare a modelului este monitorizată în mai multe cicluri, iar prognoza anterioară rămâne disponibilă pentru revenire în caz de perturbare sezonieră sau a furnizorului.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți un baseline reproductibil și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbarea distribuției, întreruperi de dependență, utilizare greșită și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, rollback și retragere. Utilizați o lansare în etape, păstrați un fallback sigur și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se schimbă. Un sistem menținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Este fiecare rețea neuronală deep learning?
Nu. O rețea mică cu un singur strat ascuns este o rețea neuronală, în timp ce deep learning se referă în general la arhitecturi cu multiple etape de procesare învățate. Granița este convențională, nu un prag științific strict.
Stochează rețelele neuronale datele lor de antrenament?
Ele stochează parametrii învățați, nu o copie căutabilă obișnuită a setului de date. Totuși, modelele mari pot memora și reproduce exemple individuale de antrenament, ceea ce creează riscuri de confidențialitate și drepturi de autor ce trebuie testate.
Referințe principale












