
Fundamentele AI
Ce este învățarea prin întărire profundă?

 Adaugă Unite.AI la sursele tale preferate pe Google
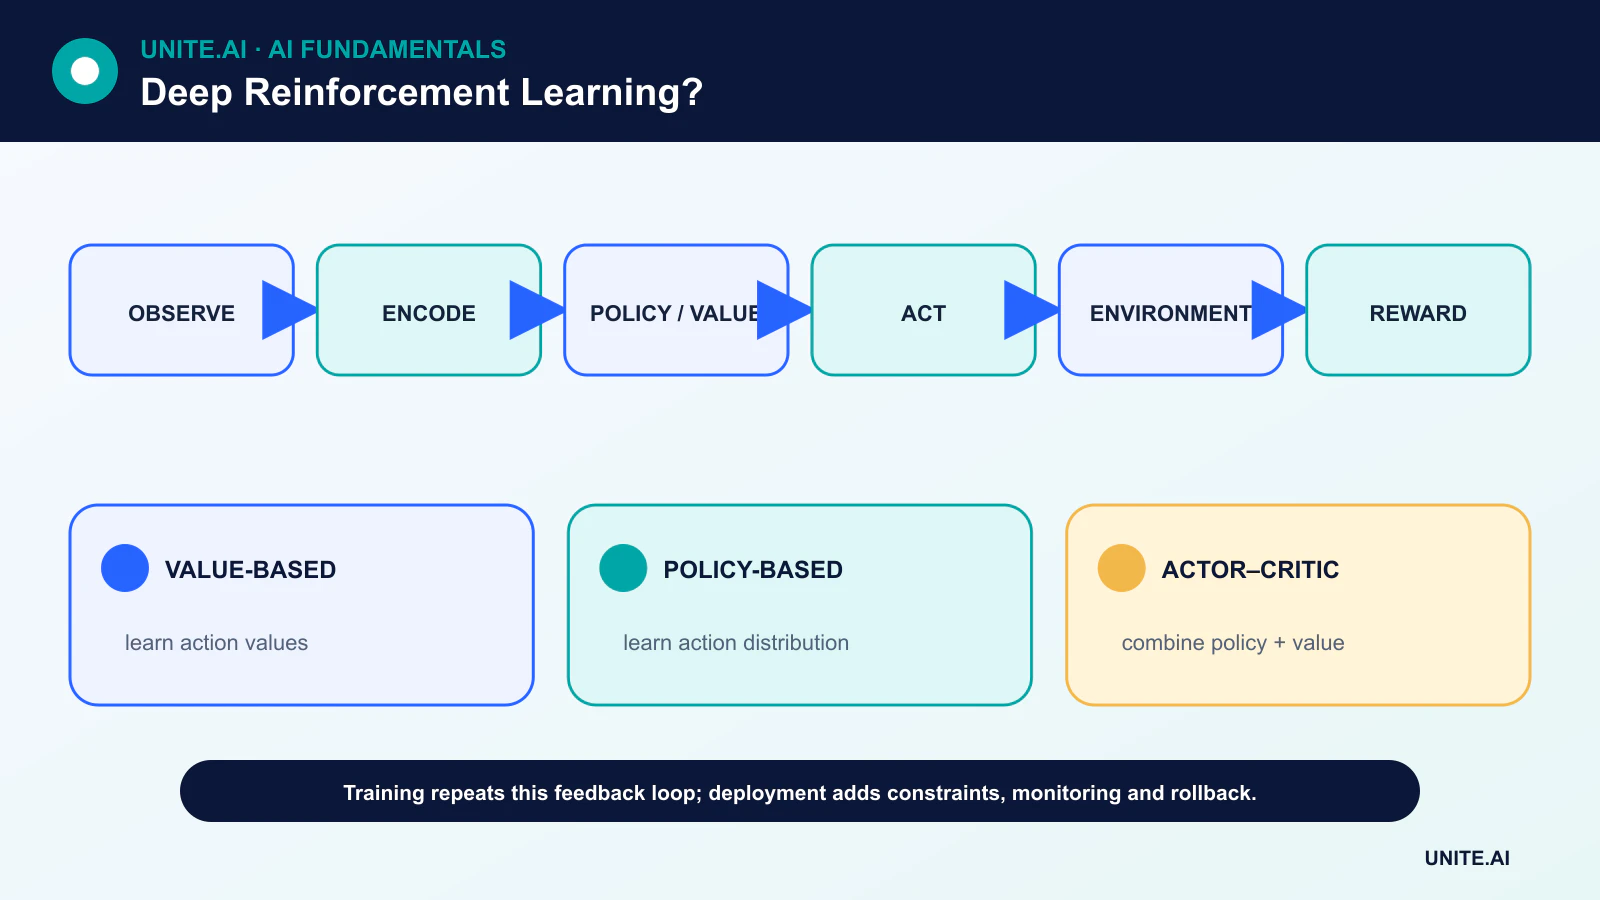
Învățarea prin întărire profundă (deep RL) combină învățarea prin întărire cu rețele neuronale profunde. Un agent observă o stare, alege o acțiune, primește o recompensă și o nouă observație, apoi ajustează o politică sau o funcție de valoare pentru a îmbunătăți deciziile viitoare.
Rețeaua profundă nu elimină părțile dificile ale învățării prin întărire. Ea oferă o modalitate flexibilă de a reprezenta imagini, fluxuri de senzori, spații mari de acțiuni sau funcții de valoare complexe. Explorarea, creditul întârziat, antrenamentul instabil și evaluarea sigură în lumea reală rămân probleme esențiale de inginerie.
Idei principale
- Învățarea prin întărire profundă învață decizii secvențiale prin interacțiune, nu dintr-un tabel fix de exemple etichetate.
- Metodele bazate pe valoare estimează cât de bune sunt acțiunile; metodele de politică învață direct distribuția acțiunilor; metodele actor‑critic combină ambele.
- Buffer‑urile de redare, rețelele țintă și proiectarea atentă a recompenselor pot îmbunătăți antrenamentul, dar niciuna nu garantează un comportament fiabil.
- Un scor ridicat în simulator nu este dovadă de robustețe, siguranță sau de transfer reușit în lumea fizică.
Problema decizională: stări, acțiuni și recompense
Multe sarcini de deep‑RL sunt modelate ca un proces de decizie Markov. La momentul t, agentul primește starea sau observația st, selectează acțiunea at, apoi primește recompensa rt+1 și starea următoare. Obiectivul este randamentul așteptat descdiscountat, nu neapărat recompensa imediată.
Factorul de discount controlează cât de mult contează recompensele îndepărtate. O funcție de recompensă definește ce va urmări procesul de optimizare, astfel încât un proxy incomplet poate genera un comportament tehnic de succes, dar operațional nedorit. Acesta este un motiv pentru care proiectarea recompenselor și testarea constrângerilor merită aceeași atenție ca arhitectura modelului.
Metode bazate pe valoare, pe politică și actor‑critic
Un algoritm bazat pe valoare estimează valoarea unei stări sau a unei acțiuni. Rețelele Q profunde (Deep Q‑networks) folosesc o rețea neuronală pentru a aproxima valorile Q și, de obicei, aleg acțiunea cu cea mai mare estimare păstrând totuși o anumită explorare. Un algoritm de gradient de politică optimizează în schimb o politică parametrizată care produce o distribuție de acțiuni.
Sistemele actor‑critic mențin atât un actor, care propune acțiuni, cât și un critic, care estimează valoarea acestora. Acest design susține controlul continuu, dar introduce surse interdependente de eroare de estimare. Învățarea prin întărire profundă depinde, așadar, de aceleași fundamente ca învățarea profundă, descendența de gradient și propagarea înapoi.
De ce buffer‑urile de redare și rețelele țintă ajută
Mostrele de experiență succesive sunt corelate, în timp ce o actualizare a rețelei modifică țintele folosite de actualizările ulterioare. Redarea experienței rupe o parte din această corelație temporală prin eșantionarea tranzițiilor mai vechi. O rețea țintă se schimbă mai lent decât rețeaua online, făcând țintele bootstrap mai puțin volatile.
Aceste mecanisme îmbunătățesc stabilitatea antrenamentului, dar reglajul rămâne esențial. Rata de învățare, programul de explorare, scala recompensei, compoziția buffer‑ului și capacitatea rețelei pot modifica rezultatul. Ar trebui raportate mai multe semințe aleatoare, deoarece o singură rulare poate fi înșelătoare.
Învățare prin întărire offline, RL bazat pe model și simulare‑la‑real
Învățarea prin întărire offline învață dintr-un set de date înregistrat fix, fără a colecta noi interacțiuni. Poate fi utilă când explorarea este costisitoare sau periculoasă, dar politica trebuie să evite acțiunile slab reprezentate în jurnal. RL bazat pe model învață sau folosește un model de tranziție pentru planificare, schimbând presupuneri suplimentare pentru eficiență de eșantionare.
În robotică se antrenează adesea în simulare, se randomizează parametrii fizici, apoi se ajustează sau validează pe hardware. Diferența de realitate poate expune în continuare erori de percepție, sincronizare, dinamică de contact și cazuri limită nedefinite. Un sistem de învățare prin întărire ar trebui evaluat sub perturbații, schimbări de distribuție și constrângeri explicite de siguranță.
Evaluare și implementare
O evaluare utilă separă mediile de antrenament și test, raportează distribuțiile de randament în loc de un singur scor maxim și verifică încălcările de constrângere, frecvența intervențiilor și comportamentul în cel mai rău caz. Pentru sisteme reale, echipele au nevoie și de monitorizare, proceduri de revenire, spații de acțiune limitate și o intervenție umană.
Învățarea prin întărire profundă este cea mai convingătoare când deciziile sunt secvențiale, feedback‑ul este disponibil și regulile de control scrise manual sunt insuficiente. Este o alegere slabă când etichetele supravegheate sunt abundente, un optimizer convențional rezolvă problema sau explorarea ar pune în pericol oameni sau active.
Arhitecturi Deep RL și semnale de antrenament
Învățarea prin întărire profundă folosește rețele neuronale pentru a reprezenta o funcție de valoare, politică, model de mediu sau o combinație a acestora. O rețea Q profundă prezice valorile acțiunilor și învață din țintele de diferență temporală; redarea experienței reduce corelația dintre actualizări, în timp ce o rețea țintă stabilizează obiectivul în mișcare. Metodele de gradient de politică optimizează direct randamentul așteptat, iar metodele actor‑critic utilizează un critic învățat pentru a reduce varianta gradientului. Acțiunile continue necesită adesea variante deterministe sau stocastice actor‑critic, în timp ce acțiunile discrete de dimensiune mare cer o explorare atentă și un design al ieșirii.
Antrenamentul este non‑staționar deoarece politica modifică datele pe care le colectează. Datele de redare devin off‑policy, țintele bootstrap depind de estimările curente, iar aproximarea funcțională poate amplifica erorile – combinația cunoscută uneori ca „triada mortală”. Estimatoarele duble reduc supraestimarea valorii; funcțiile de avantaj îmbunătățesc atribuirea creditului; bonusurile de entropie încurajează explorarea; obiectivele tăiate restricționează actualizările distructive ale politicii. Normalizați observațiile și recompensele numai cu stare sigură de scurgere și înregistrați mediul, wrapper‑ul, repetarea acțiunii, terminarea și preprocesarea recompensei, deoarece fiecare modifică problema.
Evaluare, simulatoare și siguranța în implementare
Raportați distribuțiile de randament pe semințe și instanțe de mediu independente, nu cea mai bună rulare. Evaluați eficiența eșantionului, încălcările de constrângere, rezultatele catastrofale, sensibilitatea la scala recompensei și robustețea la zgomotul observațional, întârziere, eroare de actuator și schimbări de dinamică. Comparați cu control scriptat, control clasic, imitație supravegheată și RL mai simplu. Rețineți variațiile de mediu și testați metrici de rezultat fără recompensă, deoarece un agent poate exploata recompensa programată fără să îndeplinească sarcina intenționată. Inspectarea video și a traiectoriilor dezvăluie adesea comportamente ascunse de randamentul agregat.
Simularea permite explorarea, dar introduce un decalaj de realitate. Randomizați fizica și percepția relevante, calibrați pe măsurători reale și folosiți transfer conservator. Datele înregistrate sau RL offline evită explorarea online, dar nu poate evalua în mod fiabil acțiuni neacoperite de politica de comportament. Sistemele de producție ar trebui să limiteze setul de acțiuni, rata, resursele și domeniul de operare; să solicite aprobare pentru acțiuni cu impact ridicat și să includă un controler sigur verificat sau oprire. Monitorizați intrările politicii, distribuția acțiunilor, recompensa, rezultatele reale și intervențiile, cu revenire la o versiune testată a politicii.
Un exemplu concret de control
Pentru rutarea roboților din depozit, definiți starea din locație, încărcătură, nivelul bateriei, traficul din apropiere și coada de sarcini; acțiunile din mișcările permise și deciziile de încărcare; și recompensa din munca finalizată, consumul de energie, congestia și constrângerile de siguranță. Antrenați mai întâi într-un simulator calibrat cu cerere randomizată și defecte de senzori, apoi replicați deciziile reale. Nu permiteți niciodată politicii învățate să ocolească evitarea coliziunilor. Evaluați debitul împreună cu aproape accidente, blocaje, urgențe ale bateriei și întârzierea în cel mai rău caz. Proiectul reușește numai dacă sistemul stratificat îmbunătățește operațiunile fără să transfere riscul inacceptabil de explorare către oameni sau echipamente.
Exemplu practic: DRL pentru răcirea centrelor de date
Un centru de date restricționează un agent RL la setpoint‑uri de răcire aprobate și îl antrenează într-un simulator calibrat pe date istorice de vreme, sarcină de lucru, temperaturi și răspunsul echipamentului. Recompensa include energia, dar constrângerile stricte protejează separat temperatura, umiditatea și ciclarea echipamentului. Controlul predictiv pe model și regulile existente sunt repere. Evaluarea acoperă sezoane, zgomot de senzor, întârziere de actuator, pierderi de echipament, sarcini neobișnuite și multiple semințe, raportând energie, încălcări, variație și recuperare.
Politica învățată rulează în mod shadow înainte de un trial pe o zonă limitată. Un controler de siguranță extern taie acțiunile și operatorii pot interveni. Rata de acțiune, acoperirea stării, incertitudinea modelului și rezultatele reale ale facilității sunt monitorizate; neconcordanța simulatorului sau intervențiile repetate declanșează revenirea. Echipamentele sau logica de control actualizate creează o nouă versiune a mediului și validare. Economiile de energie sunt acceptate numai când fiabilitatea, marja termică, mentenanța și răspunsul la defecțiuni rămân cel puțin la fel de puternice ca reperele.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecințele fiecărui eșec important. Stabiliți o bază reproducibilă și un set de evaluare versionat înainte de reglare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi de dependență, utilizare greșită și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii alături de calibrare sau incertitudine, latență, debit, costul resurselor, accesibilitate, confidențialitate și securitate. Înregistrați fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, alocați autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o implementare etapizată, păstrați un fallback sigur și verificați monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevalueați ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și retenție, și un punct clar la care trebuie dezactivat sau înlocuit.
Întrebări frecvente
Este învățarea prin întărire profundă aceeași cu învățarea profundă?
Nu. Învățarea profundă furnizează aproximatorii de funcții; învățarea prin întărire furnizează interacțiunea, recompensa și obiectivul de decizie secvențială.
Înseamnă o recompensă mare că agentul a învățat comportamentul dorit?
Nu neapărat. Înseamnă că politica a găsit un comportament care obține un scor bun în cadrul recompensei și mediului implementate. Teste independente de siguranță și de aliniere a obiectivelor sunt încă necesare.
Referințe principale












