
Fundamentele AI
Învățare Supervizată vs Învățare Nesupervizată

 Adaugă Unite.AI la sursele tale preferate pe Google
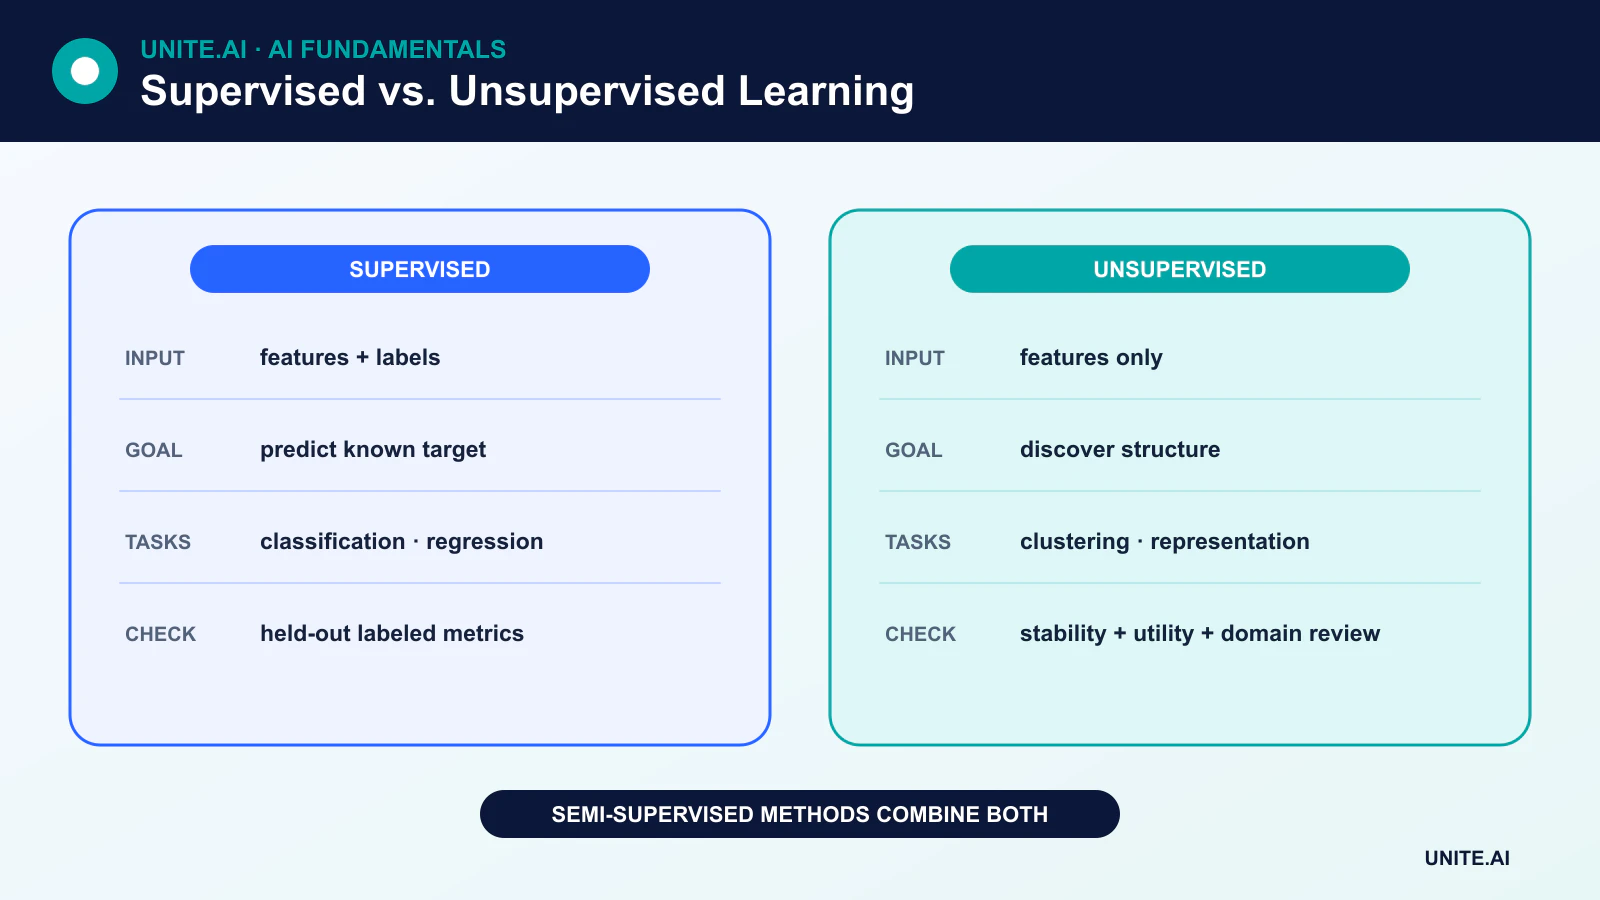
Învățarea supervizată învață din exemple asociate cu răspunsuri țintă. Învățarea nesupervizată caută structură în date fără etichete țintă. Diferența nu constă în care abordare este mai inteligentă sau mai precisă; ci în tipul semnalului de învățare disponibil și în întrebarea la care sistemul este conceput să răspundă.
Acestea sunt două paradigme majore în cadrul învățării automate, dar sistemele moderne utilizează și învățarea semi-supervizată, auto-supervizată și învățarea prin recompensă.
Aspecte cheie
- Învățarea supervizată prezice o țintă cunoscută; învățarea nesupervizată descoperă tipare sau reprezentări.
- Clasificarea și regresia sunt sarcini supervizate; gruparea, estimarea densității și multe metode de reducere a dimensiunii sunt nesupervizate.
- Ieșirile nesupervizate nu sunt automat clase din lumea reală și pot fi mai greu de evaluat.
- Costul computațional și acuratețea depind de algoritm, date, sarcină și evaluare — nu doar de paradigmă.
Cum funcționează învățarea supervizată
Un set de date supervizat conține caracteristici X și o țintă y. Antrenarea ajustează un model astfel încât predicțiile sale să aproximeze țintele. Evaluarea folosește exemple etichetate păstrate pentru a estima cât de bine se generalizează.
Clasificare
Clasificarea prezice o categorie: spam sau non-spam, un subiect de document dintre mai multe, sau unul sau mai multe obiecte într-o imagine. Metriile relevante includ precizia, recall-ul, F1, calibrul și măsurile sensibile la costuri. Acuratețea poate fi înșelătoare când o clasă este rară; o matrice de confuzie arată care clase sunt confundate.
Regresie
Regresia prezice o valoare continuă, cum ar fi cererea, durata sau temperatura. Regresia liniară poate folosi una sau multe caracteristici; nu se limitează la relația dintre două variabile. Metriile de regresie includ eroarea medie absolută, rădăcina pătrată a erorii medii și costurile specifice sarcinii.
Algoritmi supervizați comuni
Metodele supervizate includ modele liniare și logistice, arbori de decizie, păduri aleatoare, gradient boosting, mașini cu vectori de susținere, vecini cei mai apropiați (K-NN), și rețele neuronale.
Regresia logistică produce un scor sau o probabilitate care poate fi convertită într-o clasă utilizând un prag ales. O frunză a unui arbore de decizie conține o predicție bazată pe o regiune a spațiului de caracteristici, nu neapărat pe o singură observație de antrenament. KNN prezice pe baza exemplelor de antrenament etichetate din apropiere și necesită în continuare un design solid de antrenare/validare/testare.
Cum funcționează învățarea nesupervizată
Învățarea nesupervizată primește caracteristici fără o coloană țintă. Obiectivul său este definit indirect — de exemplu, minimizarea distanței în interiorul grupurilor, reconstrucția unei intrări, estimarea densității datelor sau păstrarea cât mai multă variație posibilă în mai puține dimensiuni.
Grupare
K-means atribuie puncte unui număr ales de grupuri și actualizează centrele grupurilor pentru a reduce distanța pătratică în interiorul grupului. Algoritmul descoperă grupări geometrice sub o anumită distanță și reprezentare a caracteristicilor. Aceste grupuri nu corespund automat tipurilor semnificative de clienți, diagnosticelor sau altor etichete de domeniu.
Reducerea dimensionalității
Reducerea dimensionalității reprezintă datele folosind un număr mai mic de variabile. Analiza componentelor principale găsește direcții ortogonale care păstrează cât mai multă variație posibilă sub o proiecție liniară. Alte metode păstrează noțiuni diferite de structură și pot genera vizualizări foarte diferite.
Anomalii și estimarea densității
Metodele nesupervizate pot estima unde datele sunt dense și pot semnala observații neobișnuite. Un scor de anomalie nu dovedește fraudă, defecțiune sau comportament malițios; identifică o deviație în cadrul reprezentării și modelului alese.
Cum se evaluează învățarea nesupervizată
Nu există o noțiune universală de „acuratețe” nesupervizată. Un practician poate folosi metrici interne precum scorul siluetei, poate compara stabilitatea între eșantioane, poate testa utilitatea într-o sarcină ulterioară, sau poate întreba experții din domeniu dacă structura descoperită este semnificativă. Dacă există etichete de referință pentru evaluare, metricile externe de grupare pot fi utilizate fără a transforma procesul de antrenare în învățare supervizată.
Dincolo de comparația binară
Învățare semi-supervizată
Învățarea semi-supervizată combină un set mic etichetat cu un set mare neetichetat. Pseudo-etichetarea, regularizarea consistenței și metodele bazate pe grafuri sunt exemple. Datele neetichetate trebuie totuși să semene suficient de mult cu distribuția țintă pentru a fi de ajutor.
Învățare auto-supervizată
Învățarea auto-supervizată derivă țintele din însăși intrarea, cum ar fi prezicerea token-urilor mascate sau potrivirea vederilor transformate. Este o bază pentru modelele moderne de limbaj, viziune și multimodale, inclusiv transformerele.
Învățare prin recompensă
Învățarea prin recompensă optimizează deciziile prin recompense generate prin interacțiune. Se diferențiază atât de predicția etichetată, cât și de descoperirea statică de tipare.
Alegerea abordării potrivite
Începeți cu decizia sau insight-ul pe care sistemul trebuie să îl producă. Dacă există ținte fiabile și scopul este predicția, învățarea supervizată este naturală. Dacă obiectivul este explorarea, reprezentarea sau gruparea, o metodă nesupervizată poate fi adecvată. Când etichetele sunt rare, pre-antrenarea auto-supervizată sau semi-supervizată urmată de evaluare supervizată poate fi mai eficientă.
În orice caz, scurgerea de date, eșantionarea părtinitoare, proxy-urile slabe și schimbarea distribuției pot domina alegerea algoritmului. Un model tehnic corect antrenat pe un obiectiv greșit poate totuși eșua.
Semnale de învățare, obiective și metode reprezentative
Învățarea supervizată folosește exemple asociate cu etichete sau valori țintă și optimizează eroarea predictivă. Clasificarea, regresia, rangarea și predicția structurată diferă în ieșire și funcție de pierdere. Învățarea nesupervizată caută structură fără etichete țintă prin grupare, estimarea densității, reducerea dimensionalității, învățarea de reprezentare sau modelarea generativă. Învățarea auto-supervizată creează ținte de predicție din datele în sine, în timp ce învățarea semi-supervizată combină un set mic etichetat cu date neetichetate mai mari. Aceste categorii descriu semnalul de învățare; aceeași arhitectură neuronală poate fi antrenată sub mai multe paradigme.
Etichetele fac un obiectiv explicit, dar introduc costuri de adnotare, zgomot, presupuneri de politică și întârziere temporală. Datele neetichetate sunt mai ușor de colectat, dar nu spun unui algoritm care structură descoperită este utilă. Un grup poate reflecta iluminarea, lungimea documentului sau sursa de achiziție în loc de o categorie semnificativă. Definiți evaluarea independent: modelele supervizate folosesc rezultate etichetate păstrate, în timp ce modelele nesupervizate au nevoie de stabilitate, reconstrucție, verosimilitate, recuperare, utilitate ulterioară sau validare de expert. Separarea vizuală singură nu este dovada unei structuri valide.
Alegerea unei paradigme și prevenirea erorilor comune
Utilizați învățarea supervizată când există o țintă stabilă și etichete reprezentative. Folosiți explorarea nesupervizată pentru a rezuma, detecta noutăți, comprima sau genera ipoteze, dar tratați ieșirile ca provizorii. Pre-antrenarea auto-supervizată este valoroasă când datele brute sunt abundente și sarcinile ulterioare împărtășesc reprezentări. Metodele semi-supervizate ajută numai când presupunerile despre datele neetichetate și structura de clasă sunt valide. Comparați cu linii de bază simple și țineți cont de costul total al colectării, etichetării, revizuirii, calculului și erorilor, în loc să presupuneți că neetichetat înseamnă automat ieftin.
Preveniți scurgerea separând entitățile legate înainte de a deriva etichete, augmentări sau pseudo-etichete. Monitorizați echilibrul claselor, acordul adnotărilor, stabilitatea grupărilor, colapsul și deriva. Pseudo-etichetele pot consolida greșelile timpurii; gruparea poate codifica atribute sensibile; o reprezentare pre-antrenată poate transfera părtinirea sursei. Revizia umană ar trebui să se concentreze pe cazurile de frontieră și consecințele acestora. În producție, documentați cum a fost creat semnalul de învățare și când devine învechit. Paradigma determină unde intră supravegherea în sistem, nu dacă există alegeri și valori umane.
Exemplu practic: descoperirea și etichetarea subiectelor de suport
O companie folosește mai întâi încorporări nesupervizate și grupare pentru a explora temele din mesajele de suport de-identificate. Analiștii inspectează exemple reprezentative și de frontieră și constată că unele grupuri reflectă lungimea mesajului și canalul, mai degrabă decât problemele. Ei dezvoltă o taxonomie supervizată cu o clasă necunoscută, ghid de adnotare și acord măsurat. Un clasificator este apoi evaluat pe perioade de timp ulterioare, limbi și produse, în comparație cu linii de bază de cuvinte cheie și vecini cei mai apropiați.
Mesajele noi neetichetate susțin descoperirea deriva, dar nu reantrenează automat clasificatorul. Revizorii etichetează cazuri selectate incert și emergente prin învățare activă, cu verificări de calitate și un set de evaluare sigilat. Monitorizarea urmărește prevalența subiectelor, încrederea, dezacordul și rezultatele de rutare. Când este lansat un produs nou, taxonomia și capacitatea echipelor ulterioare sunt actualizate împreună. Fluxul de lucru folosește metode nesupervizate pentru generarea de ipoteze și dovezi supervizate pentru rutarea operațională.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, responsabilul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbarea distribuției, întreruperea dependențelor, utilizarea incorectă și grupurile sau mediile cel mai probabil subservite. Măsurați calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare etapizată, păstrați o revenire sigură și verificați monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care trebuie să fie dezactivat sau înlocuit.
Referințe principale












