
Fundamentele AI
Ce este KNN (K-Nearest Neighbors)?

 Adaugă Unite.AI la sursele tale preferate pe Google
K-nearest neighbors (KNN) prezice un rezultat pe baza exemplelor de antrenament etichetate cele mai apropiate de un punct de interogare. Pentru clasificare, vecinii votează clasa. Pentru regresie, valorile țintă ale acestora sunt mediate sau combinate în alt mod.
KNN este o metodă bazată pe instanțe, negeneralizatoare: antrenarea constă în principal în stocarea exemplelor de antrenament și, opțional, a unui index de căutare. Aceasta nu elimină necesitatea împărțirii în seturi de antrenament, validare și testare. Evaluarea pe date reținute este esențială pentru alegerea k, a metricii de distanță, a prelucrării caracteristicilor și a regulii de votare.
Aspecte cheie
- KNN prezice local; nu împarte mai întâi setul de date în clustere.
- Scalarea caracteristicilor este critică deoarece distanța definește care exemple sunt considerate vecini.
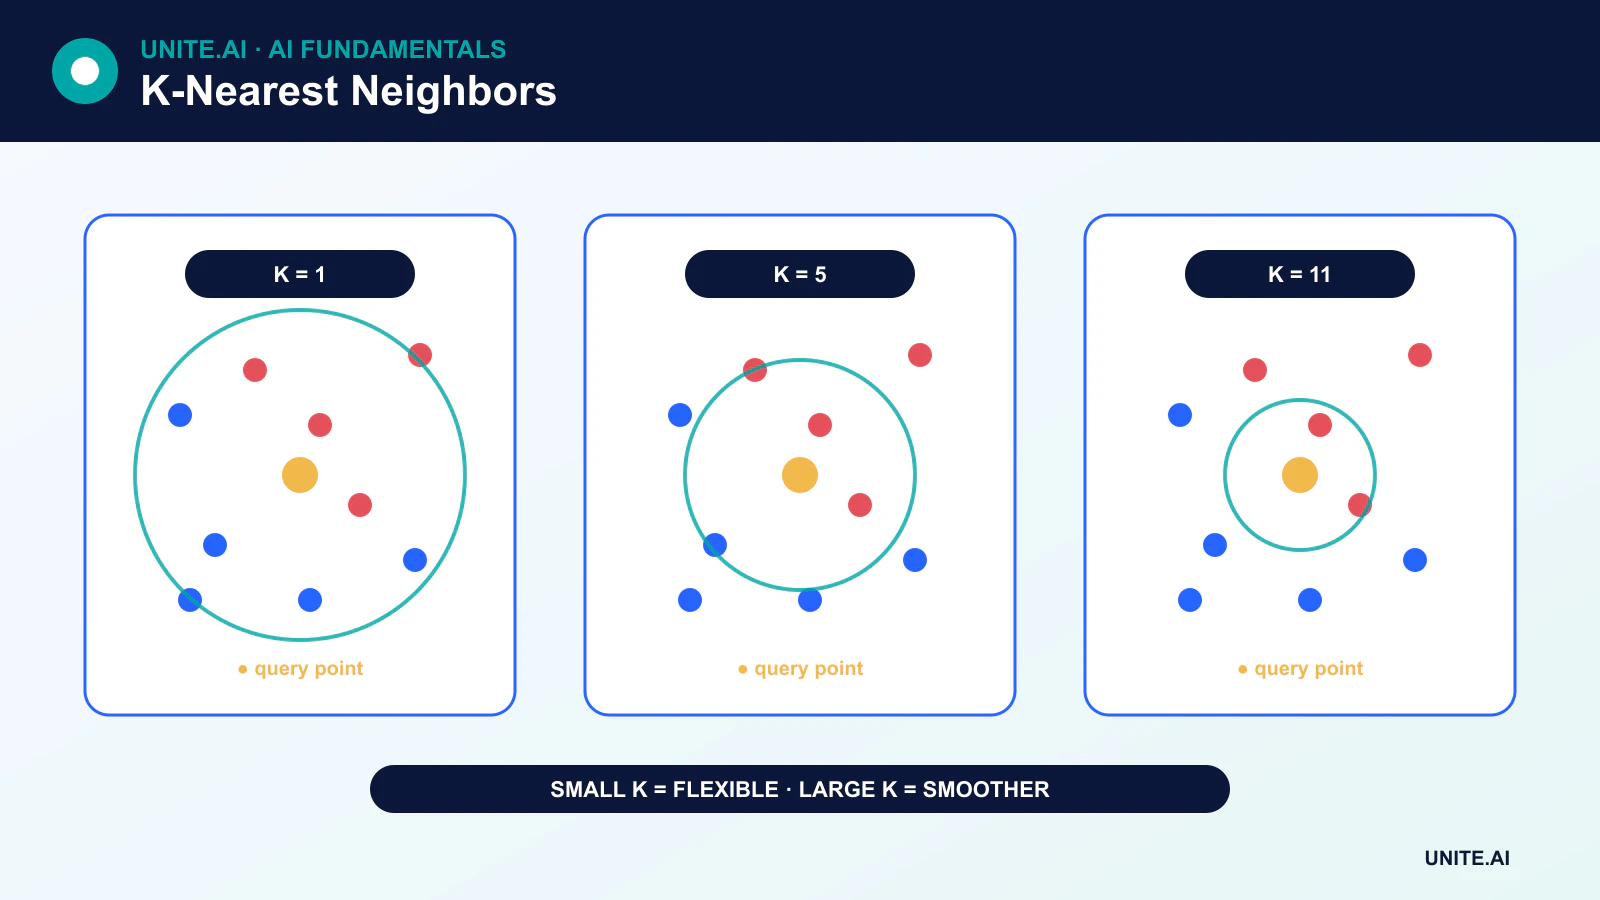
- Un k mic poate fi zgomotos, în timp ce un k mare poate netezi structura locală.
- Dimensiunile mari, caracteristicile irelevante, dezechilibrul de clase și căutarea lentă pot limita performanța.
Cum funcționează clasificarea KNN
- Reprezintă interogarea și exemplele de antrenament în același spațiu de caracteristici.
- Calculează distanța de la interogare la exemplele de antrenament.
- Selectează cele k exemple cele mai apropiate.
- Prezice clasa majoritară sau folosește votarea ponderată în funcție de distanță.
Votarea ponderată acordă vecinilor mai apropiați o influență mai mare. Egalitățile necesită o regulă documentată, iar vecinii aflate la aceeași distanță cu etichete diferite pot face ca rezultatele să depindă de ordinea sau detaliile de implementare.
Regresia KNN
Pentru regresie, predicția este de obicei media valorilor țintă ale vecinilor. Ponderarea în funcție de distanță poate reduce influența observațiilor mai îndepărtate. Mediana sau agregarea robustă pot fi utile când valorile locale conțin valori aberante.
Metrici de distanță
Distanța euclidiană este comună pentru caracteristici continue, distanța Manhattan însumează diferențele absolute, iar distanța cosinus se concentrează pe direcție mai degrabă decât pe magnitudine. Alte metrici se aplică datelor binare, categorice, geografice, secvențiale sau încorporărilor învățate.
A numi KNN „non-parametric” înseamnă că nu presupune o formă funcțională fixă, finită dimensională pentru limita de decizie. Totuși, presupune că reprezentarea și metrica selectate fac ca punctele apropiate să fie relevante unele pentru altele.
De ce este importantă scalarea
Dacă o caracteristică variază de la 0 la 1 și alta de la 0 la 100.000, distanța euclidiană obișnuită va fi dominată de a doua caracteristică. Standardizarea, normalizarea sau transformările specifice domeniului trebuie să fie ajustate pe partiția de antrenament și apoi aplicate pe datele de validare, test și producție.
Caracteristicile irelevante de asemenea distorsionează vecinătățile. Selecția de caracteristici, reducerea dimensionalității sau reprezentările învățate pot ajuta, dar fiecare alegere trebuie validată fără scurgeri de date.
Alegerea valorii k
Cu k = 1, modelul poate urmări zgomotul și exemplele etichetate greșit. Pe măsură ce k crește, predicțiile devin mai netede și mai puțin sensibile la un singur punct. Dacă k devine prea mare, clasele sau regiunile îndepărtate domină și modelul subînvață.
Alege k prin validare încrucișată pe datele de antrenament. Pentru clasificarea binară, un k impar reduce, dar nu elimină, egalitățile. Ponderile claselor, împărțirile stratificate, alegerea pragului și metricile adecvate contează când clasele sunt dezechilibrate.
Blestemul dimensionalității
În spații cu dimensiuni mari, distanțele pot deveni mai puțin informative deoarece exemplele sunt rare și distanțele dintre cele mai apropiate și cele mai îndepărtate devin relativ similare. KNN poate necesita cantități enorme de date pentru a menține vecinătăți locale semnificative. Acesta este blestemul dimensionalității.
Reducerea dimensionalității sau încorporările specifice sarcinii pot ajuta, dar geometria unei încorporări trebuie validată pentru noțiunea de similaritate dorită.
Performanța căutării
O interogare prin forță brută compară punctul nou cu fiecare exemplu stocat. Arborii KD și arborii balenă accelerează unele căutări exacte, deși beneficiile lor scad în dimensiuni mari. Indexurile de vecini apropiați aproximativi sacrifică o mică parte din recall pentru câștiguri mari de viteză și memorie. Această idee susține, de asemenea, căutarea de similaritate vectorială.
Puncte forte și limitări
KNN este simplu, susține limite de decizie neregulate și oferă o explicație intuitivă bazată pe exemple. De asemenea, poate necesita memorie substanțială, poate expune exemple de antrenament sensibile, poate prezice lent și se comportă slab când distanța nu are sens. Este un punct de referință util – nu o metodă care este implicit foarte precisă pe majoritatea problemelor.
Distanță, vecinătăți și comportamentul hiperparametrului
K-nearest neighbors stochează exemplele de antrenament și prezice pe baza celor k cele mai apropiate conform unei distanțe alese. Clasificarea folosește un vot majoritar sau ponderat în funcție de distanță; regresia mediază țintele vecinilor. Scalarea este esențială deoarece o caracteristică cu interval mare poate domina distanța euclidiană. Datele categorice, rare, secvențiale sau geografice pot necesita distanțe Hamming, cosinus, de editare, de mare cerc sau învățate. Metriul este o presupunere de modelare a similarității și ar trebui validat în raport cu semnificația reală a cazurilor apropiate.
Un k mic creează limite flexibile, cu variabilitate ridicată și sensibilitate la zgomot; un k mare netezește predicțiile și poate șterge structura minoritară. Un k impar evită doar unele egalități binare și nu este o regulă generală. Alege k, distanța, ponderarea, setul de caracteristici și preprocesarea în cadrul validării încrucișate. Dezechilibrul de clase poate face ca votul majoritar local să ignore rezultate rare, așa că inspectează recall-ul pe clasă și compoziția vecinătății. Distanțele în dimensiuni mari tind să se concentreze, iar caracteristicile irelevante degradează vecinătățile; selecția, reducerea dimensionalității sau încorporările învățate pot ajuta.
Indexare, incertitudine și operare în producție
Inferența naivă compară o interogare cu fiecare punct de antrenament. Arborii KD și arborii balenă ajută în dimensiuni mici adecvate; indexurile de vecini apropiați aproximativi sacrifică exactitatea pentru viteză și scară. Măsoară recall-ul căutării de vecini separat de calitatea predictivă. Memoria include caracteristicile stocate, etichetele și structurile de index. Actualizările sunt conceptual simple, dar pot necesita reconstrucții de index, consistență a versiunilor și propagarea ștergerilor. Protejează exemplele sensibile de antrenament deoarece returnarea vecinilor sau a distanțelor poate expune înregistrări.
KNN poate expune exemple care fac o predicție ușor de înțeles, dar apropierea nu înseamnă cauzalitate sau echitate. Furnizează distanța, marja de vot și o regulă de abstinență când vecinătățile sunt rare sau conflictuale. Monitorizează distanța interogării, etichetele vecinilor, deriva caracteristicilor, latența și rezultatele confirmate. Menține sincronizate versiunile de preprocesare și de index și testează rezultatele exacte versus aproximative după modificări. KNN este un punct de referință local eficient și o metodă de recuperare când distanța are sens; are dificultăți când similaritatea nu poate fi reprezentată prin caracteristicile disponibile.
Exemplu practic: KNN pentru substituirea produselor
Un retailer reprezintă produsele cu atribute numerice standardizate, compatibilitate categorică și o încorporare textuală învățată, apoi definește o distanță ponderată revizuită de merchandiseri. K și ponderile sunt selectate pe baza lansărilor ulterioare de produse, nu pe rânduri aleatorii de articole. Evaluarea verifică recall-ul substitutelor relevante, recomandările incompatibile, distanța, acoperirea categoriei și rezultatele pentru articole rare. Un punct de referință al popularității arată dacă similaritatea locală adaugă valoare.
Un index aproximativ este comparat cu vecinii exacți pentru recall și latență. Interogările fără un articol compatibil apropiat nu returnează nicio sugestie, ci niciun vecin forțat. Ștergerile de produse și corecțiile de atribute se propagă în index prin actualizări versionate. Monitorizarea urmărește distribuțiile de distanță, rezultatele goale, suprascrierile și rezultatele comerciale fără a confunda vânzările cu compatibilitatea reală. Termenii sensibili ai furnizorilor sunt excluși din explicații, iar exemplele returnate rămân dovezi ale similarității – nu o afirmație că produsele sunt echivalente.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definește utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, responsabilul și consecința fiecărui eșec important. Stabilește un punct de referință reproductibil și un set de evaluare versionat înainte de ajustare. Testează cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi de dependență, utilizare greșită și grupurile sau mediile cel mai probabil neacoperite. Măsoară calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrează fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuie autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Folosește o implementare etapizată, păstrează o revenire sigură și verifică monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, starea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definește praguri de alertă și un responsabil de răspuns, apoi revizuiește dovezile din viața reală după implementare în loc să presupui că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se modifică. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
KNN are o fază de antrenament?
Are puțină ajustare a parametrilor, dar are totuși un proces de dezvoltare: preprocesarea este învățată din datele de antrenament, se poate construi un index, iar k, metrica, ponderile și caracteristicile sunt selectate prin validare.
KNN este același lucru cu K-means?
Nu. KNN este în principal o metodă de predicție locală supravegheată. K-means este un algoritm de grupare nesupravegheat în care K reprezintă numărul de centre de cluster.
Referințe principale












