
Fundamentele AI
Ce este o matrice de confuzie?

 Adaugă Unite.AI la sursele tale preferate pe Google
O confusion matrix este un tabel care numără de câte ori predicțiile unui clasificator sunt de acord sau în dezacord cu etichetele cunoscute. Ea dezvăluie care clase sunt confundate și furnizează numărarea utilizată pentru calcularea metricilor precum precizia, recall‑ul, specificitatea și F1. Este unul dintre instrumentele de diagnostic de bază pentru problemele de clasificare în învățarea supravegheată.
Matricea în sine nu este un scor unic de performanță. Este o vedere structurată a rezultatelor la un anumit prag de decizie, set de date și definiție a clasei.
Aspecte cheie
- Pentru clasificarea binară, cele patru rezultate sunt adevărat pozitiv, fals pozitiv, fals negativ și adevărat negativ.
- Etichetați întotdeauna axele: bibliotecile și publicațiile nu plasează întotdeauna clasele reale și cele prezise în aceeași orientare.
- Acuratețea poate ascunde erori serioase când clasele sunt dezechilibrate.
- Modificarea pragului de clasificare schimbă matricea de confuzie și compromisului dintre precizie și recall.
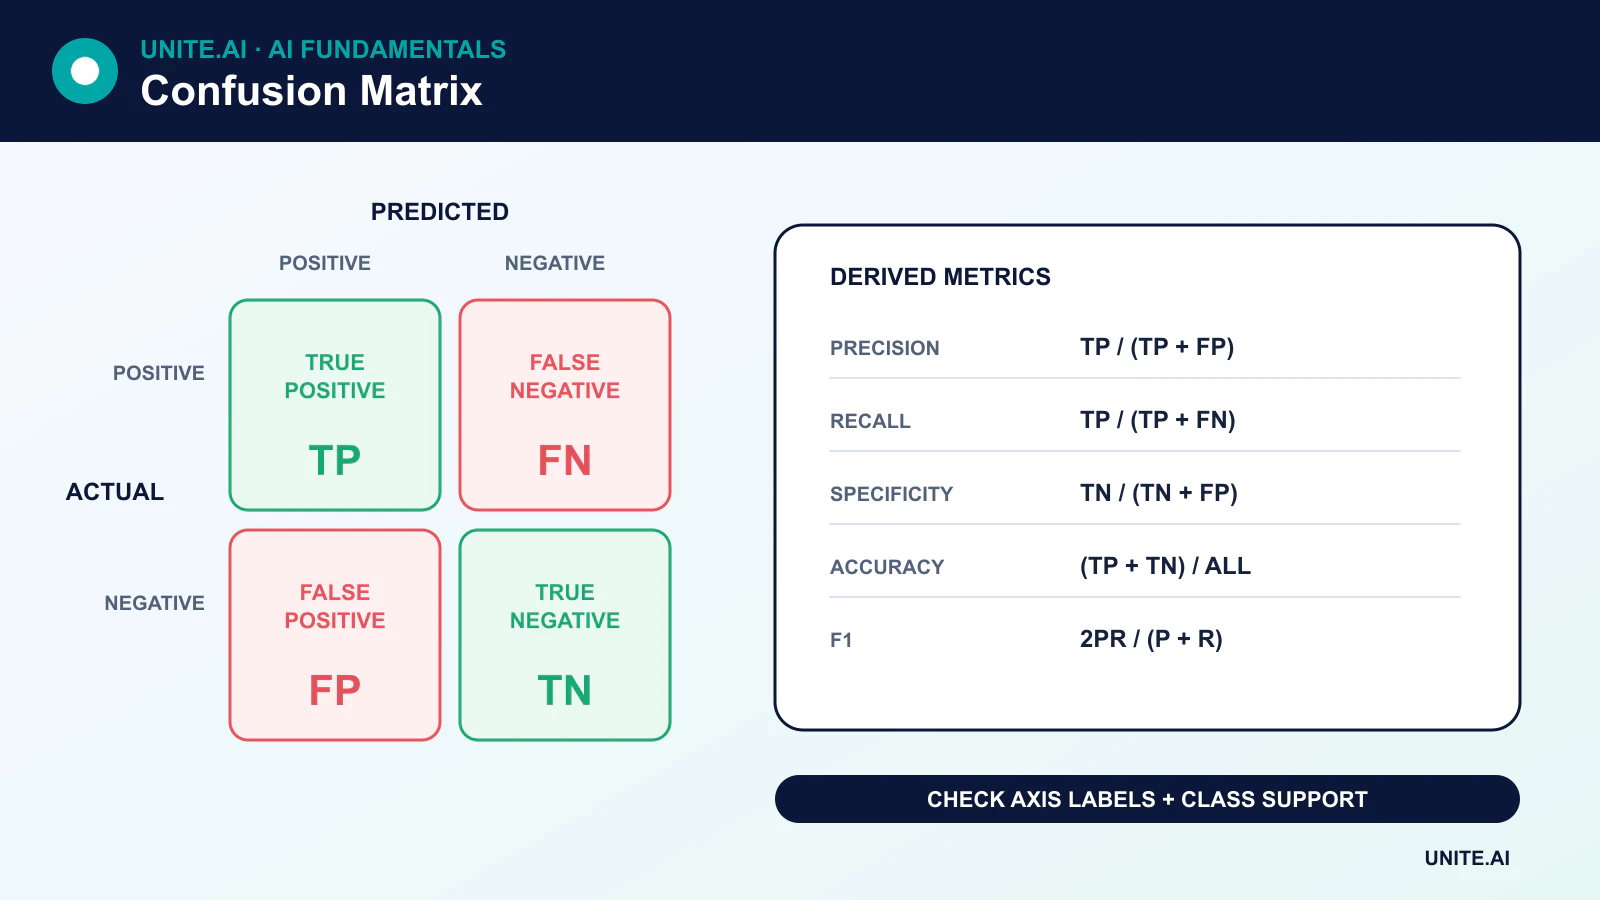
Cele patru rezultate ale clasificării binare
- True positive (TP): Adevărat pozitiv (TP): exemplul este pozitiv și modelul prezice pozitiv.
- False positive (FP): Fals pozitiv (FP): exemplul este negativ, dar modelul prezice pozitiv.
- False negative (FN): Fals negativ (FN): exemplul este pozitiv, dar modelul prezice negativ.
- True negative (TN): Adevărat negativ (TN): exemplul este negativ și modelul prezice negativ.
În convenția scikit-learn, rândurile reprezintă clasele reale și coloanele clasele prezise. Alte vizualizări pot transpune această aranjare, astfel că etichetele – nu pozițiile din colț – ar trebui să ghideze interpretarea.
Metrici derivate dintr-o matrice de confuzie
Precizie
Precision = TP / (TP + FP)
Precizia răspunde: dintre exemplele prezise ca pozitive, ce proporție a fost de fapt pozitivă?
Recall sau sensibilitate
Recall = TP / (TP + FN)
Recall răspunde: dintre toate exemplele pozitive reale, ce proporție a fost identificată de model? În clasificarea binară, recall‑ul clasei pozitive este numit și sensibilitate sau rata de adevărat pozitiv.
Specificitate
Specificity = TN / (TN + FP)
Specificitatea este recall‑ul pentru clasa negativă: dintre negativele reale, ce proporție a fost respinsă corect de model?
Acuratețe
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Acuratețea este utilă când clasele și costurile erorilor sunt relativ echilibrate. Poate fi înșelătoare când o clasă domină.
Scorul F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1 rezumă precizia și recall‑ul printr-o medie armonică. Ignoră adevăratele negative, astfel că nu este rezumatul potrivit pentru fiecare sarcină.
Un exemplu practic
Presupunem că un set de testare conține 1.000 de tranzacții. Cincizeci sunt frauduloase. Un model găsește 40 dintre acele fraude, dar semnalează 30 de tranzacții legitime:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Modelul are o acuratețe de 96%, dar precizia este de aproximativ 57% și recall‑ul 80%. Acuratețea ridicată este determinată în mare parte de numărul mare de tranzacții legitime. Acceptabilitatea acestui model depinde de costul fraudei ratate, capacitatea de investigație și de gradul de calibrare al scorurilor de risc.
Pragurile modifică matricea
Multe clasificatoare produc un scor în loc de un răspuns inevitabil da/nu. Scăderea pragului pozitiv crește în general recall‑ul și fals‑pozitivele; creșterea acestuia crește în general precizia sau specificitatea, în timp ce ratează mai multe pozitive. Pragul trebuie ales utilizând date de validare și costuri reale ale erorilor, nu fixat automat la 0,5.
Curbele precision‑recall și ROC rezumă performanța pe diferite praguri. Curbele precision‑recall sunt adesea mai informative când clasa pozitivă este rară.
Matrice de confuzie multiclasa
Pentru K clase, matricea este K × K. Predicțiile corecte se află pe diagonală; celulele off‑diagonală arată care perechi de clase sunt confundate. Metriile pe clasă pot fi mediate în diferite moduri:
- Macro average: Media macro: acordă fiecărei clase greutate egală.
- Weighted average: Media ponderată: ponderă fiecare clasă în funcție de numărul de exemple.
- Micro average: Media micro: agregă numărarea rezultatelor înainte de a calcula metrica.
Raportarea unei singure medii poate ascunde performanțe slabe la clasele mai mici. Includeți numărul de exemple (support) și rezultatele pe clasă acolo unde diferențele contează.
Greșeli comune
- Citirea unei matrice transpuse fără a verifica etichetele axelor.
- Calcularea metricilor din datele de antrenament în loc de un set de validare adecvat.
- Ignorarea prevalenței clasei, a strategiei de eșantionare sau a entităților duplicate între partiții.
- Compararea matricelor generate la praguri diferite fără a menționa schimbarea.
- Tratarea tuturor fals‑pozitive și fals‑negative ca având același cost.
Prin urmare, o matrice de confuzie este un instrument de diagnostic, nu o evaluare completă. Calibrarea, analiza subgrupurilor, robustețea și consecințele ulterioare fac, de asemenea, parte din revizia de clasificare.
Citirea fiecărui celule și derivarea metricilor utile
Pentru clasificarea binară, matricea de confuzie numără adevăratele pozitive, fals‑pozitivele, fals‑negativele și adevăratele negative pentru o clasă pozitivă și un prag alese. Acuratețea împarte predicțiile corecte la toate cazurile; precizia întreabă ce fracțiune a pozitivelor prezise a fost corectă; recall‑ul întreabă ce fracțiune a pozitivelor reale a fost găsită; specificitatea măsoară negativele reale respinse corect. F1 este media armonică a preciziei și a recall‑ului. Niciuna nu este în mod inerent superioară: screening‑ul fraudei, triajul medical și filtrarea spamului atribuie consecințe diferite acelorași celule.
Pentru probleme multiclasa, rândurile reprezintă de obicei clasele reale și coloanele clasele prezise, deși convențiile variază, astfel că etichetele trebuie să fie explicite. Numărarea one‑vs‑rest produce precizia și recall‑ul pe fiecare clasă. Media macro ponderă clasele în mod egal; media micro agregă deciziile și favorizează clasele comune; media ponderată urmează suportul clasei. Sarcinile multilabel permit mai multe etichete pentru fiecare element și necesită definiții pe etichetă sau pe mostră. Normalizați pe rând pentru a inspecta tiparele de recall sau pe coloană pentru a inspecta compoziția predicțiilor, dar păstrați numărarea brută pentru ca grupurile rare să nu fie exagerate vizual.
Praguri, incertitudine și decizii operaționale
O matrice de confuzie rezumă deciziile stricte la un prag. Folosiți curbele precision‑recall sau ROC pentru a compara pragurile, apoi selectați un punct de operare în funcție de capacitate, prevalență și costul erorii. Calibrarea întreabă dacă probabilitățile prezise corespund frecvenței observate și este separată de rang. Când prevalența se modifică, precizia poate varia chiar dacă sensibilitatea și specificitatea rămân stabile. Raportați intervale de încredere sau variații prin bootstrap și evitați să trageți concluzii dintr-un număr mic de erori într-un subgrup restrâns.
Auditați matricile în funcție de timp, locație, dispozitiv, limbă și grupuri relevante afectate pentru a identifica erori concentrate. Comparați modelul cu procesul decizional existent, inclusiv revizuirea umană. Pentru cascade, înregistrați erorile la fiecare etapă: recuperare, clasificare, stabilire de prag și acțiune. Monitorizați etichetele de rezultat în timp real cu întârzierea și procesul de corecție. Un F1 aparent îmbunătățit poate totuși crește fals‑negativele dăunătoare sau depăși capacitatea de revizuire. Matricea de confuzie este un registru decizional; conectați fiecare celulă cu cine suferă eroarea și ce răspuns urmează.
Exemplu practic: selectarea unui prag de screening medical
Un model de screening bazat pe învățare automată emite un scor de risc pentru o afecțiune cu prevalență scăzută. Echipa creează matrici de confuzie la diferite praguri și raportează sensibilitatea, specificitatea, precizia, trimiterea falsă și cazurile ratate cu intervale de încredere. Deoarece valoarea predictivă pozitivă depinde de prevalență, se modelează populația vizată în loc să se citeze precizia unui singur set de date. Rezultatele sunt segmentate pe dispozitiv, locație, vârstă, sex și alte grupuri justificate clinic.
Clinicienii aleg un punct de operare care păstrează sensibilitatea necesară fără a copleși testarea de confirmare. Matricea este transformată în numărări așteptate la fiecare 10.000 de persoane screened pentru ca consecințele să fie înțelese. Scorurile în afara condițiilor validate nu produc nicio concluzie automată. Monitorizarea compară predicțiile cu diagnosticele confirmate cu întârziere, urmărește capacitatea și calibrarea și declanșează revizuirea când prevalența sau achiziția se modifică. Matricea de confuzie rămâne legată de modelul, pragul și populația exacte.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul operațional, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții limită, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare greșită și grupurile sau mediile cel mai probabil neacoperite. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag pentru ca un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare etapizată, păstrați un plan de rezervă sigur și verificați monitorizarea cu defecțiuni introduse deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil pentru răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se modifică. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Ce este o matrice de confuzie normalizată?
Normalizarea împarte numărarea la totalul clasei reale, totalul clasei prezise sau la toate observațiile. Facilitează compararea ratelor între clase, dar raportul ar trebui să păstreze și numărarea brută (support) pentru ca grupurile mici să nu fie confundate cu altele de dimensiune egală.
Poate o matrice de confuzie să evalueze regresia?
Nu direct. O matrice de confuzie necesită clase discrete. Gruparea unui țintă continuă în intervale elimină informații; regresia ar trebui în mod normal să folosească analiza reziduurilor și metrici concepute pentru valori continue, cum ar fi MAE sau RMSE.
Referințe principale












