
Fundamentele AI
Ce sunt mașinile cu vectori de sprijin?

 Adaugă Unite.AI la sursele tale preferate pe Google
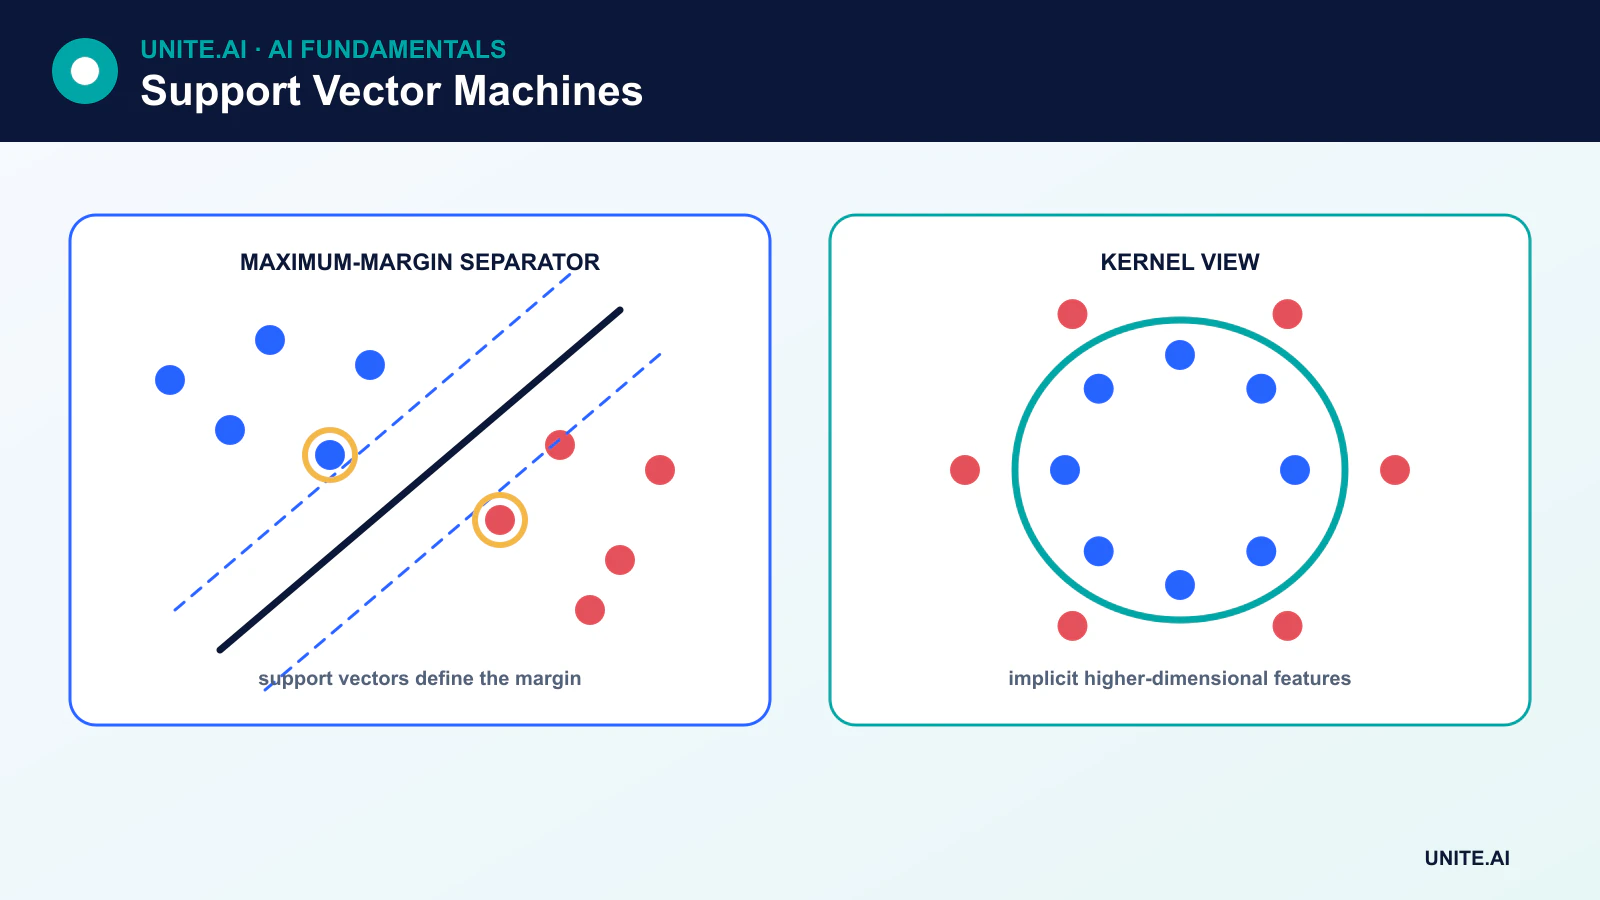
O mașină cu vectori de sprijin (SVM) este o metodă de învățare supravegheată care găsește o frontieră de decizie cu cea mai largă marjă posibilă între clase. Exemplele de antrenament care determină acea frontieră sunt vectorii de sprijin.
SVM-urile pot efectua clasificare liniară sau neliniară, regresie și detectare de noutate. Sunt deosebit de utile pentru seturi de date mici sau medii cu caracteristici informative, inclusiv date rare de înaltă dimensiune, dar costul lor de antrenament poate deveni impracticabil pe seturi de date foarte mari.
Aspecte principale
- Un SVM maximizează marja minimă dintre frontieră și cele mai apropiate puncte de antrenament.
- Vectorii de sprijin sunt puncte de date, nu hiperplane suplimentare.
- Parametrul C echilibrează lățimea marjei față de penalitățile pentru încălcări.
- Nucleele calculează similaritatea într-un spațiu de caracteristici implicit, fără a materializa explicit fiecare caracteristică transformată.
Ideea de marjă maximă
Pentru un clasificator binar liniar, frontiera de decizie este un hiperplan:
w · x + b = 0
Vectorul w determină orientarea, iar b deplasarea. Multe hiperplane pot separa clasele de antrenament. SVM-ul alege pe cel care maximizează distanța față de cele mai apropiate exemple de pe ambele părți. Aceste exemple apropiate sunt vectorii de sprijin și au cea mai mare influență asupra frontierei ajustate.
Obiectivul nu este de a maximiza distanța de la frontieră la fiecare punct în mod independent. Se maximizează marja minimă, respectând sau penalizând constrângerile de clasă.
Marje dure și moi
Un SVM cu marjă dură necesită o separare liniară perfectă și este sensibil la valori aberante. Seturile de date reale de obicei au nevoie de o marjă moale, care introduce variabile de relaxare pentru observațiile aflate în interiorul marjei sau pe partea greșită a frontierei.
Hiperparametrul C controlează penalizarea acestor încălcări:
- Un C mai mare penalizează încălcările mai puternic și adesea produce o marjă mai îngustă care urmăște exemplele de antrenament mai îndeaproape.
- Un C mai mic permite mai multe încălcări în schimbul unei margini mai largi și mai regularizate.
Numărul de vectori de sprijin este un rezultat al datelor și al soluției; creșterea lui C nu garantează un anumit număr de vectori de sprijin.
Trucul nucleului
Unele clase nu pot fi separate printr-un hiperplan drept în spațiul de caracteristici original. Un nucleu evaluează un produs interior corespunzător unui alt spațiu de caracteristici. Acest lucru permite SVM-ului să ajusteze o frontieră neliniară fără a calcula explicit fiecare coordonată transformată.
Nucleele comune includ:
- Liniar: eficient pentru caracteristici rare de înaltă dimensiune, cum ar fi textul.
- Polinomial: modelează interacțiuni până la un grad ales.
- Funcție radială de bază (RBF): creează frontiere locale flexibile bazate pe distanță.
- Sigmoid: seamănă cu o activare neurală, dar este mai puțin utilizat ca opțiune implicită.
Pentru un SVM RBF, gamma controlează cât de local fiecare exemplu de antrenament influențează frontiera. Un gamma mare poate crea regiuni foarte detaliate și poate supraînvăța; un gamma mic produce o influență mai netedă.
Clasificare multiclasa
Obiectivul clasic al SVM-ului este binar. Bibliotecile îl extind utilizând strategii precum unul‑contra‑rest, care antrenează un clasificator pentru fiecare clasă, sau unul‑contra‑unul, care antrenează clasificatori pentru perechi de clase și combină deciziile lor. SVM-urile multiclasa nu trasează pur și simplu o linie în minus față de numărul de clase.
Regresia cu vectori de sprijin și SVM de tip unică clasă
Regresia cu vectori de sprijin (SVR) ajustează o funcție ignorând erorile din interiorul unui tub cu lățime epsilon și penalizând deviațiile mai mari. Un SVM de tip unică clasă estimează o frontieră în jurul datelor tipice și poate susține detectarea de noutate. Un punct neobișnuit nu este automat fraudă sau defecțiune; este neobișnuit în contextul reprezentării ajustate.
Cerințe practice
SVM-urile depind de distanțe și produse interne, așadar caracteristicile numerice necesită în general scalare. C, nucleul, gamma și ponderile claselor ar trebui selectate prin validare. Estimările de probabilitate nu sunt inerente marjei și adesea necesită calibrare, ceea ce adaugă cost și ar trebui evaluate separat.
Antrenarea unui SVM cu nucleu poate scala între timp pătratic și cubic în funcție de numărul de mostre, în funcție de date și implementare. Variantele de SVM liniar sau modelele liniare stocastice sunt mai potrivite pentru seturi de date foarte mari. Pentru imagini brute, audio sau limbaj, reprezentările învățate prin deep learning pot fi mai eficiente, în timp ce un SVM poate totuși să clasifice o încorporare fixă.
Puncte forte și limitări ale SVM-ului
SVM-urile pot funcționa bine cu multe caracteristici, oferă un obiectiv regularizat clar și depind în principal de vectorii de sprijin în timpul predicției. Limitările includ sensibilitatea la scalare și hiperparametri, antrenament potențial costisitor, interpretabilitate redusă sub nucleele neliniare și cerințele de calibrare a probabilităților.
Margini, nuclee și obiectivul de optimizare
O mașină cu vectori de sprijin caută un hiperplan separator cu o marjă largă între clase. Doar vectorii de sprijin aflați pe sau în interiorul marginii determină frontiera. SVM-urile cu marjă moale introduc relaxare pentru suprapuneri și puncte etichetate greșit; parametrul C negociază o marjă mai largă față de încălcările de antrenament. Intrările ar trebui, de obicei, scalate deoarece distanța și produsele interne conduc soluția. Ponderile de clasă sau resampling-ul ajută când costurile erorilor și prevalența nu sunt egale, dar pragurile și probabilitățile necesită în continuare validare independentă.
Trucul nucleului evaluează similaritatea ca și cum intrările ar fi mapate într-un spațiu de caracteristici de dimensiune superioară. Nucleele liniare, polinomiale, radial-basis și cele specializate codifică presupuneri diferite. Pentru un nucleu RBF, gamma controlează cât de local fiecare punct influențează frontiera: un gamma mare poate crea regiuni complexe și poate supraînvăța, în timp ce un gamma mic poate subînvăța. Matricele nucleului cresc quadratic în funcție de numărul de mostre, făcând SVM-urile neliniare costisitoare pe seturi de date mari. Soluționarele liniare sau hărțile de caracteristici aproximative sunt adesea preferate la scară.
Utilizarea multiclasa, calibrarea și limitele operaționale
SVM-urile binare se extind la multiclasa prin unul‑contra‑rest, unul‑contra‑unul sau formulări structurate. Hiperparametrii trebuie reglați în cadrul validării încrucișate, cu împărțiri grupate sau temporale, unde este necesar. Evaluați precizia și recall‑ul specifice fiecărei clase, distribuțiile de marjă, calibrarea și performanța în condiții de schimbare. Scorurile brute de decizie nu sunt probabilități; scalarea Platt sau calibrarea izotonă utilizează date separate și poate să se deterioreze dacă prevalența se modifică. Comparați cu regresia logistică, arborii și metodele moderne bazate pe reprezentări, la un efort egal de preprocesare și reglare.
Servirea necesită exact scaler‑ul, ordinea caracteristicilor, parametrii nucleului, vectorii de sprijin și maparea claselor. Costul de predicție pentru un SVM cu nucleu crește odată cu numărul de vectori de sprijin, așa că se măsoară latența și memoria pe loturi realiste. Intrările aflate departe de suportul de antrenament pot totuși să primească etichete sigure; adăugați verificări de tip out‑of‑distribution sau o politică de abstinență, unde este potrivit. Inspectați erorile pentru proxy‑uri sensibile și artefacte ale setului de date. SVM-urile rămân puternice pentru probleme de dimensiune medie și înaltă dimensiune, dar o marjă geometrică maximă nu este dovada unei structuri cauzale sau a siguranței.
Exemplu practic: un SVM pentru rutarea documentelor rare
O echipă de operațiuni juridice clasifică depunerile scurte în categorii de rutare utilizând caracteristici TF–IDF și un SVM liniar. Împarte datele pe subiect și timp pentru a preveni scurgerea șabloanelor, scalează ponderile claselor pe baza costului erorilor revizuite și reglează C în cadrul unei validări imbricate. Modelul liniar este comparat cu regresia logistică și cu un transformator. Precizia, recall‑ul, calibrarea și volumul de muncă al revizorului pe fiecare clasă contează mai mult decât acuratețea globală.
Scorurile de decizie sunt calibrate pe date separate, iar documentele cu marjă scăzută sau limbă nesusținută sunt direcționate către preluarea manuală. Artefactul de servire include tokenizer‑ul, vocabularul, ponderarea, modelul, calibrarea și harta etichetelor. Monitorizarea urmărește termeni noi, prevalența categoriilor, marjele și rutele corectate. Documentele și vectorii de sprijin sunt protejate deoarece caracteristicile textului pot expune informații confidențiale. Un nucleu neliniar este respins când micile îmbunătățiri de calitate nu pot justifica costurile de latență, memorie și interpretabilitate.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de reglare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare incorectă și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare etapizată, păstrați un fallback sigur și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, starea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
SVM-urile efectuează doar clasificare?
Nu. Regresia cu vectori de sprijin prezice valori continue, în timp ce un SVM de tip unică clasă poate estima o frontieră de noutate. Fiecare variantă are un obiectiv diferit și un set diferit de hiperparametri.
Când este un SVM liniar o alegere puternică?
SVM-urile liniare sunt adesea eficiente pentru caracteristici rare de înaltă dimensiune, inclusiv reprezentările tradiționale de text, unde un nucleu flexibil ar adăuga cost fără beneficii clare.
Referințe principale












