
Fundamentele AI
Ce este gruparea K-Means?

 Adaugă Unite.AI la sursele tale preferate pe Google
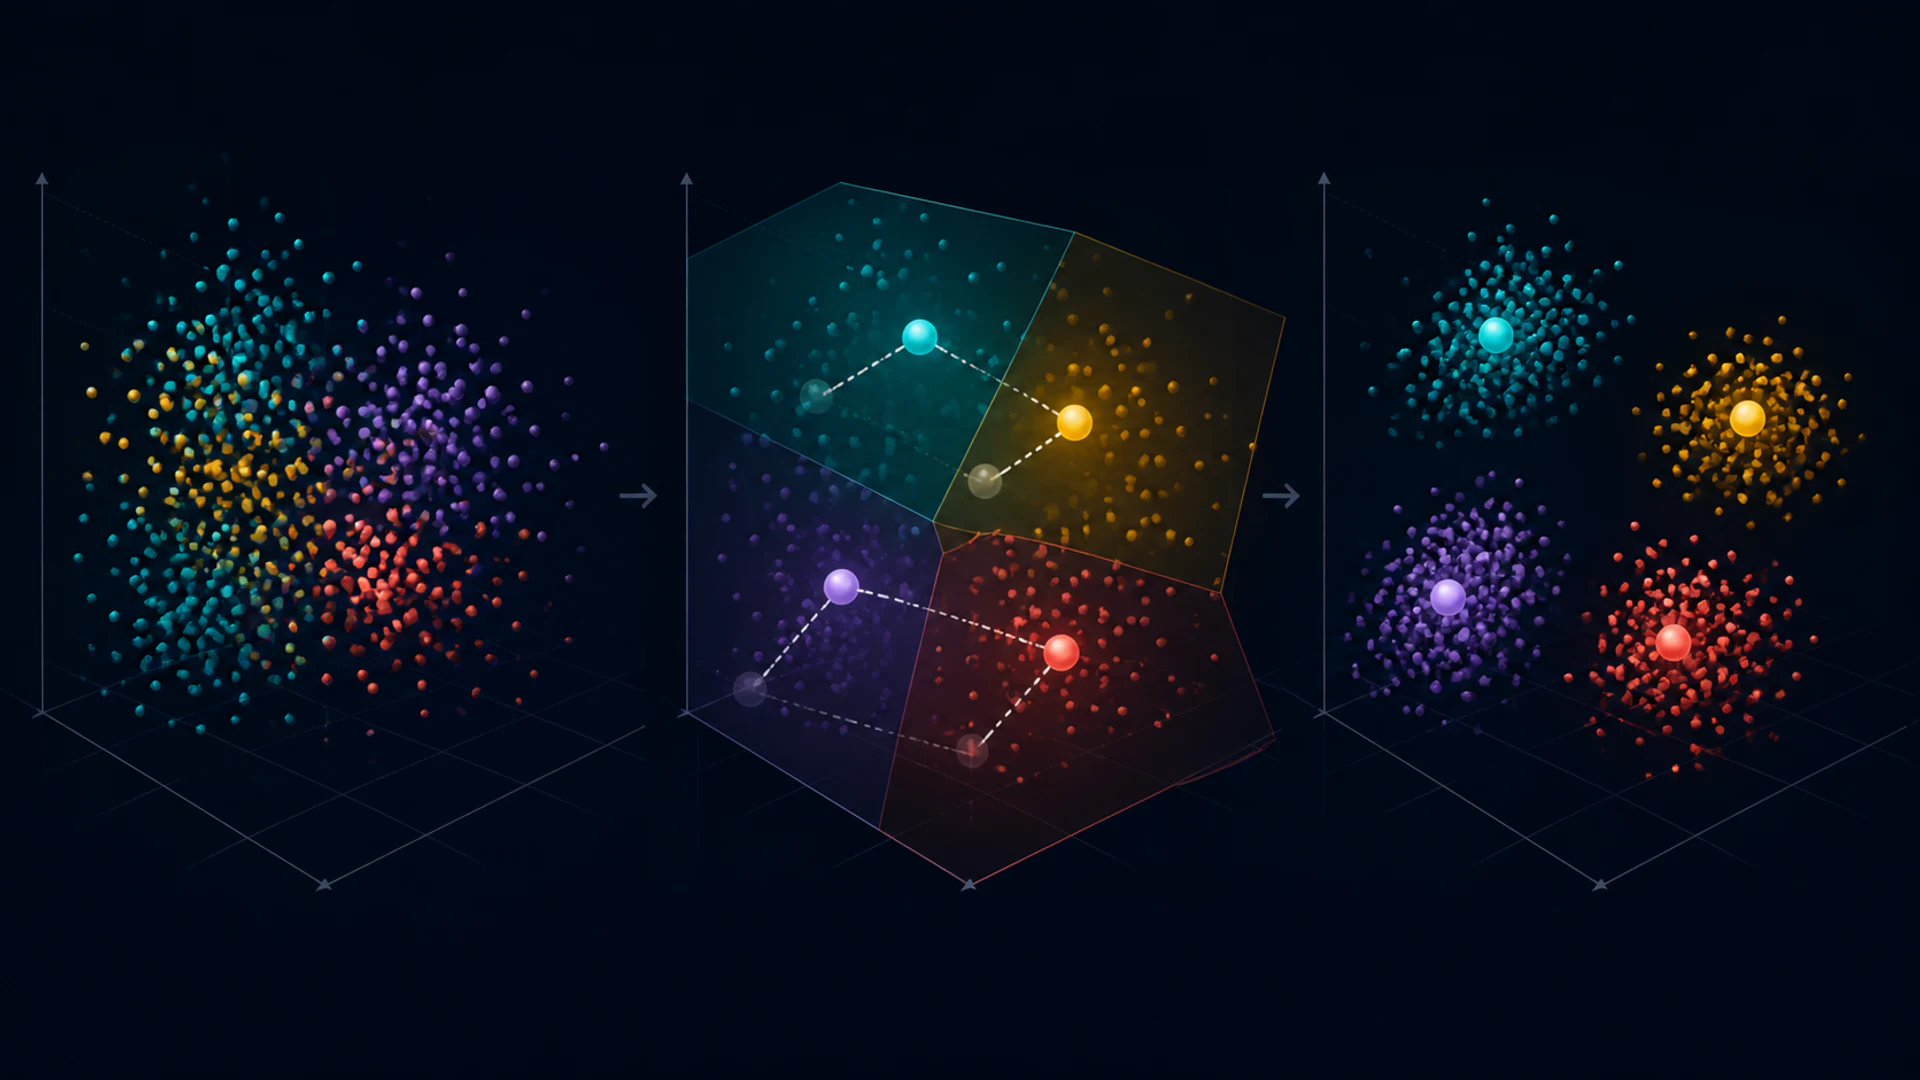
K-means este un algoritm nesupravegheat care împarte observațiile numerice în k clustere. Alternă între atribuirea fiecărui punct la cel mai apropiat centroid și recalcularea fiecărui centroid ca media punctelor atribuite.
Algoritmul este rapid și util, dar rezultatul său este modelat de scalare, distanță, inițializare și valoarea aleasă pentru k. Un cluster este o partiție matematică, nu automat o categorie din lumea reală.
Aspecte cheie
- K-means minimizează distanța euclidiană pătratică în interiorul clusterului față de centroidi.
- Inițializarea contează; k-means++ răspândește centroidii inițiali și, de obicei, îmbunătățește rezultatele.
- Standardizați caracteristicile când unitățile sau scările lor trebuie să contribuie în mod comparabil.
- K-means are dificultăți în fața valorilor aberante, a clusterelor nesferice, a densităților inegale și a datelor categorice.
Obiectivul și bucla de actualizare
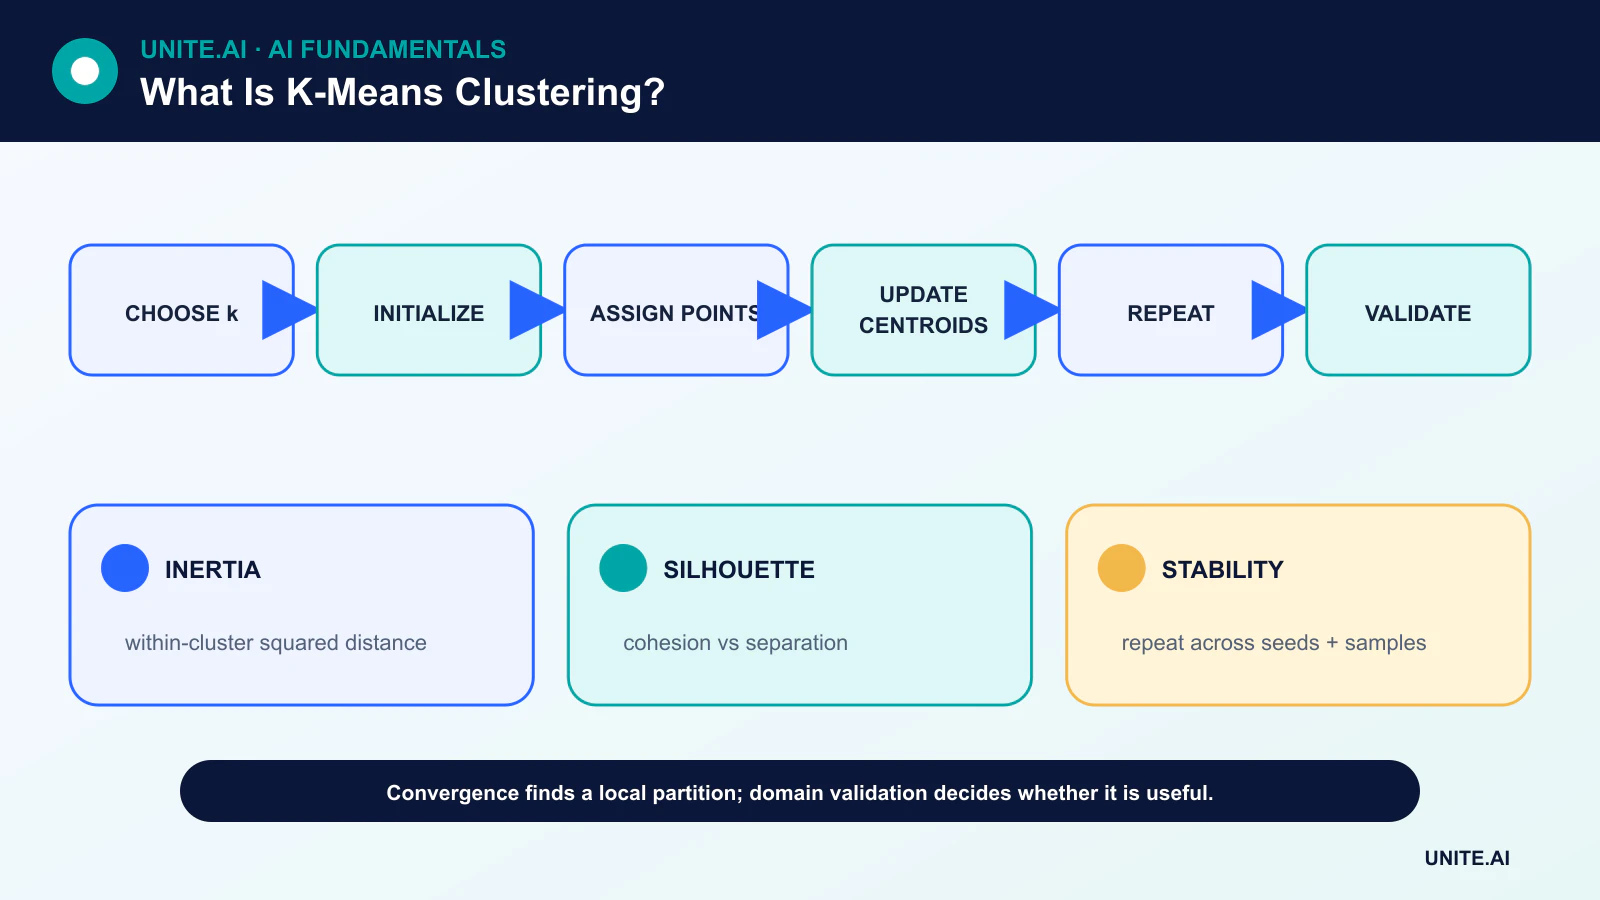
Având k centroidi, pasul de atribuire trimite fiecare observație la cel mai apropiat. Pasul de actualizare înlocuiește fiecare centroid cu media observațiilor atribuite acestuia. Suma pătratelor în interiorul clusterului nu poate crește în urma acestor pași, astfel procesul converge spre un optim local.
Convergența nu garantează optimul global. Centriizi inițiali diferiți pot duce la partiții diferite, motiv pentru care implementările rulează mai multe inițializări și păstrează soluția cu cea mai mică inerție.
Inițializarea și k-means++
Alegerea aleatorie a tuturor centroidilor inițiali dintr-o singură regiune densă poate produce o soluție slabă sau o convergență lentă. k-means++ alege semințele cu o probabilitate legată de distanța față de semințele existente, încurajând acoperirea setului de date.
Rularea multiplă rămâne utilă. Înregistrați sămânța aleatoare și numărul de inițializări pentru ca rezultatele să poată fi reproduse.
Scalarea și distanța
Distanța euclidiană pătratică face ca K-means să fie sensibil la unități. O caracteristică măsurată în mii poate domina o altă caracteristică măsurată între zero și unu. Standardizarea este obișnuită, dar cunoașterea domeniului ar trebui să decidă dacă varianta standardizată egală reflectă o importanță egală.
Valorile aberante pot trage media departe de punctele tipice. Scalarea robustă, tăierea sau metodele bazate pe medoiduri pot fi mai potrivite. Caracteristicile categorice codificate one-hot creează o geometrie a distanței care s-ar putea să nu corespundă similarității dintre categorii.
Alegerea lui k și validarea clusterelor
Inerția scade ori de câte ori k crește, astfel că nu poate selecta k singur. Heuristica cotului caută îmbunătățiri în scădere. Analiza siluetei compară coeziunea și separarea. Stabilitatea între eșantioane și sămânțe adaugă un alt control.
Cea mai puternică validare este utilitatea pentru domeniul vizat. Comparați clusterele cu rezultate cunoscute, revizuire de experți sau o sarcină ulterioară fără a pretinde că etichetele post-hoc au fost descoperite obiectiv.
Limite și alternative
K-means favorizează grupuri compacte, aproximativ sferice, de scară similară. Modelele de amestecuri gaussiene reprezintă componente probabilistice elipsoidale; metodele de tip DBSCAN identifică regiuni dense și zgomot; clusteringul ierarhic produce un arbore de fuziuni.
Reducerea dimensionalității poate îmbunătăți viteza sau poate elimina zgomotul din intrări, dar adaptarea ei pe întregul set de date poate schimba întrebarea de validare. Mini-batch K-means reduce calculul pentru seturi de date mari, cu costul unei actualizări aproximative.
Obiectiv, inițializare și convergență
K-means împarte observațiile numerice în k clustere prin minimizarea distanței euclidiene pătratice în interiorul clusterului față de centroidi. Algoritmul lui Lloyd alternează atribuirea fiecărui punct la cel mai apropiat centroid și recalcularea centroidilor până când atribuțiile sau funcția obiectiv se stabilizează. Converge spre un optim local, nu neapărat cel global. Inițializarea k-means++ răspândește centrele inițiale și, de obicei, îmbunătățește rezultatele, dar multiple sămânțe rămân importante. Standardizați caracteristicile când unitățile ar trebui să contribuie în mod comparabil, deoarece distanța pătratică amplifică variabilele cu scară mare și valorile aberante.
Metoda presupune clustere aproximativ compacte, sferice, de scară similară, sub geometria euclidiană. Are dificultăți cu manifold-uri alungite, densități inegale, date categorice, valori aberante puternice și structuri imbricate. Clusterele goale și punctele duplicate necesită o gestionare definită. Mini-batch k-means scalează la date mari cu un compromis de aproximitate. Pentru text sărac, k-means sferic orientat pe cosinus poate potrivi mai bine direcția, în timp ce amestecurile, metodele de densitate, clusteringul ierarhic sau k-medoids encodează alte presupuneri.
Alegerea lui k și validarea semnificației
Curbele cotului, scorurile de siluetă, criteriile de informație în modele conexe și stabilitatea pot informa alegerea lui k, dar niciuna nu descoperă un număr unic corect. Utilitatea în afaceri și interpretarea domeniului contează. Reantrenați pe diferite eșantioane și sămânțe, comparați mișcarea centroidilor și consistența atribuirilor și validați clusterele pe rezultate independente nefolosite la formarea lor. O proiecție bidimensională poate distorsiona separarea, așa că examinați distanțele și exemplele în spațiul de reprezentare original sau validat.
Clusterele sunt grupuri descriptive create de caracteristicile și metrica selectate; nu sunt tipuri naturale sau segmente cauzale. Profilurile bazate pe aceleași variabile folosite pentru clustering pot fi circulare. Utilizați atribute reținute și revizuire calitativă și verificați dacă clusterele reproduc în principal geografia, sursa de date sau trăsăturile sensibile. Clusterele mici pot fi anomalii sau artefacte. Denumirea unui cluster nu face ca fiecare membru să se potrivească etichetei.
Implementare și mentenanță
Stocați scalarea, ordinea caracteristicilor, centroidii, definiția distanței și etichetele clusterelor împreună. Pentru puncte noi, monitorizați distanța față de centroidul atribuit și fracțiunea care depășește semnificativ suportul de antrenament; oferiți o stare necunoscută în loc să forțați fiecare caz într-un cluster. Urmăriți dimensiunile clusterelor, centroidii și relevanța rezultatelor în timp. Re-antrenarea modifică identitățile clusterelor, așa că mapați sau versionați regulile ulterioare în loc să reutilizați tăcut numele vechi. K-means este o bază utilă de comprimare și segmentare când geometria sa se potrivește întrebării, nu un motor universal de descoperire.
Exemplu practic: segmentarea clienților cu k-means
O companie de abonamente standardizează caracteristicile de utilizare pe o fereastră fixă, elimină identificatorii de cont și testează k pe diferite sămânțe. Stabilitatea, silueta și rezultatele de afaceri reținute sunt revizuite, dar echipele de produs inspectează și conturile reprezentative și de frontieră. Descoperă că un cluster este pur și simplu clienți noi cu observații mai scurte, astfel că vechimea este gestionată explicit. k-means este comparat cu alternative ierarhice și bazate pe densitate în loc să se presupună că este adecvat. Exercițiul este tratat ca învățare nesupravegheată, nu ca descoperire de etichete.
Segmentele ghidează cercetarea și experimentele de mesagerie, nu eligibilitatea sau prețul. Conturile noi, aflate departe de fiecare centroid, primesc o atribuire necunoscută. Scalarea, caracteristicile, centroidii și denumirile sunt versionate, iar re-antrenarea mapează noile clustere pe cele vechi doar cu dovezi. Monitorizarea urmărește dimensiunea clusterului, distanța și relevanța rezultatelor. Atributele sensibile și proxy-urile sunt auditate, iar echipa evită descrierea clusterelor ca tipuri naturale de personalitate când acestea sunt partiții matematice ale comportamentului selectat.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbarea distribuției, întreruperi de dependență, utilizare incorectă și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o implementare în etape, păstrați o soluție de rezervă sigură și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care trebuie dezactivat sau înlocuit.
Întrebări frecvente
Este K-means supravegheat sau nesupravegheat?
Este nesupravegheat deoarece primește caracteristici și un număr ales de clustere, nu etichete țintă.
Clasifică K-means date noi?
După antrenare, un punct nou poate fi atribuit celui mai apropiat centroid. Aceasta este o atribuire de cluster, nu neapărat o predicție de clasă supravegheată.
Referințe principale












