
Fundamentele AI
Ce este un autoencoder?

 Adaugă Unite.AI la sursele tale preferate pe Google
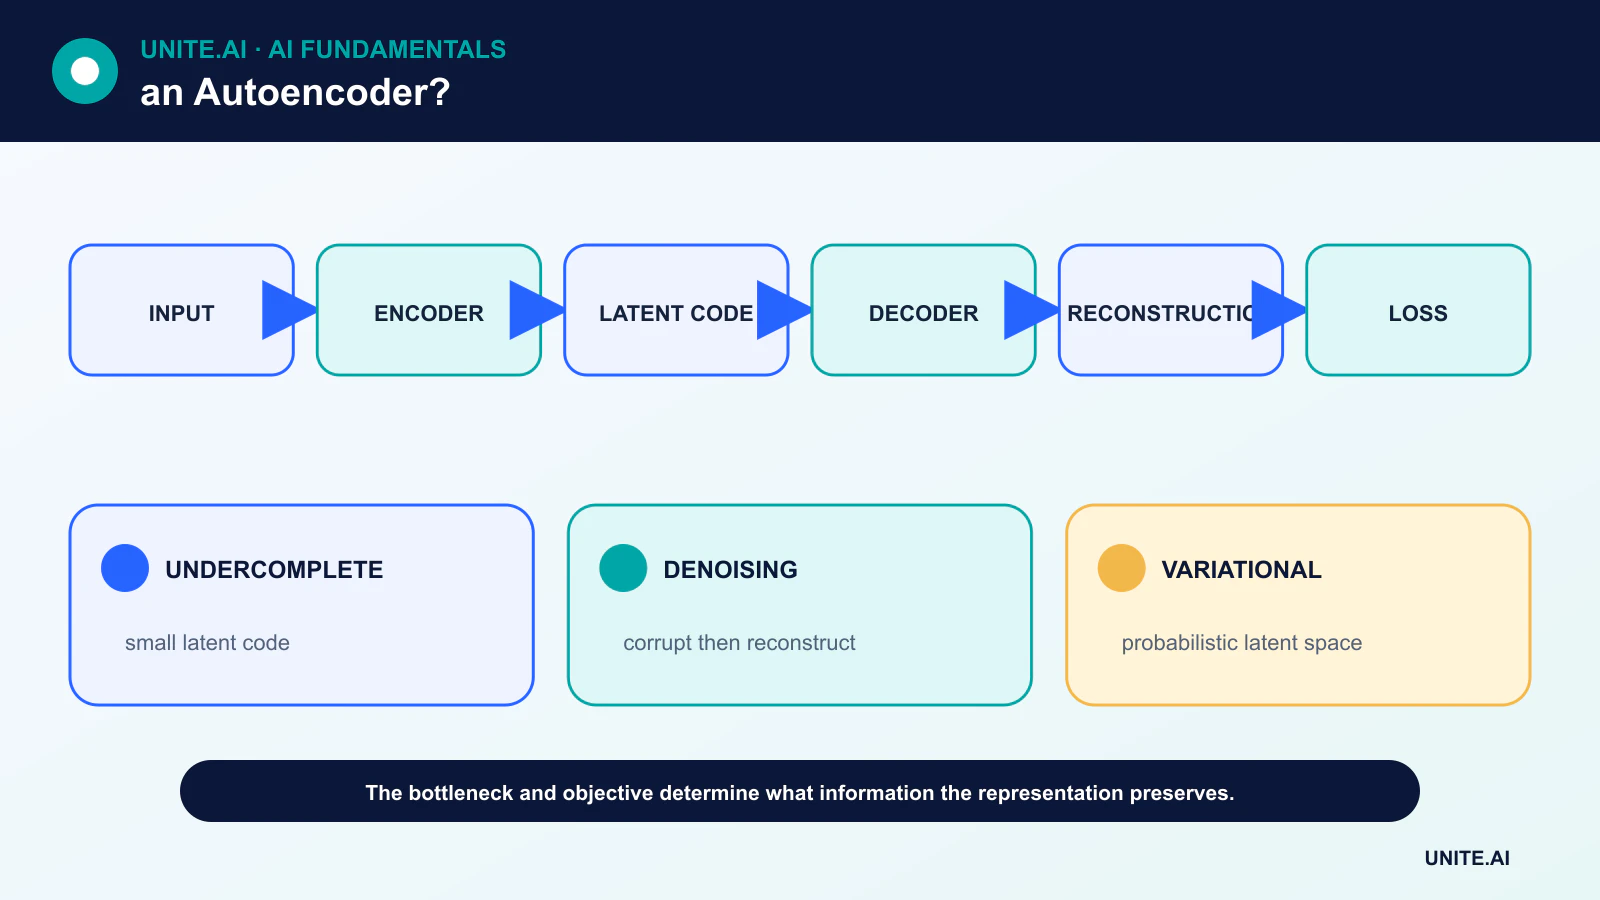
An autoencoder este o rețea neuronală antrenată să reconstruiască intrarea sa. Un encoder mapează intrarea către o reprezentare latentă; un decoder mapează acea reprezentare înapoi la o reconstrucție. Antrenarea minimizează o pierdere de reconstrucție, uneori cu constrângeri suplimentare.
Copierea perfectă a intrării nu este automat utilă. Arhitectura sau obiectivul trebuie să creeze un bottleneck, să adauge zgomot, să impună raritate sau, în alt mod, să prevină o mapare identitară trivială, astfel încât codul latent să capteze o structură utilă.
Idei principale
- Encoderul comprimă sau transformă o intrare; decoderul o reconstruiște dintr-un cod latent.
- Un bottleneck subcomplet, zgomotul sau regularizarea încurajează modelul să învețe structura în loc să copieze.
- Eroarea de reconstrucție poate susține detectarea anomaliilor, dar nu este garantat că anomaliile vor avea o eroare mare.
- Autoencoderele variationale învață un model latent probabilistic și diferă de autoencoderele deterministe.
Encoder, spațiu latent și decoder
Pentru intrarea x, encoderul produce codul latent z = f(x) și decoderul produce reconstrucția x̂ = g(z). Pierderea compară x și x̂, de exemplu cu eroarea pătratică medie pentru valori continue sau cu o verosimilitate adecvată datelor.
Dimensiunea latentă poate fi mai mică decât a intrării, creând un autoencoder subcomplet. O rețea profundă poate, de asemenea, să învețe reprezentări neliniare, extinzând ideea reducerii dimensionalității.
Variante comune ale autoencoderelor
Un autoencoder rar penalizează activarea răspândită. Un autoencoder de denoising primește o intrare coruptă și reconstruiște versiunea curată. Un autoencoder contractiv penalizează sensibilitatea codului la mici modificări ale intrării.
Un autoencoder variational (VAE) codifică parametrii unei distribuții de probabilitate, eșantionează o valoare latentă și echilibrează reconstrucția cu un termen de regularizare care modelează spațiul latent. Acest lucru susține eșantionarea, dar modifică obiectivul și interpretarea.
Antrenare și evitarea soluțiilor triviale
Autoencoderele folosesc backpropagation ca alte rețele neuronale. O rețea cu capacitate excesivă poate memora exemplele de antrenament sau poate învăța o funcție aproape identitară. Dimensiunea bottleneck-ului, corupția, penalizările și validarea pe date nevăzute o limitează.
Alegerea pierderii contează. O pierdere la nivel de pixel poate produce reconstrucții de imagini neclare, în timp ce pierderile perceptuale moștenesc presupuneri de la o altă rețea. Cel mai bun metric de reconstrucție nu este neapărat cea mai bună măsură a similarității semantice.
Utilizări și limitări
Autoencoderele pot învăța caracteristici, denoiza semnale, comprima date, inițializa modele și produce variabile latente pentru vizualizare. Pentru detectarea anomaliilor, un model antrenat pe date normale poate atribui o eroare de reconstrucție mai mare intrărilor neobișnuite.
Această abordare poate eșua când autoencoderul reconstruiște bine și anomaliile sau când variația inofensivă este mai dificil de reconstruit decât anomalia țintă. Pragurile necesită date de validare etichetate sau revizuite cu atenție, iar eroarea trebuie monitorizată pe subgrupuri și condiții de operare.
Autoencodere versus alte modele generative
Un autoencoder determinist nu este automat un model generativ probabilistic. VAE-urile definesc o distribuție latentă structurată; GAN-urile antrenează un generator împotriva unui discriminator; modelele de difuzie învață un proces de denoising.
Alegerea depinde de dacă obiectivul este reconstrucția, reprezentarea, verosimilitatea, fidelitatea mostrelor, controlabilitatea sau evaluarea anomaliilor. Un model specific sarcinii, mai mic, este adesea mai practic decât un generator de imagini mare.
Obiective encoder–decoder și reprezentări latente
Un autoencoder învață un encoder care mapează intrarea x către un cod latent z și un decoder care reconstruiște x din z. Dacă capacitatea este nelimitată, poate învăța o mapare identitară cu puțină structură utilă. Bottleneck-urile, regularizarea, corupția, raritatea sau constrângerile arhitecturale forțează o reprezentare care păstrează informațiile selectate. Pierderea de reconstrucție definește ce se consideră similar: eroarea pătratică medie favorizează fidelitatea medie a pixelilor, în timp ce pierderile perceptuale sau specifice modalității accentuează diferite caracteristici. O pierdere mică nu garantează sens semantic.
Autoencoderele subcomplete restricționează dimensiunea latentă. Autoencoderele de denoising reconstrucționează date curate din intrări corupte. Variantele rare penalizează activarea; variantele contractive penalizează sensibilitatea. Autoencoderele variationale învață o distribuție latentă probabilistică prin combinarea reconstrucției cu un termen de divergență, permițând eșantionarea, dar modificând obiectivul. Autoencoderele convoluționale, secvențiale, grafice și transformer codifică structura modalității. Alege dimensiunea latentă și regularizarea prin validare ulterioară, nu doar prin grafice bidimensionale atractive.
Detectarea anomaliilor, comprimare și evaluare
Pentru detectarea anomaliilor, antrenează pe date normale reprezentative și evaluează eroarea de reconstrucție sau verosimilitatea latentă, dar anomaliile pot uneori să se reconstruiască bine și cazurile rare normale să fie reconstruit prost. Selectează praguri pe cazuri de validare etichetate sau revizuite, raportează recall la nivel de eveniment și alarme false și testează modificările în starea de operare. Compară cu baselines statistice simple și cu metode de tip one‑class. Pentru comprimare, contabilizează codec‑ul complet — inclusiv dimensiunea modelului, cuantizarea, metadatele și calculul de decodare — și compară calitatea la un bitrate egal cu codecuri consacrate.
Calitatea reprezentării poate fi evaluată prin sonde liniare, stabilitatea clustering‑ului, recuperare, reconstrucție și sarcini ulterioare, fiecare răspunzând la o întrebare diferită. Evită scurgerile când înveți encoderul și selectezi pragurile. Inspectează ce caracteristici sunt ignorate de pierdere și dacă atributele sensibile rămân codificate. Un latent comprimat nu este automat anonim; inversarea și inferența de atribute pot recupera informații private. Reconstrucțiile generate pot părea plauzibile, în timp ce alterează detalii critice.
Implementare și monitorizare
Versionează encoderul și decoderul împreună, validează modificările numerice după export și păstrează scalarea intrării. Monitorizează distribuția reconstrucțiilor, driftul latent, alertele de prag și rezultatele confirmate. În monitorizarea industrială, condiționează modelul pe modul de operare astfel încât tranzițiile normale să nu fie tratate ca defecte. Pentru reconstrucții medicale sau științifice, nu prezenta niciodată un detaliu generat ca probă măsurată fără validare și proveniență. Autoencoderele sunt învățăcei flexibili de reprezentare, dar constrângerile și pierderea — nu numele arhitecturii — determină ce informație este păstrată, eliminată sau fabricată.
Exemplu practic: un autoencoder pentru anomalii ale pompelor
Un autoencoder subcomplet învață ferestre de vibrație din funcționarea verificată a pompelor sănătoase, pe diferite sarcini și temperaturi. Este comparat cu praguri statistice și metode one‑class, iar pragul său de reconstrucție este selectat pe tranziții normale revizuite și defecte cunoscute. Evaluarea folosește recall la nivel de eveniment, timpul de avertizare, alarme false pe oră de operare și rezultate pe pompă, nu ferestre aleatorii care plasează mostre adiacente în seturile de antrenament și test.
Modelul de producție se condiționează pe starea de operare și expune modele reziduale inginerilor. O eroare mare solicită inspecție; nu diagnostichează componenta sau oprește pompa automat. Deconectarea senzorului, tăierea semnalului și sarcini nevăzute produc stări invalide explicite. Monitorizarea urmărește distribuția reconstrucțiilor, confirmarea alertelor și sănătatea senzorilor. Când mentenanța sau schimbările hardware modifică baza de referință, modelul vechi rămâne disponibil în timp ce un candidat este antrenat pe date revizuite și testat pe incidente istorice.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definește utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabilește o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testează cazuri obișnuite, condiții limită, intrări malformate sau lipsă, schimbări de distribuție, întreruperi de dependență, utilizare greșită și grupurile sau mediile cel mai probabil subreprezentate. Măsoară calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrează fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuie autoritatea pentru eliberare, excepții, modificări, rollback și retragere. Folosește o desfășurare etapizată, păstrează un fallback sigur și verifică monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definește pragurile de alertă și un responsabil de răspuns, apoi revizuiește dovezile din viața reală după implementare în loc să presupui că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Sunt autoencoderele compresie fără pierderi?
În general, nu. De obicei învață reprezentări cu pierderi specifice sarcinii și distribuției și necesită decoderul antrenat pentru a reconstrui datele.
Este fiecare bottleneck interpretabil?
Nu. Un cod compact poate fi util fără ca fiecare dimensiune să corespundă unui concept ușor de înțeles de om.
Referințe principale












