
Fundamentele AI
Ce este viziunea computerizată?

 Adaugă Unite.AI la sursele tale preferate pe Google
Viziune computerizată este domeniul construirii de sisteme care extrag informații utile din imagini și video. Un model de viziune poate clasifica o imagine întreagă, localiza obiecte, eticheta fiecare pixel, citi text, estima poziția, urmări mișcarea sau conecta conținutul vizual cu limbajul.
Sistemele de viziune moderne nu reproduc simplu procesul timpuric de detectare a marginilor din percepția umană. Ele învață reprezentări specifice sarcinii din date, adesea folosind rețele neuronale convoluționale, transformatoare de viziune sau modele de bază multimodale.
Idei principale
- Clasificarea, detectarea, segmentarea, OCR, urmărirea și generarea sunt sarcini de viziune distincte.
- CNN-urile încorporează localitatea și partajarea greutăților; transformatoarele de viziune utilizează atenția pe patch-uri de imagine.
- Etichetele pot proveni de la oameni, supervizare slabă, date sintetice sau obiective auto-supervizate.
- Precizia singură este insuficientă: robustețea, latența, confidențialitatea, părtinirea și costurile de eșec contează.
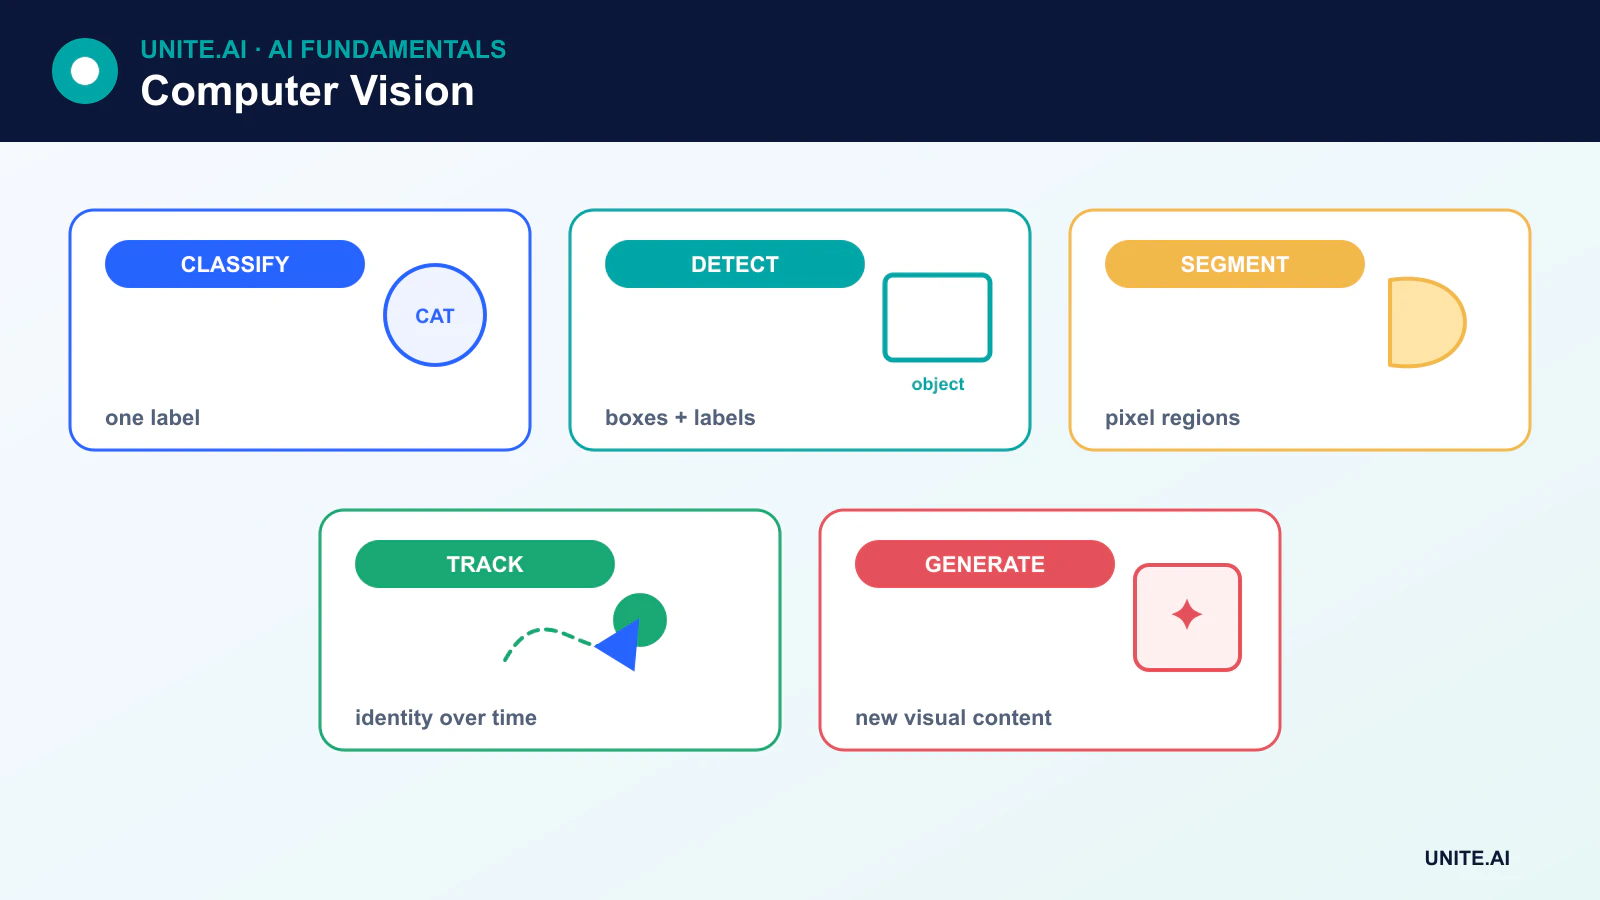
Sarcinile principale ale viziunii computerizate
- Clasificarea imaginilor atribuie una sau mai multe etichete unei imagini. Vezi cum funcționează clasificarea imaginilor.
- Detectarea obiectelor prezice categoriile și cutiile delimitatoare pentru mai multe obiecte.
- Segmentarea semantică etichetează fiecare pixel după clasă, în timp ce segmentarea de instanță separă obiectele individuale.
- Recunoașterea optică a caracterelor (OCR) detectează și transcrie textul.
- Estimarea poziției prezice reperele corpului sau ale obiectului.
- Urmărirea asociază detecțiile pe parcursul cadrelor video.
- Generarea și editarea imaginilor produce sau transformă conținut vizual, adesea folosind modele de difuzie.
Cum devin imaginile intrări pentru modele
O imagine digitală este deja date numerice: un tensor ce conține valori de pixeli pe dimensiuni spațiale și canale. Preprocesarea poate redimensiona, normaliza, decupa sau augmenta imaginea. Video adaugă o dimensiune temporală, în timp ce imagistica medicală și științifică pot adăuga adâncime, lungime de undă sau alte modalități.
Viziunea clasică a folosit caracteristici de margine, colț și textură proiectate manual. Modelele profunde moderne învață de obicei caracteristici împreună cu sarcina, deși metodele clasice rămân utile când datele sunt limitate, regulile bine înțelese sau calculul trebuie să fie minim.
CNN-uri și caracteristici locale învățate
Un CNN aplică nuclee învățate peste vecinătăți locale. Straturile timpurii pot răspunde la modele locale, în timp ce blocurile ulterioare le combină în reprezentări relevante pentru sarcină. Operațiile de pooling sau cu pas reduc rezoluția spațială, iar conexiunile reziduale fac rețelele adânci mai ușor de optimizat.
Un clasificator CNN modern folosește adesea pooling global în locul unui lanț mare de straturi complet conectate. Detectoarele și rețelele de segmentare adaugă capete specializate sau căi de decodor care păstrează informația spațială.
Transformatoare de viziune și modele de bază
Un transformator de viziune împarte o imagine în patch-uri, le încorporează și folosește atenția pentru a modela relațiile dintre ele. Transformatoarele pot scala eficient cu seturi mari de date și pre-antrenare, în timp ce CNN-urile oferă adesea presupuneri încorporate și eficiență la scară mică.
Modelele multimodale aliniază imagini cu text astfel încât utilizatorii să poată căuta, genera subtitrări, răspunde la întrebări sau ghida segmentarea folosind limbajul. Aceste modele extind capacitatea, dar moștenesc și slăbiciunile datelor web la scară largă, inclusiv stereotipuri, materiale protejate prin drepturi de autor și acoperire inegală a populațiilor și mediilor.
Etichete, auto-supervizare și date sintetice
Cutiile delimitatoare, măștile, reperele și subtitrările pot fi costisitoare de creat. Învățarea auto-supervizată derivă obiective din însuși imaginile, în timp ce supervizarea slabă folosește etichete zgomotoase sau indirecte. Datele sintetice pot adăuga scenarii rare, dar diferențele de simulare pot împiedica transferul performanței sintetice în lumea reală.
Calitatea adnotărilor trebuie măsurată. Etichetele ambigue, limitele inconsistente și obiectele lipsă impun un plafon asupra performanței și pot ascunde eșecuri în subgrupuri.
Cum sunt evaluate sistemele de viziune
Clasificarea folosește metrici precum acuratețea, precizia, recall-ul, F1 și calibrarea. Detectarea utilizează în mod obișnuit intersecția peste uniune și media preciziei medii. Segmentarea folosește intersecția peste uniune sau măsuri de tip Dice. Urmărirea adaugă metrici de identitate și traiectorie.
Metrica trebuie să corespundă implementării. Un model poate obține scoruri bune pe un benchmark curat și totuși să eșueze în ploaie, lumină scăzută, unghiuri neobișnuite ale camerei, noi dispozitive sau populații necunoscute. Evaluarea ar trebui să includă schimbări de distribuție, condiții adversare și latență operațională.
Confidențialitate, părtinire și implementare
Fețele, plăcile de înmatriculare, locuințele, scanările medicale și video-ul din locuri de muncă pot dezvălui informații sensibile. Colectarea și păstrarea trebuie să se bazeze pe un fundament legal și etic definit, cu controale de acces și minimizare a datelor. Analiza facială și identificarea biometrică necesită o atenție deosebită, deoarece erorile și supravegherea pot impune daune inegale.
Implementarea la margine poate reduce latența și transferul de date. Edge AI, cuantizarea, tăierea și acceleratoarele specializate pot face sistemele de viziune practice pe camere, vehicule, roboți și dispozitive mobile, dar comprimarea trebuie reevaluată pentru acuratețe și părtinire.
De la pixeli la sarcini vizuale
Viziunea computerizată transformă imagini sau video în ieșiri de sarcină precum clasificare, detectare, segmentare, urmărire, poziție, adâncime, flux optic sau recunoaștere de text. Definiția sarcinii determină adnotarea: o etichetă de imagine nu poate antrena localizare precisă, iar o cutie delimitatoare nu poate descrie complet o mască de segmentare. Geometria camerei, lentilele, expunerea, iluminarea, mișcarea, compresia și punctul de vedere modelează distribuția datelor. Definiți mediul de operare și consecințele erorilor înainte de a selecta un model, deoarece o colecție de imagini de benchmark poate să nu reprezinte senzorul sau scena implementată.
Un pipeline decodează și orientează media, redimensionează sau îl împarte în dale, normalizează valorile, aplică augmentări care păstrează etichetele, rulează un model și postprocesează logiții, cutiile, măștile sau traseele. Detectoarele de obiecte folosesc praguri de încredere și suprimare; trackerele asociază detecțiile în timp; segmentarea poate necesita curățare morfologică. Păstrați transformările de coordonate pentru ca ieșirile să se alinieze cu imaginea originală. Împărțiți datele pe persoană, cameră, locație sau sesiune de captare pentru a evita cadre aproape identice în seturile de antrenament și test.
Evaluare, părtinire, confidențialitate și operațiuni
Metricile trebuie să corespundă sarcinii și utilizării. Clasificarea necesită precizie și recall specifice clasei; detectarea folosește intersecție-peste-uniune și precizie medie pe praguri; segmentarea folosește IoU sau Dice; urmărirea adaugă schimbări de identitate; latența și durata evenimentelor ratate contează pentru video. Raportați rezultatele în funcție de iluminare, distanță, dispozitiv, obstrucție, tonul pielii, vârstă și alte condiții relevante. Inspectați calibrarea și erorile cu încredere ridicată. Datele sintetice sau augmentate pot umple goluri, dar necesită comparație cu date reale de implementare și nu trebuie să scurgă scene de test.
Viziunea poate colecta trecători, locații, date biometrice și comportamente sensibile. Minimizați captarea și păstrarea, securizați fluxurile, restricționați utilizarea secundară și oferiți notificare sau consimțământ acolo unde este necesar. Testați plasturi adversari, redare, obstrucție, defecte ale camerei și schimbări de domeniu. Monitorizați sănătatea senzorului, statisticile de intrare, ratele de ieșire și rezultatele confirmate; mențineți revizuirea umană pentru decizii cu consecințe. Estomparea sau decuparea poate reduce expunerea, dar poate și elimina dovezi. Un scor ridicat în laborator nu justifică afirmații despre identitate, emoție sau intenție dincolo de sarcina validată.
Exemplu practicat: detectarea pietonilor la o trecere de depozit
Camerele monitorizează o trecere restricționată pentru vehicule, iar modelul detectează persoane fără a le identifica. Datele acoperă zi și noapte, vreme, îmbrăcăminte, obstrucție, utilizatori de scaune cu rotile, poziții ale camerei și scene goale, împărțite pe sesiuni de înregistrare. Detectorul este evaluat pentru recall de eveniment, alarme false, localizare, timp de avertizare și performanță la distanță. Ingineria de siguranță definește latența maximă tolerată și controalele fizice independente.
Alertele de viziune pot încetini un vehicul, dar opririle de urgență și barierele nu depind de modelul învățat. Obstrucția camerei, cadre înghețate, pierderea rețelei și timeout-ul modelului produc defecte explicite. Păstrarea video brut este minimizată și accesul este înregistrat. Monitorizarea urmărește sănătatea senzorului, ratele de alertă, incidentele revizuite și aproape accidentele pe condiție. Orice relocare a camerei sau schimbare de layout declanșează revalidarea, deoarece similaritatea aparentă a imaginii nu garantează aceeași geometrie sau risc.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație reușită. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustări. Testați cazuri obișnuite, condiții limită, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizare incorectă și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul de resurse, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru lansare, excepții, modificări, rollback și retragere. Folosiți o lansare etapizată, păstrați un fallback sigur și verificați monitorizarea cu defecte injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar când ar trebui să fie dezactivat sau înlocuit.
Întrebări frecvente
Este viziunea computerizată aceeași cu recunoașterea imaginilor?
Nu. Recunoașterea imaginilor se referă de obicei la clasificare sau identificare. Viziunea computerizată include, de asemenea, localizare, segmentare, măsurare, urmărire, reconstrucție, generare și raționament asupra informațiilor vizuale.
Un sistem de viziune vede ca un om?
Nu. Un model procesează intrări numerice conform arhitecturii și obiectivului său de antrenament. Poate depăși oamenii pe un benchmark restrâns, dar eșuează la mici modificări pe care o persoană le gestionează cu ușurință.
Referințe principale












