
Fundamentele AI
Ce este Backpropagation?

 Adaugă Unite.AI la sursele tale preferate pe Google
Backpropagation este algoritmul utilizat pentru a calcula cum se modifică pierderea unei rețele neuronale în raport cu parametrii săi antrenabili. Aplică regula lanțului din calcul diferențial înapoi prin operațiile înregistrate în timpul unei treceri înainte.
Backpropagation calculează gradientele; nu decide, de la sine, actualizarea. Un optimizer, cum ar fi descendența stochastică a gradientului sau AdamW, folosește acele gradienti pentru a modifica greutățile, biasurile și alte parametri antrenabili.
Idei principale
- Trecerea înainte construiește valori intermediare și produce o predicție.
- Funcția de pierdere convertește predicția și ținta într-un obiectiv scalar de antrenament.
- Backpropagation folosește derivate locale și regula lanțului pentru a calcula eficient gradientele parametrilor.
- Framework-urile moderne implementează diferențiere automată în mod invers pe un graf computațional.
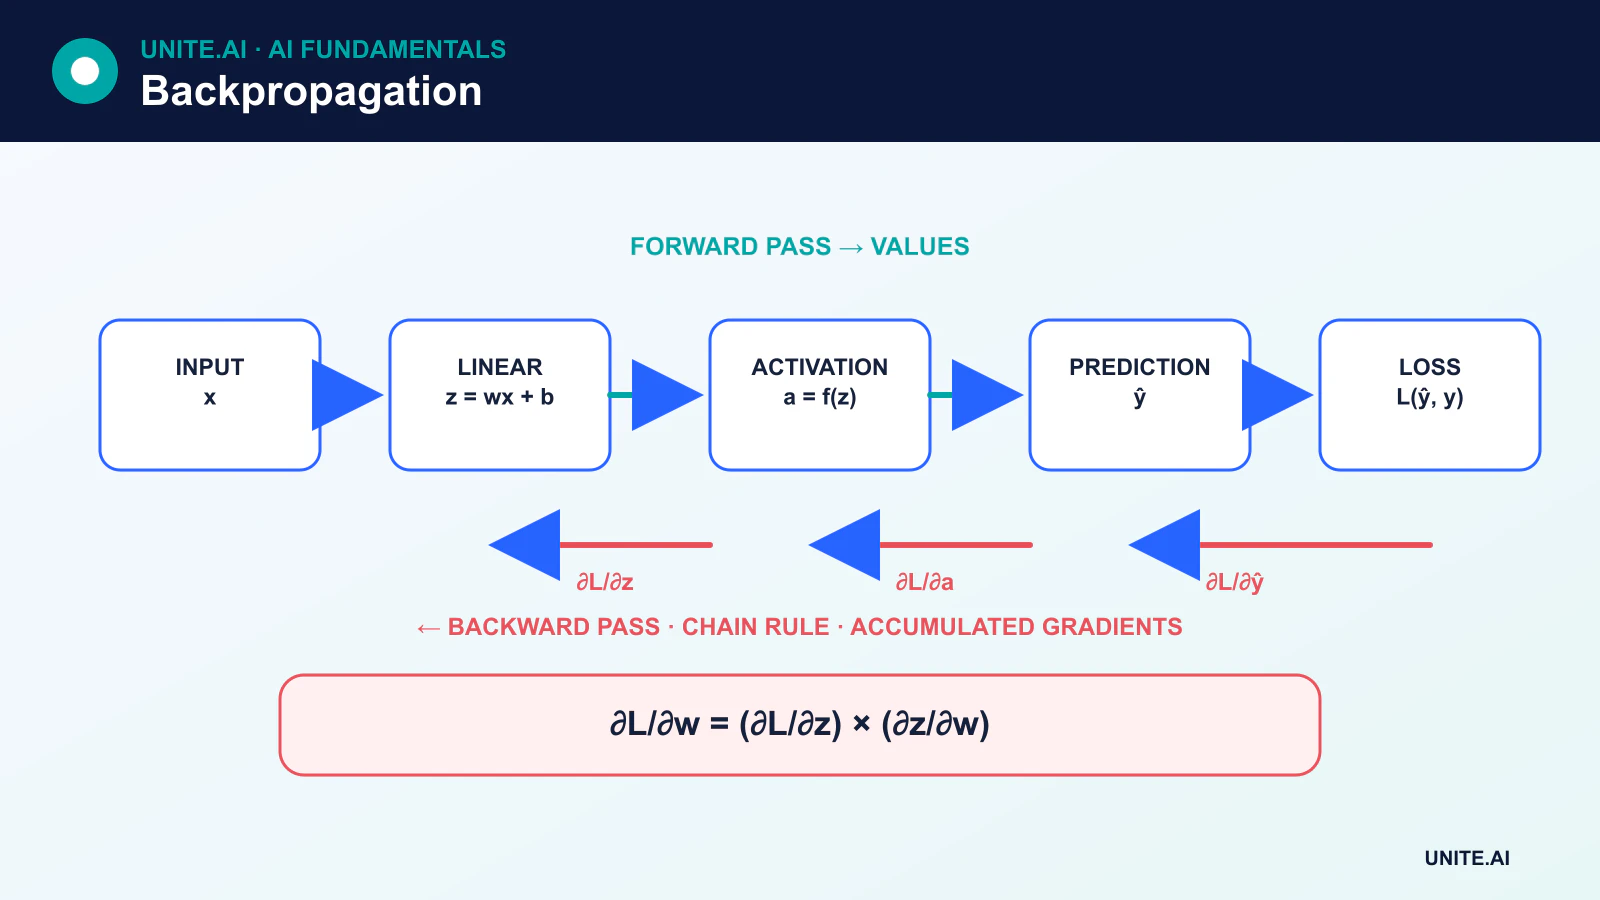
Trecerea înainte
Considerați o unitate simplă:
z = wx + bŷ = activation(z)
Intrarea este x, în timp ce w și b sunt parametri de greutate și bias antrenabili. Biasurile se modifică în mod normal în timpul antrenamentului la fel ca și greutățile. O rețea combină multe astfel de operații, plus normalizare, atenție, convoluții, conexiuni reziduale sau alte blocuri diferențiale.
Trecerea înainte evaluează acele operații și produce o predicție. O funcție de pierdere, cum ar fi cross‑entropy sau eroarea pătratică medie, măsoară obiectivul. Pierderea optimă depinde de sarcină și de interpretarea ieșirii.
Regula lanțului
Dacă pierderea L depinde de o valoare intermediară z, iar z depinde de parametrul w, regula lanțului dă:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
O rețea profundă conține multe căi. Backpropagation parcurge graful computațional în sens invers, acumulând contribuții atunci când o valoare afectează pierderea prin mai multe căi. Rezultatul este un gradient pentru fiecare parametru antrenabil care a participat la calculul în trecerea înainte.
Un mic exemplu numeric
Presupunem ŷ = wx + b, cu x = 2, w = 3 și b = 1. Predicția este 7. Dacă ținta este 5 și pierderea este L = ½(ŷ - y)², atunci:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Optimizerul poate apoi să ajusteze w și b în direcția gradientului negativ. Această formulă este specifică unității liniare alese și pierderii de eroare pătratică; o regulă universală de backpropagation este regula lanțului aplicată pe graful real, nu o ecuație „de eroare” fixă.
Backpropagation versus descendența gradientului
Descendența gradientului este o metodă de optimizare. Backpropagation furnizează gradientele necesare. Un pas de antrenament urmează de obicei:
- Șterge sau resetează gradientele stocate.
- Execută trecerea înainte.
- Calculează pierderea.
- Execută trecerea înapoi.
- Aplică actualizarea optimizerului.
Separarea acestor concepte facilitează înțelegerea momentumului, AdamW, acumulării de gradient și antrenamentului cu precizie mixtă.
Diferențiere automată
Framework-urile precum PyTorch înregistrează operațiile și construiesc un graf în timpul trecerii înainte. Diferențierea automată în mod invers calculează apoi produse vector‑Jacobian eficient de la ieșiri înapoi la parametri. Aceasta este mai generală decât programarea manuală a derivatelor pentru o rețea fixă și este fundamentală pentru framework-urile moderne de învățare profundă.
Unele operații nu sunt diferențiale sau au derivate instabile. Framework-urile definesc subgradienti sau convenții documentate în anumite cazuri, dar practicienii trebuie să înțeleagă totuși tensorii detașați, operațiile în loc și precizia numerică.
Gradienti care dispar și explodează
Înmulțirea repetată prin multe straturi sau pași de timp poate face gradientii extrem de mici sau foarte mari. Gradientii care dispar încetinesc învățarea în straturile timpurii; gradientii care explodează destabilizează actualizările. Activările din familia ReLU, inițializarea atentă, conexiunile reziduale, normalizarea, recurența cu porți și tăierea gradientului ajută, dar niciuna nu este o soluție universală.
Verificarea gradientilor
Verificarea gradientului prin diferențe finite compară un gradient analitic sau automat cu o aproximație numerică. Este lentă, dar utilă pentru depanarea operațiilor personalizate. Monitorizarea normelor gradientului și detectarea valorilor NaN sau infinite poate dezvălui instabilitate în timpul antrenamentului.
Regula lanțului printr-un graf computațional
Backpropagation calculează eficient gradientele unei pierderi scalare în raport cu fiecare parametru diferențial. O trecere înainte înregistrează valori intermediare într-un graf computațional. Începând de la pierdere, diferențierea automată în mod invers aplică regula lanțului, înmulțind derivatele locale și acumulând contribuții acolo unde căile se întâlnesc. Pentru un strat y=f(x,w), sensibilitatea în amonte față de y se combină cu derivatele parțiale pentru a produce sensibilități pentru x și w. Backpropagation calculează gradientele; optimizerul decide cum se modifică parametrii.
Un strat afin simplu produce y=Wx+b. Gradientul pentru W este produsul exterior al gradientului în amonte și al intrării, gradientul pentru b însumează valorile în amonte, iar gradientul intrării se înmulțește cu matricea de greutăți transpusă. Activările adaugă derivate element cu element. Convoluția, normalizarea, atenția și reutilizarea recurentă urmează același principiu de graf, dar necesită forme corecte ale tensorilor, difuzare, mască și partajare de parametri. Framework-urile eliberează activările salvate după trecerea înapoi, cu excepția celor reținute, astfel memoria crește adesea odată cu dimensiunea batch‑ului, adâncimea și lungimea secvenței.
Eșecuri ale gradientului, verificare și practică inginerească
Produsele multor derivate pot dispărea sau exploda. Activările de tip ReLU, inițializarea atentă, normalizarea, conexiunile reziduale, porționarea și tăierea gradientului abordează diferite mecanisme. Activările saturate și operațiile nedefinibile pot bloca semnalele utile; backpropagation‑ul trunchiat limitează istoricul secvenței; precizia mixtă poate subfluxa fără scalarea pierderii. Gradientii care explodează sunt un simptom, așa că tăierea ar trebui să însoțească investigarea ratei de învățare, datelor, arhitecturii și erorilor numerice, în loc să le ascundă.
Verificați operațiile personalizate cu verificări ale gradientului prin diferențe finite pe intrări de dublă precizie mici, evitând punctele nedefinibile. Inspectați normele gradientului, NaN‑urile, parametrii inactivi și dacă gradientii ajung la modulele așteptate. Curățați deliberat gradientele acumulate și diferențiați comportamentul de antrenament de cel de evaluare pentru dropout și normalizare. Salvarea intermediară (checkpointing) recalculează activările pentru a economisi memorie; antrenamentul distribuit trebuie să agregheze gradientele în mod consistent. O scădere a pierderii de antrenament arată că există o cale de optimizare, nu că gradientii sunt corecți conceptual, datele nu au scurgeri sau modelul se generalizează.
Exemplu practicat: verificarea unui strat neural personalizat
Un inginer implementează un strat spectral diferențial pentru o rețea audio. Un test de dimensiuni mici în dublă precizie compară gradientele automate cu diferențele finite centrale pe intrări și parametri, excluzând punctele în care operația este intenționat nedefinibilă. Forma, difuzarea, completarea și conversia complex‑la‑real primesc cazuri separate. Testul verifică gradientele acumulate când un parametru este reutilizat și confirmă că cadrele audio mascate nu produc gradient.
În timpul antrenamentului, tablourile de bord urmăresc normele gradientului și ale activării, NaN‑urile, parametrii inactivi și scalarea pierderii. Un batch deliberat corupt confirmă că validarea prinde ieșiri nefinite înainte de actualizarea optimizerului. Precizia mixtă și implementările exportate sunt comparate cu referința. Testele de reluare a checkpoint‑ului includ starea optimizerului și ordinea aleatoare. Stratului nu i se acordă acceptare doar pentru că pierderea totală scade; gradientii unitari, stabilitatea numerică și generalizarea în aval trebuie să furnizeze toate dovezi coerente.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi de dependență, utilizare incorectă și grupurile sau mediile cel mai probabil neacoperite. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atractiv.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Folosiți o lansare etapizată, păstrați un fallback sigur și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrării, comportamentul ieșirii, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și un responsabil de răspuns, apoi revizuiți dovezile din viața reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Backpropagation actualizează greutățile?
Backpropagation calculează gradientele. Optimizerul aplică o actualizare folosind acele gradiente, rata de învățare și, eventual, starea precum momentum sau momente adaptive.
Este backpropagation realist din punct de vedere biologic?
Backpropagation standard este un algoritm de inginerie și nu este acceptat ca un model detaliat al învățării în creierele biologice. Analogia neurală istorică nu trebuie tratată ca o echivalență biologică.
Referințe principale












