
Fundamentele AI
Ce este supraînvățarea?

 Adaugă Unite.AI la sursele tale preferate pe Google
Supraînvățare apare atunci când un model captează tipare sau zgomot care funcționează neobișnuit de bine pe datele sale de antrenament, dar nu reușesc să se generalizeze la exemple noi. Un model supraînvățat poate avea o eroare de antrenament foarte mică, în timp ce performanța pe date de validare sau în lumea reală este semnificativ mai slabă.
Problema opusă este subînvățarea: modelul sau procesul de antrenament nu poate captura suficient semnal chiar și pe setul de antrenament. O modelare bună echilibrează potrivirea cu generalizarea, în loc să caute performanță perfectă pe datele de antrenament.
Aspecte esențiale
- Performanța pe datele de antrenament singură nu poate diagnostica generalizarea.
- Întreruperea timpurie ar trebui să se bazeze pe comportamentul de validare, nu pe decizii repetate pe setul final de testare.
- Mai multe date pot ajuta, dar mai multe caracteristici sau capacitate pot agrava supraînvățarea.
- Regularizarea, augmentarea, validarea încrucișată, prevenirea scurgerilor și evaluarea adecvată abordează cauze diferite.
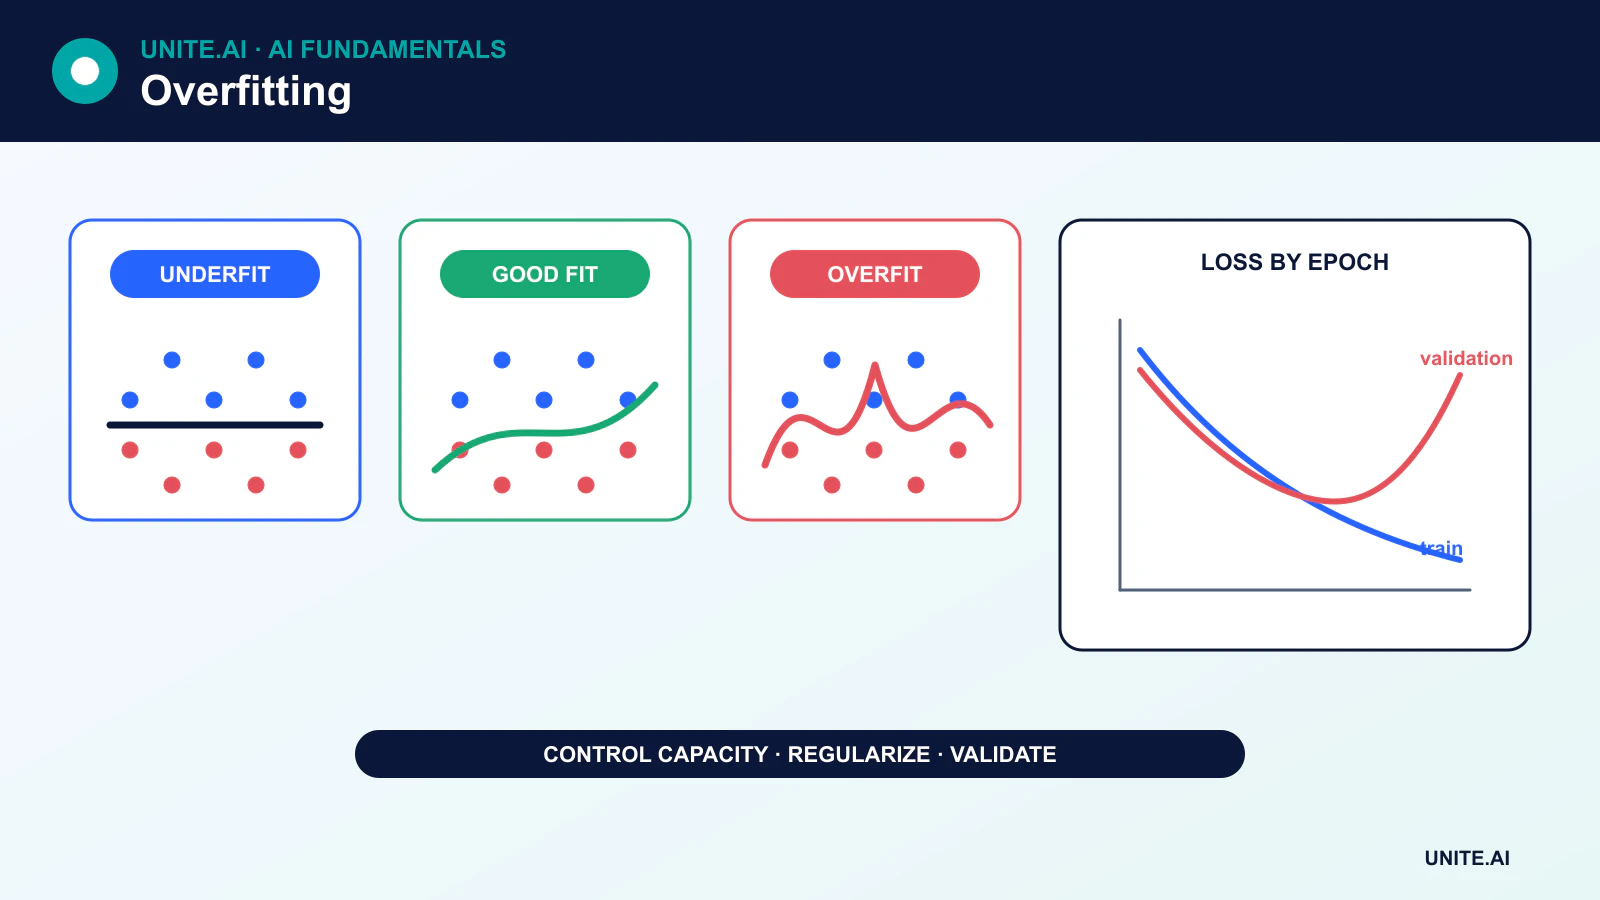
Potrivire, subînvățare și supraînvățare
Un model subînvăță când presupunerile sale sunt prea restrictive, caracteristicile omite semnale importante, optimizarea este inadecvată sau antrenamentul este insuficient. Adăugarea de caracteristici relevante sau a capacității poate ajuta, dar adăugarea simplă a unor caracteristici arbitrare poate crește zgomotul și supraînvățarea.
Un model supraînvăță când capacitatea sa efectivă este prea mare în raport cu informația din datele de antrenament. Exemple includ un arbore de decizie profund care creează frunze foarte mici, un polinom care urmărește fluctuații aleatorii sau o rețea neurală care memorează exemple.
Rolul datelor de antrenament, validare și testare
- Date de antrenament ajustează parametrii modelului.
- Date de validare selectează arhitectura, hiperparametrii, pragurile și momentul de oprire.
- Date de testare furnizează o estimare finală după ce aceste alegeri sunt finalizate.
Dacă setul de testare ghidează în mod repetat deciziile, devine parte a procesului de dezvoltare și nu mai furnizează o estimare finală neparțială. Validarea încrucișată poate utiliza mai eficient datele limitate, dar toate preprocesările și selecțiile de caracteristici trebuie să aibă loc în interiorul fiecărui pli de antrenament.
Întrerupere timpurie
În timpul antrenamentului, pierderea pe datele de antrenament de obicei continuă să scadă. Pierderea pe datele de validare poate scădea inițial și apoi să crească pe măsură ce modelul se specializează pe zgomotul de antrenament. Întreruperea timpurie salvează punctul de control cu cel mai bun obiectiv de validare sau se oprește după ce validarea nu s-a îmbunătățit pentru o perioadă de răbdare definită.
Punctul de control corect nu este cel cu cea mai mică pierdere pe datele de antrenament. Un set de testare final separat este evaluat după ce se finalizează deciziile de întrerupere timpurie și de ajustare.
Metode de regularizare
Penalizări ale greutății
Regularizarea L2 sau decăderea greutății descurajează valori mari ale parametrilor. Regularizarea L1 poate încuraja coeficienți rapizi (spars). Efectele lor depind de model și de optimizator; de exemplu, AdamW decuplează decăderea greutății de actualizarea adaptivă.
Dropout și regularizare stochastică
Dropout maschează aleatoriu activările în timpul antrenamentului. Alte metode elimină căi, perturbă caracteristicile sau netezesc etichetele. Aceste tehnici modifică obiectivul de antrenament și trebuie dezactivate sau gestionate corespunzător în timpul inferenței.
Augmentarea datelor
Augmentarea creează variații realiste — cum ar fi decupări, rotații, zgomot sau parafraze — care ar trebui să păstreze ținta. Transformările invalide pot schimba eticheta și pot dăuna modelului. Pentru viziune, instrumente precum Albumentations ajută la implementarea unor fluxuri controlate.
Controlul capacității
Arbori mai puțin adânci, mai puțini parametri, selecția de caracteristici, tăierea și clase de ipoteze mai simple pot reduce varianta. Tăierea arborilor se bazează pe criterii, nu pe eliminarea aleatorie a detaliilor învățate.
Scurgerile de date pot părea performanță excepțională
Scurgerea apare când informații indisponibile în momentul predicției intră în antrenament sau evaluare. Exemple comune includ normalizarea pe întregul set de date, împărțirea înregistrărilor repetate pe pliuri, utilizarea datelor viitoare pentru a prezice trecutul sau includerea unei caracteristici derivată din țintă.
Scurgerea nu este o supraînvățare obișnuită, dar creează aceeași diferență înșelătoare între rezultatele offline și cele din producție. Strategia de împărțire trebuie să respecte timpul, identitatea, locația și procesele de generare a datelor.
Schimbarea distribuției este o problemă separată
Un model poate să se generalizeze la distribuția sa de testare și totuși să eșueze când datele de producție se schimbă. Dispozitive noi, politici, populații, sezoane sau comportament adversarial pot modifica relația dintre intrare și țintă. Monitorizarea și reevaluarea periodică sunt necesare chiar și atunci când modelul inițial nu era supraînvățat.
Diagnosticarea supraînvățării
Folosiți curbele de învățare, varianta validării încrucișate, metricile subgrupurilor, calibrul și inspecția erorilor. Dacă atât performanța pe datele de antrenament, cât și cea de validare sunt slabe, concentrați-vă pe subînvățare, caracteristici, etichete sau optimizare. Dacă antrenamentul este solid iar validarea slabă, investigați capacitatea, scurgerile, regularizarea și reprezentativitatea înainte de a colecta pur și simplu mai multe date.
De ce apare supraînvățarea și cum să o detectăm
Supraînvățarea apare când un model învață tipare care reduc eroarea de antrenament, dar nu se generalizează la populația țintă. Cauzele includ capacitate excesivă în raport cu datele efective, zgomot în etichete, entități repetate, selecție flexibilă a caracteristicilor, scurgeri și ajustarea pe același set de validare. O diferență în creștere între performanța pe datele de antrenament și cea de validare este o dovadă comună, dar o diferență mică nu exclude supraînvățarea dacă ambele seturi sunt contaminate sau diferă de producție. Curbele de învățare în funcție de volumul de date și capacitate ajută la distingerea variabilității de bias.
Scurgerea este deosebit de înșelătoare: informații viitoare, duplicate, suprapunere de subiecte, preprocesare aplicată pe toate datele sau etichete codificate în metadate pot genera scoruri excelente pe datele reținute. Împărțiți pe unitatea care va fi nouă la implementare — pacient, client, mașină, locație sau timp — înainte de a adapta transformările sau augmentările. Păstrați un set de testare final sigilat în timp ce alegeți caracteristici, arhitectură și praguri. Dacă echipele inspectează în mod repetat rezultatele testului, setul de testare devine un alt set de validare și necesită înlocuire sau corecție formală.
Regularizare, selecție de model și drift în producție
Reduceți supraînvățarea cu date mai reprezentative, capacitate mai mică, decădere a greutății, dropout, întrerupere timpurie, augmentare, ansamblare sau constrângeri ce reflectă structura domeniului. Fiecare metodă are compromisuri: augmentarea poate distorsiona etichetele, dropout modifică optimizarea, iar ansamblurile adaugă costuri de servire. Validarea încrucișată estimează variabilitatea selecției, dar pliurile grupate sau conștiente de timp trebuie să păstreze limita de implementare. Comparați cu un model simplu și raportați incertitudinea pe pliuri sau semințe în loc să selectați rularea cea mai favorabilă.
Producția poate evidenția o formă diferită de eșec al generalizării când intrările, utilizatorii, stimulentele sau măsurătorile se modifică. Monitorizați distribuțiile caracteristicilor și ale predicțiilor, calibrul, rezultatele subgrupurilor și adevărul de bază întârziat. Nu reantrenați automat pe feedback netestat; deciziile modelului pot modela etichetele pe care le vede ulterior. Diagnosticați dacă eșecul provine din drift, conductele de date, schimbări de politică sau o țintă invalidă. Supraînvățarea este controlată prin design experimental și disciplină de ciclu de viață, nu printr-o singură setare de regularizare.
Exemplu practic: eliminarea scurgerilor într-un model de fraudă
Un clasificator inițial de fraudă obține scoruri extrem de bune deoarece evenimentele repetate de card și comerciant apar în rânduri aleatorii de antrenament și test, iar informațiile de chargeback înregistrate săptămâni mai târziu sunt incluse ca o caracteristică. Echipa reconstruieste timpul de disponibilitate al fiecărei caracteristici, elimină câmpurile post-decisie, grupează pe cont și folosește o împărțire temporală în avans. Performanța scade brusc, dar acum estimează decizia reală. Un punct de referință simplu bazat pe reguli și curbele de învățare ghidează complexitatea necesară a modelului.
Regularizarea și întreruperea timpurie sunt ajustate numai în cadrul pliurilor istorice. Evaluarea finală raportează precizia la capacitatea de revizuire, recall, calibrul și costul pe tip de fraudă și segment de client. În producție, etichetele confirmate sosesc târziu și sunt părtinitoare în funcție de tranzacțiile revizuite, astfel că monitorizarea separă driftul scorului de estimările de rezultat. Reantrenarea folosește cazuri judecate și redă scenariul conform politicii curente. Proiectul preferă un scor onest mai mic în locul unui scor înalt scurs care nu poate supraviețui în producție.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbarea distribuției, întreruperi ale dependențelor, utilizare greșită și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare etapizată, păstrați un fallback sigur și verificați monitorizarea prin introducerea deliberată de eșecuri. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, starea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și responsabilul de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se schimbă. Un sistem menținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar în care trebuie dezactivat sau înlocuit.
Întrebări frecvente
Poate un model simplu să supraînvețe?
Da. Selecția repetată a caracteristicilor, ajustarea pragurilor sau evaluarea pe același set reținut pot supraînvăța procesul de dezvoltare chiar și atunci când modelul final este simplu.
Întotdeauna mai multe date de antrenament rezolvă supraînvățarea?
Nu. Mai multe date reprezentative și corect etichetate pot ajuta, dar datele duplicate, părtinitoare, scurse sau din afara domeniului pot să nu fie utile. Obiectivul de învățare și designul de evaluare rămân importante.
Referințe principale












