
Fundamentele AI
Ce este coborârea gradientului?

 Adaugă Unite.AI la sursele tale preferate pe Google
Coborârea gradientului este o metodă de optimizare care ajustează parametrii modelului pentru a reduce o funcție obiectiv. În antrenarea rețelelor neuronale, acest obiectiv este de obicei o pierdere calculată pe exemple. Gradientul indică direcția celei mai abrupte creșteri locale, astfel că gradient descent face un pas în direcția opusă.
Gradientul descrie sensibilitatea locală; magnitudinea lui nu este o măsură directă a vitezei cu care un model „învață”. Progresul real depinde și de rata de învățare, curbură, zgomot, parametrizare, stare a optimizer‑ului și date.
Puncte cheie
- Backpropagation calculează gradientele, în timp ce gradient descent le folosește pentru a actualiza parametrii.
- Optimizarea pe mini‑batch este abordarea practică standard pentru învățarea profundă.
- Rata de învățare controlează scara actualizărilor și poate urma un program în loc să scadă după fiecare pas.
- Momentum, AdamW, tăierea și normalizarea abordează diferite probleme de optimizare.
Regula de actualizare de bază
Pentru vectorul de parametri θ, rata de învățare η și pierderea L:
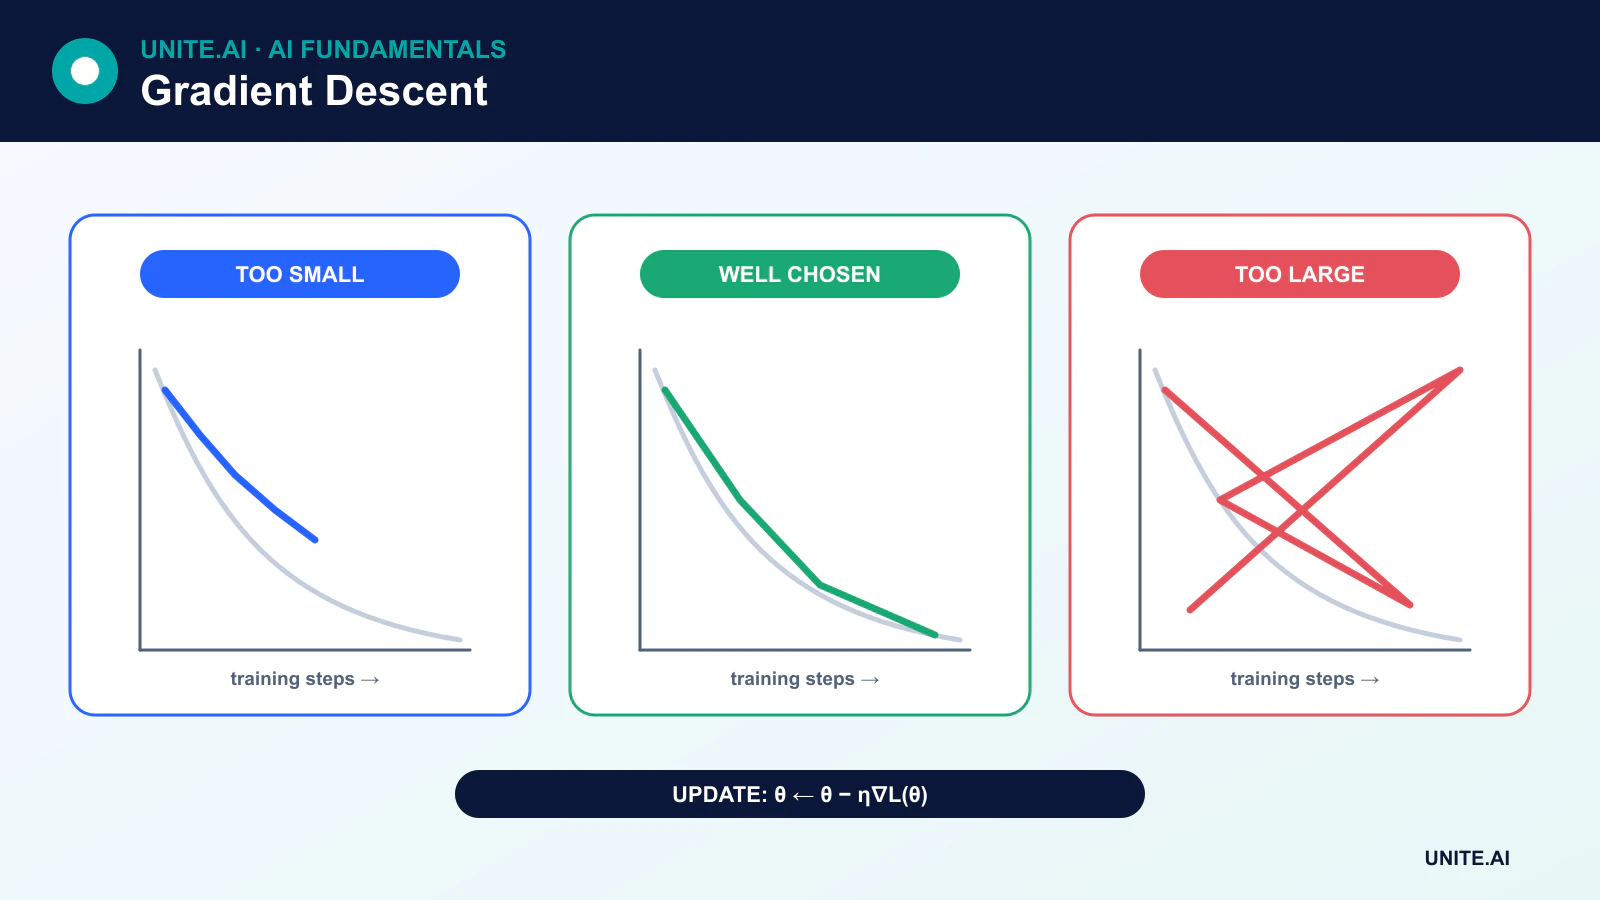
θ ← θ - η∇L(θ)
Gradientul ∇L(θ) conține o derivată parțială pentru fiecare parametru. Scăderea lui mută punctul în jos pe panta locală. Un punct staționar are gradient zero, dar poate fi un minim, maxim, punct șa sau o regiune plată. Suprafețele de pierdere ale învățării profunde sunt neconvexe, astfel că antrenamentul nu garantează găsirea unui minim global unic sau a unei pierderi zero.
Metode batch, stocastice și mini‑batch
Descendență gradientială batch
Descendența gradientială batch calculează gradientul folosind întregul set de antrenament pentru fiecare actualizare. Estimarea este stabilă, dar poate fi costisitoare în timp și memorie, iar o singură actualizare poate subutiliza acceleratoarele moderne.
Descendență gradientială stocastică
Descendența gradientială stocastică strictă folosește un exemplu selectat aleatoriu pentru fiecare actualizare. Gradientele sale sunt zgomotoase, ceea ce poate ajuta la explorarea suprafeței de pierdere, dar operațiile pe un singur exemplu pot fi ineficiente pe hardware paralel.
Descendență gradientială mini‑batch
Antrenamentul mini‑batch estimează gradientul dintr-un subset de exemple. Echilibrează zgomotul statistic cu operații matriceale eficiente și este abordarea uzuală în învățarea profundă. Dimensiunea batch‑ului influențează memoria, debitul, zgomotul gradientului, normalizarea și uneori generalizarea.
Alegerea ratei de învățare
O rată prea mare poate depăși regiunile utile sau poate cauza divergență. O rată prea mică poate face antrenamentul impracticabil de lent sau poate bloca progresul în regiuni plate. Scara optimă depinde de optimizer, dimensiunea batch‑ului, model, inițializare și obiectiv.
Programele pot încălzi treptat, pot scădea la anumite etape, pot urma o curbă cosinusoidală sau pot reacționa la progresul pe setul de validare. Rata nu trebuie să scadă monoton după fiecare actualizare. Repornirile calde și programele ciclice cresc intenționat rata în anumite părți ale antrenamentului.
Momentum
Momentum menține o medie exponențială mobilă a gradientelor anterioare. Poate accelera progresul în direcții coerente și reduce oscilațiile pe direcții abrupte și înguste. Momentum în stil Nesterov evaluează sau aproximează gradientul după ce s-a anticipat pe direcția momentum‑ului.
Optimizatori adaptivi
RMSProp scalează actualizările folosind o medie mobilă a gradientelor pătrate. Adam combină momentele de prim ordin asemănătoare cu momentum cu scalarea de al doilea ordin. AdamW decuplează decăderea ponderii de actualizarea adaptivă a gradientului și este larg utilizat pentru transformatoare.
Optimizatorii adaptivi fac adesea antrenamentul inițial mai ușor, dar nu sunt automat superiori pentru fiecare model sau pentru obiectivul final de generalizare. Compararea optimizer‑urilor necesită programe echivalente și reglaje atente.
Tăierea gradientului și acumularea
Tăierea gradientului limitează norma sau valorile unui gradient pentru a reduce impactul gradientelor explozive, în special în antrenamente recurente sau instabile. Acumularea gradientului adaugă gradientele din mai multe batch‑uri mici înainte de o actualizare, aproximând un batch efectiv mai mare când memoria este limitată.
Monitorizarea optimizării
Urmărește pierderea de antrenament și de validare, metricile sarcinii, rata de învățare, normele gradientului, normele parametrilor și erorile numerice. O scădere a pierderii de antrenament însoțită de deteriorarea performanței pe validare indică supraîncărcare, nu un succes de optimizare care ar trebui continuat automat.
Optimizarea minimizează obiectivul primit. O pierdere mică nu dovedește că datele, metrica sau comportamentul în lumea reală sunt adecvate. Scurgeri, etichete slabe și un obiectiv nealiniat pot produce un model bine optimizat, dar dăunător.
Geometria optimizării și regulile de actualizare
Descendența gradientului actualizează parametrii în direcția opusă gradientului unei pierderi. Descendența full‑batch folosește fiecare exemplu de antrenament la fiecare pas; descendența stochastică folosește unul; metodele mini‑batch estimează gradientul dintr-un subset și domină învățarea profundă. Rata de învățare stabilește scara pasului. O rată prea mică irosește calculul sau blochează progresul; una prea mare oscilează sau diverge. Momentum acumulează o direcție în mișcare, în timp ce metodele adaptive, cum ar fi Adam, scalează coordonatele folosind momentele gradientului. Bias‑urile lor implicite diferite pot genera modele cu pierdere de antrenament similară, dar cu generalizare diferită.
Suprafețele de pierdere ale rețelelor neuronale conțin regiuni plate și ascuțite, puncte șa, simetrii și direcții prost condiționate. Scalarea caracteristicilor, normalizarea, inițializarea, conexiunile reziduale și precondiționarea modifică geometria percepută de optimizer. Programele pot încălzi, scădea, cicla sau reacționa la platouri. Decăderea ponderii este distinctă de simpla adăugare a unei penalizări L2 în unele optimizatoare adaptive. Dimensiunea batch‑ului influențează zgomotul, memoria, paralelismul și regimul ratei de învățare, astfel că compararea optimizer‑urilor necesită bugete de antrenament echivalente și reglaje atente.
Diagnosticare, reproductibilitate și oprire
Urmărește pierderea de antrenament și de validare, metricile sarcinii, normele gradientului și ale parametrilor, rata de învățare, debitul și avertismentele numerice. Divergența poate apărea din batch‑uri corupte, etichete invalide, precizie mixtă instabilă sau reducere incorectă a pierderii. Platourile pot indica subcapacitate, activări saturate, caracteristici slabe, regularizare excesivă sau o problemă a programului. Supraîncărcarea necesită date, augmentare, regularizare sau oprire timpurie – nu o afirmație că optimizer‑ul a eșuat. Inspectează erorile reprezentative și compară cu o bază simplă înainte de a crește complexitatea antrenamentului.
Reproductibilitatea cere sămânțe, ordine a datelor, cod, configurație, versiuni de hardware și biblioteci, deși unele nuclee de acceleratoare rămân nedeterministe. Salvează puncte de control cu starea optimizer‑ului și a programului pentru ca antrenamentul să poată fi reluat consistent. Selectează un punct de control pe criterii de validare stabilite în prealabil și rezervă un set de test neatinse. În antrenamentul distribuit, confirmă dimensiunea batch‑ului efectiv, media gradientului și gestionarea lucrătorilor eșuați. Optimizarea minimizează obiectivul ales pe datele disponibile; nu garantează probabilități calibrate, raționament cauzal, echitate, siguranță sau utilitate în lumea reală.
Exemplu practic: reglarea unui optimizer pentru un model lingvistic
O echipă fixează tokenizatorul, ordinea datelor, modelul, batch‑ul efectiv și bugetul de token‑uri de antrenament, apoi compară SGD cu momentum și AdamW pe programe de rată de învățare defensibile. Încălzirea, scăderea, decăderea ponderii, tăierea și precizia sunt înregistrate. Fiecare candidat rulează mai multe sămânțe, iar validarea folosește o fereastră de timp reținută plus evaluări ale sarcinii. Debit și consum energetic sunt raportați alături de pierdere, astfel încât un optimizer ușor mai bun să nu fie ales la cost disproporționat.
Diagnosticile relevă dacă instabilitatea provine dintr-un fragment de date, dimensiune excesivă a pasului, subflux sau arhitectura modelului. Punctele de control păstrează starea optimizer‑ului și a programului și sunt reluate într-un test. Alegerea finală se bazează pe calitatea și robustețea validării, nu pe cea mai mică pierdere de antrenament. Un set de test sigilat este rulat o singură dată după selecție. Inferența în producție este calibrată și monitorizată separat, deoarece succesul optimizer‑ului în pre‑antrenament nu stabilește un comportament sigur sau veridic.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definește utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabilește un punct de referință reproductibil și un set de evaluare versionat înainte de reglare. Testează cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi de dependență, utilizare greșită și grupurile sau mediile cele mai susceptibile de a fi subreprezentate. Măsoară calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrează fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuie autoritatea pentru eliberare, excepții, modificări, rollback și retragere. Folosește o lansare etapizată, păstrează un fallback sigur și verifică monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrării, comportamentul ieșirii, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definește praguri de alertă și un responsabil de răspuns, apoi revizuiește dovezile din lumea reală după implementare în loc să presupui că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și retenție, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Descendența gradientului atinge întotdeauna minimul global?
Nu. Pentru obiective convexe, condițiile adecvate oferă garanții puternice. Obiectivele rețelelor profunde sunt neconvexe, iar optimizer‑urile practice caută de obicei o soluție utilă în loc să demonstreze că au găsit minimul global unic.
De ce un gradient zero poate fi înșelător?
Un gradient zero sau foarte mic poate indica un minim, maxim, punct șa, saturație sau un platou plat. Diagnosticile de antrenament trebuie să ia în considerare istoricul pierderii, curbură, scară a parametrilor și performanța pe setul de validare.
Referințe principale












