
Fundamentele AI
Ce este regresia liniară?

 Adaugă Unite.AI la sursele tale preferate pe Google
Regresia liniară modelează o țintă continuă ca o combinație liniară a uneia sau mai multor caracteristici de intrare. Este utilizată pentru predicție, estimare și ca o bază transparentă pentru a înțelege dacă un model mai complicat adaugă valoare semnificativă.
Cuvintele variabilă independentă și variabilă dependentă descriu roluri în model, nu o cauzalitate dovedită. O regresie poate identifica o asociere, în timp ce confuzia, biasul de selecție, cauzalitatea inversă sau eroarea de măsurare explică relația.
Aspecte principale
- Ținta y este modelată din caracteristicile de intrare X; versiunea anterioară a articolului a inversat aceste etichete într-o explicație a formulei.
- Metoda celor mai mici pătrate obișnuită minimizează suma reziduurilor pătratate.
- Diagnosticarea reziduurilor și ipotezele sunt importante pentru inferență și incertitudine.
- Regularizarea ridge și lasso ajută când predictorii sunt numeroși sau corelați.
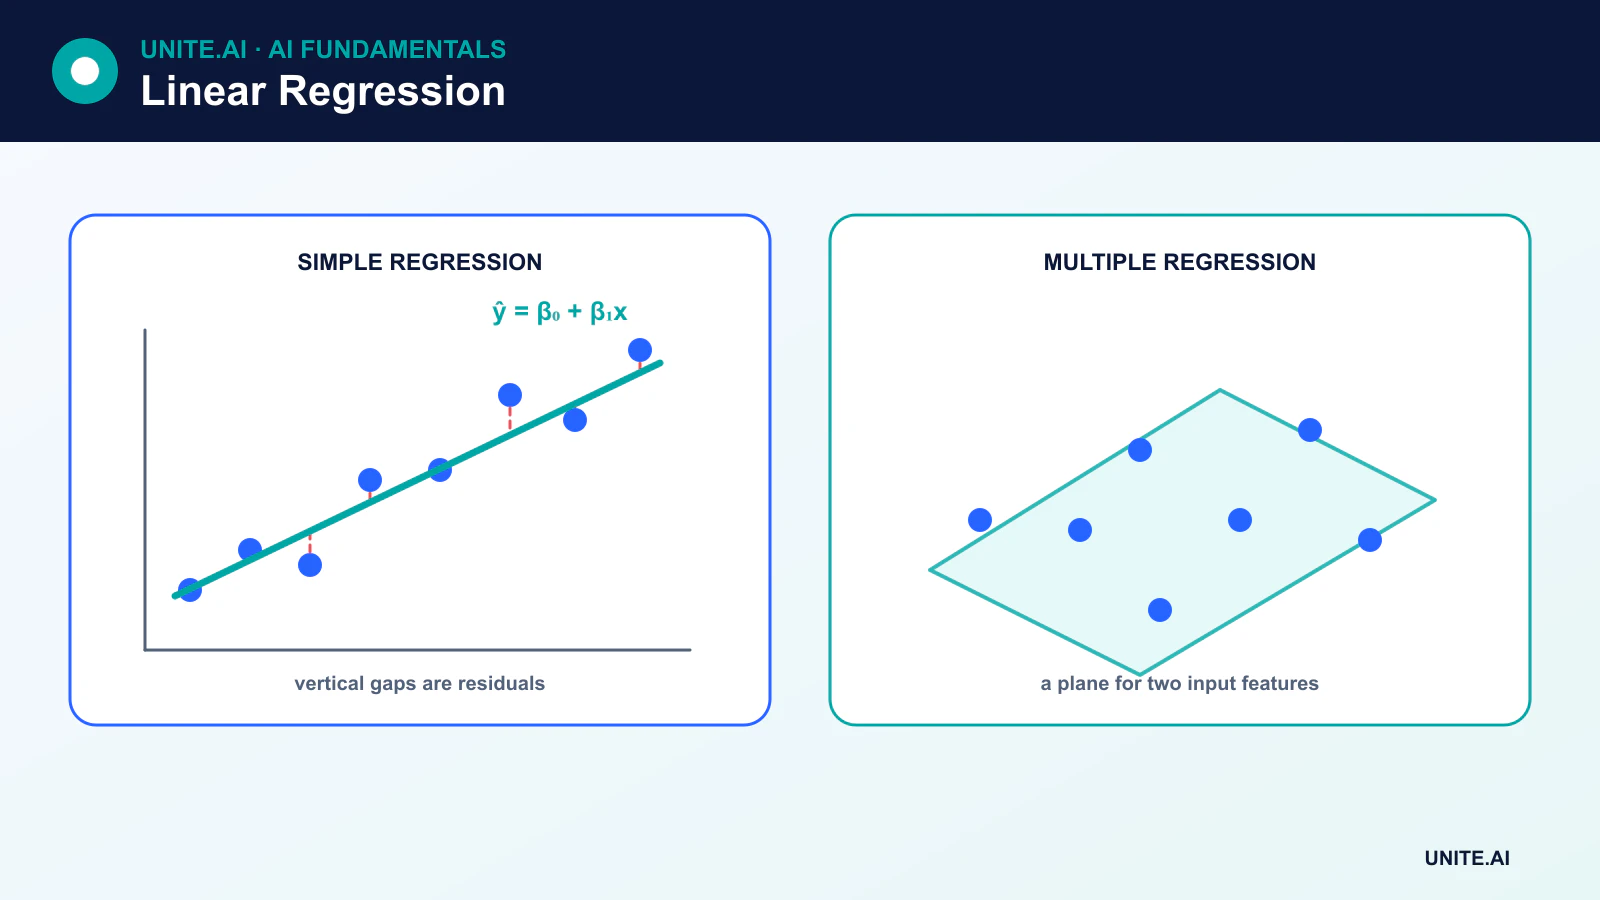
Regresie liniară simplă
Cu o singură caracteristică, modelul este:
ŷ = β₀ + β₁x
β₀ este interceptul și β₁ este panta. Reziduu pentru observația i este yᵢ - ŷᵢ. Metoda celor mai mici pătrate (OLS) alege coeficienții care minimizează suma reziduurilor pătratate.
Panta estimează schimbarea așteptată a țintei asociată cu o modificare cu o unitate a caracteristicii în cadrul modelului ajustat. Nu ar trebui descrisă ca un efect cauzal decât dacă designul studiului și ipotezele susțin identificarea cauzală.
Regresie liniară multiplă
Cu p caracteristici:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Fiecare coeficient este interpretat condiționat de celelalte caracteristici incluse. Regresia multiplă poate încorpora variabile categorice prin codare, termeni polinomiali și interacțiuni. Rămâne „liniară” deoarece este liniară în coeficienți, chiar dacă sunt incluse caracteristici transformate, cum ar fi x².
Presupuneri și diagnosticare
Pentru predicție, întrebarea principală este cât de bine se generalizează modelul. Pentru testele clasice ale coeficienților și intervalele, presupunerile suplimentare devin importante:
- Liniaritate: media condițională este reprezentată de forma liniară aleasă.
- Erori independente sau modelate corect: observațiile repetate, grupate, spațiale sau de serie temporală pot necesita o structură de eroare diferită.
- Varianță constantă a erorilor: heteroscedasticitatea afectează erorile standard și estimările incertitudinii.
- Multicoliniaritate limitată: predictorii puternic corelați fac coeficienții individuali instabili.
- Distribuția reziduurilor: normalitatea este relevantă pentru unele inferențe pe eșantioane mici, nu o cerință ca fiecare caracteristică să fie distribuită normal.
Diagramele reziduurilor, măsurile de leverage și influență, precum și revizuirea domeniului pot identifica valori aberante, nonliniaritate, variație în schimbare sau observații care domină ajustarea.
Evaluarea predicțiilor
- Eroarea medie absolută (MAE) calculează media dimensiunii reziduurilor absolute.
- Eroarea medie pătratică (MSE) acordă o greutate mai mare erorilor mari.
- Rădăcina erorii medii pătratice (RMSE) readuce eroarea pătratică la unitățile țintei.
- R² compară variația reziduurilor cu o bază constantă pe datele evaluate.
R² nu reprezintă acuratețea, nu stabilește cauzalitatea și poate fi negativ pe datele de testare. Validarea ar trebui să corespundă setării reale de predicție, incluzând divizări în funcție de timp sau grupuri, atunci când este necesar.
Ridge, lasso și elastic net
Regresia ridge adaugă o penalizare L2 care micșorează coeficienții și stabilizează predictorii corelați. Lasso adaugă o penalizare L1 și poate seta coeficienții la zero. Elastic net combină ambele. Caracteristicile necesită de obicei o scalare compatibilă înainte ca aceste penalizări să fie comparate.
Regularizarea introduce un bias în schimbul unei variante mai mici și poate reduce supraînvățarea. Intensitatea penalizării este aleasă prin validare, nu pe setul final de testare.
Când regresia liniară nu este instrumentul potrivit
Un model liniar poate eșua când relațiile sunt puternic neliniare, erorile depind de valori anterioare, distribuțiile țintă necesită modelare specializată sau câteva valori aberante domină pierderea pătratică. Decision trees, modelele liniare generalizate, modelele de serie temporală, regresia robustă sau metodele neliniare pot fi mai potrivite.
Chiar și atunci când un model complex are succes, regresia liniară rămâne o bază valoroasă. Dacă un sistem mare nu o poate depăși în mod fiabil, complexitatea suplimentară poate să nu fie justificată.
Presupuneri ale modelului, estimare și diagnosticare
Regresia liniară modelează media condițională a unui rezultat numeric ca un intercept plus predictori ponderați. Metoda celor mai mici pătrate obișnuită alege coeficienții care minimizează reziduurile pătratate. Coeficienții descriu schimbarea așteptată a rezultatului pentru o modificare cu o unitate a predictorului, în timp ce celelalte variabile incluse rămân constante, conform modelului specificat. Aceasta este o asociere, cu excepția cazului în care presupunerile de identificare cauzală și designul studiului justifică altceva. Unitățile, codificarea, transformările, interacțiunile și categoriile de referință determină interpretarea, astfel că coeficienții fără un dicționar de date sunt incompleți.
Inferența clasică se bazează pe ipoteze privind forma funcțională, erorile independente, varianța constantă și distribuția erorilor pentru anumite teste și intervale. Graficele reziduu versus ajustat dezvăluie nonliniaritate sau heteroscedasticitate; graficele Q–Q evaluează comportamentul cozii; diagnosticele de leverage și influență identifică observațiile care afectează puternic estimările. Predictorii corelați amplifică incertitudinea și fac coeficienții individuali instabili chiar și când predicțiile rămân adecvate. Erori standard robuste, transformări, spline-uri, structuri ierarhice sau alt model pot fi necesare în locul ștergerii punctelor de date incomode.
Regularizare, evaluare și utilizare responsabilă
Regresia ridge micșorează coeficienții cu o penalizare L2, în timp ce lasso poate seta unii la zero cu o penalizare L1; elastic net le combină. Standardizați predictorii când scara penalizării trebuie să fie comparabilă și selectați intensitatea prin validare sau cross‑validare. Evaluați eroarea medie absolută, rădăcina erorii medii pătratice, distribuția reziduurilor, calibrarea pe intervale și incertitudinea, cu divizări în funcție de timp sau grup care reflectă utilizarea. Comparați cu o bază medie și alternative neliniare, dar păstrați modelele liniare când transparența și stabilitatea sunt valoroase.
Extrapolarea dincolo de intervalul observat al predictorilor urmează linia ajustată fără dovezi și poate fi periculoasă. Monitorizați intervalele caracteristicilor, lipsurile, reziduurile și eroarea subgrupurilor în producție. Intervalele de predicție descriu incertitudinea rezultatului individual și sunt mai largi decât intervalele de încredere pentru medie; ambele necesită ipoteze. Evitați controlul variabilelor care introduc bias cauzal atunci când scopul este estimarea efectului. Regresia liniară este un instrument precis pentru o relație definită, nu o garanție universală că lumea este liniară sau că un coeficient reprezintă o intervenție.
Exemplu practic: estimarea timpului de livrare
O echipă logistică modelează durata livrării în funcție de distanță, nivelul serviciului, regiune, ziua săptămânii și condițiile meteorologice cunoscute. Inspectează tiparele neliniare ale reziduurilor și adaugă spline-uri și interacțiuni justificate, în loc să trateze o ecuație liniară ca fizică literală. Grupurile de transportatori și rute definesc plierea pentru validare. Se raportează eroarea medie absolută, eroarea la coadă, acoperirea intervalului și biasul sistematic. Livrările anulate și datele înregistrate după sosire sunt excluse sau modelate explicit.
Coeficienții sunt documentați în unități și verificați pentru instabilitate în prezența predictorilor corelați. Modelul refuză extrapolarea dincolo de intervalele validate de distanță și regiune. Intervalele de predicție însoțesc estimările, iar programarea ulterioară folosește incertitudinea lor. Monitorizarea urmărește intervalele caracteristicilor, reziduurile, acoperirea intervalului și biasul după modificările rețelei. Nu se face o afirmație cauzală despre transportator sau vreme pe baza coeficienților predictivi; experimente operaționale sau o identificare mai puternică ar fi necesare pentru a susține intervenția.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazurile obișnuite, condițiile limită, intrările defecte sau lipsă, schimbarea distribuției, întreruperea dependențelor, utilizarea incorectă și grupurile sau mediile care ar putea fi subservite. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare etapizată, păstrați o opțiune de rezervă sigură și verificați monitorizarea cu defecțiuni injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Regresia liniară necesită doar o singură variabilă de intrare?
Nu. Regresia simplă are un predictor, în timp ce regresia liniară multiplă poate folosi multe caracteristici numerice, categorice codificate, transformate și de interacțiune.
Regresia liniară poate demonstra cauzalitatea?
Nu. Interpretarea cauzală necesită un design de cercetare defensabil și presupuneri privind confuzia, selecția, măsurarea și intervenția. Un coeficient predictiv singur descrie o asociere în modelul ajustat.
Referințe principale












