
Fundamentele AI
Ce este învățarea federată?

 Adaugă Unite.AI la sursele tale preferate pe Google
Învățarea federată antrenează un model partajat pe mai multe dispozitive sau organizații, menținând datele brute de antrenament ale fiecărui participant la nivel local. Un coordonator distribuie parametrii modelului, clienții calculează actualizări pe propriile înregistrări, iar o etapă de agregare combină acele actualizări.
Păstrarea înregistrărilor la nivel local este utilă, dar nu este sinonimă cu confidențialitatea sau securitatea. Actualizările modelului pot scurge informații, clienții compromiși pot otrăvi antrenamentul, iar coordonatorul are în continuare nevoie de autentificare, securitate în transport, controale de acces și un model de încredere definit.
Aspecte cheie
- Învățarea federată mută calculul la datele distribuite; nu mută setul de date brut la un singur antrenor central.
- Sistemele cross-device implică numeroase dispozitive intermitente, în timp ce sistemele cross-silo implică un număr mai mic de organizații mai stabile.
- Agregarea sigură și confidențialitatea diferențială abordează riscuri diferite și pot fi combinate.
- Datele non-IID, lățimea de bandă limitată, participarea nesigură și actualizările malițioase sunt constrângeri de bază în proiectare.
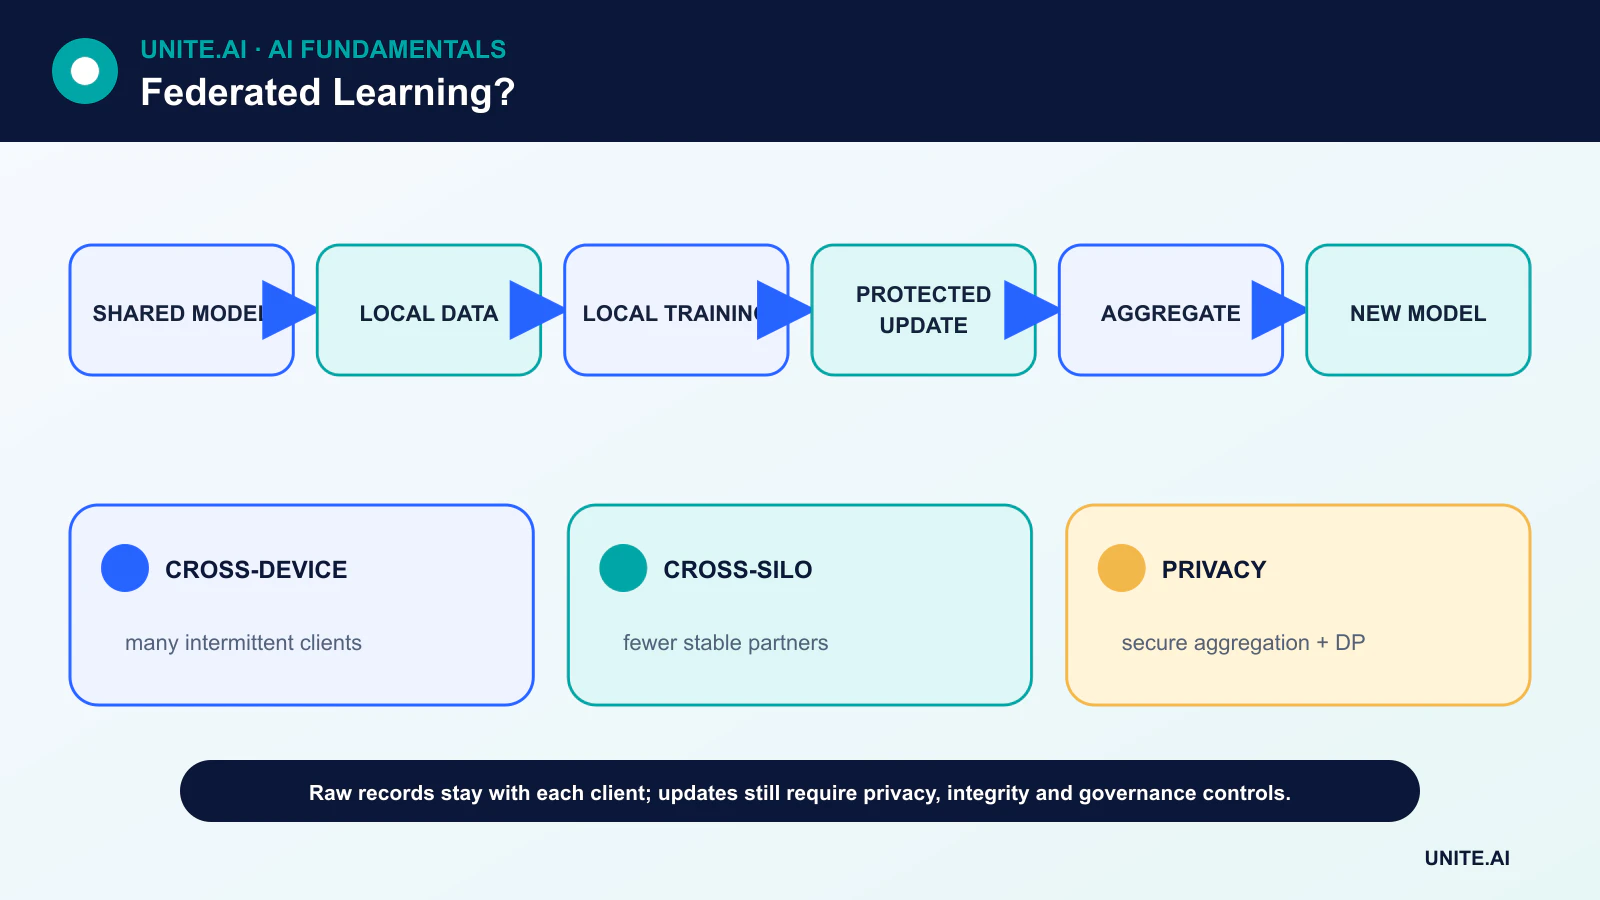
Ciclul de viață al mediei federate
Un ciclu tipic începe când un coordonator selectează clienții eligibili și trimite modelul curent. Fiecare client antrenează local pentru un număr limitat de pași, producând o actualizare de parametri sau de gradient. Coordonatorul agregă actualizările eligibile — adesea cu ponderi bazate pe numărul de exemple locale — și publică noul model partajat.
Doar o fracțiune din clienți poate participa la fiecare ciclu. Protocolul trebuie să suporte conexiuni întrerupte, neconcordanțe de versiune și dispozitive care nu pot antrena în timp ce se încarcă, sunt ocupate sau offline. Comunicarea poate domina calculul, astfel încât comprimarea actualizărilor și reducerea numărului de runde de comunicare contează adesea mai mult decât viteza brută a acceleratorului.
Învățare cross-device versus cross-silo
Învățarea federată cross-device poate implica telefoane, senzori sau browsere deținute de numeroși indivizi. Clienții sunt numeroși, cu încredere scăzută și disponibili intermitent. Învățarea federată cross-silo conectează de obicei un set mai mic de spitale, bănci sau unități de afaceri cu infrastructură stabilă și guvernanță contractuală.
Cele două medii necesită presupuneri diferite privind identitatea, auditul și eșecurile. Un proiect cross-silo poate negocia o schemă partajată și un proces de validare; un serviciu cross-device poate trebui să gestioneze milioane de versiuni de software și seturi de date locale extrem de inegale.
Agregare sigură, confidențialitate diferențială și criptare
Agregarea sigură este un protocol criptografic care permite serverului să recupereze un agregat fără a citi actualizarea fiecărui client. Confidențialitatea diferențială limitează cât de mult poate depinde rezultatul publicat de orice înregistrare sau participant prin tăierea contribuțiilor și adăugarea de zgomot calibrat.
Niciunul dintre mecanisme nu rezolvă toate riscurile. Agregarea sigură nu face agregatul inofensiv, iar confidențialitatea diferențială impune un compromis între acuratețe și confidențialitate care trebuie luat în calcul printr-un buget de confidențialitate explicit. Criptarea protejează datele în tranzit sau în stocare; nu previne, de una singură, inferența dintr-un model.
Date non-IID și calitatea modelului
Datele clienților rar sunt independente și identic distribuite. Un model de tastatură vede vocabularul fiecărei persoane; spitalele deservesc populații diferite; fabricile folosesc echipamente diferite. Aceste diferențe pot încetini convergența și pot ascunde performanțe slabe pentru grupuri mici de clienți.
Evaluarea ar trebui să includă metrici globale, distribuții pe client sau cohortă, calibrare și analiză a eșecurilor. Un set de testare central poate fi convenabil, dar insuficient. Aceasta leagă învățarea federată de calitatea datelor de învățare automată și de guvernanța datelor structurate și nestructurate.
Amenințări și controale operaționale
Clienții malițioși pot trimite actualizări otrăvite, clienții sybil pot distorsiona agregarea, iar un server compromis poate distribui un model țintit. Apărările includ înscriere autentificată, detectarea anomaliilor, agregare robustă, validarea actualizărilor, limitarea ratei și atestarea software reproducibilă acolo unde este practică.
Învățarea federată face parte dintr-un program mai larg de securitate cibernetică. Echipele ar trebui să documenteze cine controlează coordonatorul, ce metadate sunt colectate, cum pot părăsi participanții, cum sunt restaurate modelele și ce se întâmplă când testele de confidențialitate sau calitate eșuează.
Optimizare federată și heterogenitatea datelor
Învățarea federată trimite un model sau o sarcină de actualizare către clienții participanți, antrenează local și agregă actualizările fără a centraliza exemplele brute. În medierea federată, clienții selectați rulează mai mulți pași de optimizare locală, iar serverul calculează o medie ponderată, de obicei în funcție de numărul de exemple. Rondele de comunicare, epocile locale, selecția și ratele de învățare echilibrează lățimea de bandă cu convergența. Setările cross-device implică numeroase telefoane sau senzori nesiguri; setările cross-silo implică mai puține organizații cu putere de calcul, identitate și guvernanță mai puternice.
Datele clienților sunt de obicei non-independente și inegale: utilizatorii diferă în comportament, distribuția etichetelor, volumul și disponibilitatea. Antrenamentul local poate devia în direcții incompatibile, făcând o medie simplă instabilă sau părtinitoare spre clienții activi cu volum mare. Algoritmii pot folosi termeni proximali, optimizare adaptivă a serverului, grupare, personalizare sau variabile de control. Evaluarea ar trebui să raporteze performanța globală și la nivel de client, clienții din coadă, frecvența participării, convergența, comunicarea și consumul de energie. O medie bună poate ascunde faptul că populațiile mici sau rare de clienți primesc un model mai slab.
Confidențialitate, securitate și inginerie de sistem
Păstrarea datelor la nivel local nu garantează, de una singură, confidențialitatea. Gradientii și actualizările pot scurge apartenența sau caracteristici, în timp ce modelul final poate memora exemple. Agregarea sigură ascunde actualizările individuale de server, iar confidențialitatea diferențială limitează contribuția informațională prin tăiere și adăugare de zgomot, dar ambele modifică utilitatea și complexitatea operațională. Specificați modelul de amenințare, unitatea de confidențialitate, bugetul și componentele de încredere. Criptarea în tranzit este necesară, dar nu previne un client malițios, o actualizare otrăvită, un coordonator compromis sau un atac de inferență.
Apărările includ clienți autentificați, agregare robustă, verificări de anomalii, limitări ale actualizărilor, enclave securizate în unele proiecte și validare împotriva datelor curate. Atacatorii sybil pot crea mulți clienți; porțile din spate pot supraviețui medierii; eliminarea actualizărilor suspecte poate exclude și comportamente rare legitime. Versionați codul clientului, susțineți runde întrerupte, preveniți redarea și proiectați pentru clienți întârziat și constrângeri ale dispozitivului. Consimțământul, păstrarea, regulile regionale și ștergerea se aplică în continuare datelor locale și actualizărilor derivate.
Exemplu de implementare și guvernanță
O tastatură mobilă poate antrena îmbunătățiri de predicție a cuvântului următor la nivel local, dar lansarea ar trebui să folosească o populație eligibilă în funcție de capacitatea dispozitivului și consimțământ, să colecteze actualizări protejate tăiate și să le compare cu o bază congelată. Validați performanța limbii și a dialectului, bateria, utilizarea datelor și riscul de memorare înainte de lansare. Clienții au nevoie de sarcini de antrenament și actualizări de model semnate; serverul are nevoie de o configurație de rundă auditată și de posibilitatea de rollback. Învățarea federată este o arhitectură pentru învățare distribuită sub constrângeri, nu un substitut pentru date reprezentative, inginerie a confidențialității sau responsabilitate.
Exemplu practic: învățare federată între spitale
Spitalele antrenează un model partajat de calitate a imaginii fără a agrega scanările. Un protocol comun definește metadatele dispozitivului, etichetele, preprocesarea, eligibilitatea clienților, epocile locale, tăierea și agregarea sigură. Site-urile păstrează datele pacienților și trimit actualizări protejate, în timp ce un coordonator evaluează fiecare ciclu pe seturi locale de testare. Rezultatele raportează performanța la nivel de site și a cozii, nu doar o medie ponderată pe volum, deoarece spitalele mici și tipurile de dispozitive ar putea fi altfel ignorate.
Modelul de amenințare acoperă actualizări malițioase, scurgerea de apartenență, clienți compromiși și accesul coordonatorului. Confidențialitatea diferențială este configurată cu un buget documentat și utilitate testată. Pachetele de model și sarcină sunt semnate; site-urile pot să se retragă și actualizările sunt auditate. Un ciclu otrăvit sau instabil nu înlocuiește automat modelul implementat. Proiectul păstrează linii de bază locale și revizuire clinică și tratează arhitectura federată ca un control de confidențialitate în cadrul obligațiilor mai largi de consimțământ, securitate și guvernanță.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproducibilă și un set de evaluare versionat înainte de reglare. Testați cazuri obișnuite, condiții de frontieră, intrări malformate sau lipsă, schimbarea distribuției, întreruperi ale dependențelor, utilizare incorectă și grupurile sau mediile cel mai probabil subreprezentate. Măsurați calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, rollback și retragere. Utilizați o lansare etapizată, păstrați o alternativă sigură și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, starea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din viața reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem menținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care trebuie dezactivat sau înlocuit.
Întrebări frecvente
Învățarea federată garantează că datele private nu pot fi scurse?
Nu. Reduce mișcarea datelor brute, dar actualizările și modelele finale pot încă dezvălui informații. Confidențialitatea necesită un model de amenințare și controale tehnice și organizatorice suplimentare.
Când este antrenamentul centralizat mai simplu?
Când datele pot fi centralizate legal și în siguranță, antrenamentul centralizat este adesea mai ușor de depanat, reproduce și monitoriza. Învățarea federată este justificată atunci când distribuția este o cerință reală, nu doar un scop de marketing.
Referințe principale












