
Lideri de opinie
Trei tehnici de învățare a mașinilor care păstrează confidențialitatea, care rezolvă cea mai importantă problemă a acestui deceniu

 Adaugă Unite.AI la sursele tale preferate pe Google
De Amogh Tarcar, cercetător în domeniul învățării mașinilor și al inteligenței artificiale, Persistent Systems. (PERSISTENT.BO )
Confidențialitatea datelor, conform experților dintr-o gamă largă de domenii, va fi cea mai importantă problemă a acestui deceniu. Acest lucru este valabil în special pentru învățarea mașinilor (ML), unde algoritmii sunt hrăniți cu cantități mari de date.
În mod tradițional, tehnicile de modelare ML s-au bazat pe centralizarea datelor din multiple surse într-un singur centru de date. După cum știm, modelele ML sunt la cel mai puternic nivel atunci când au acces la cantități mari de date. Cu toate acestea, există o serie de provocări de confidențialitate care vin odată cu această tehnică. Agregarea datelor diverse din multiple surse este mai puțin fezabilă astăzi din cauza problemelor de reglementare, cum ar fi HIPAA, GDPR și CCPA. Mai mult, centralizarea datelor crește sfera și amploarea abuzului de date și a amenințărilor la adresa securității sub forma scurgerilor de date.
Pentru a depăși aceste provocări, au fost dezvoltate mai multe piloni ai învățării mașinilor care păstrează confidențialitatea (PPML), cu tehnici specifice care reduc riscul de confidențialitate și asigură că datele rămân în mod rezonabil securizate. Iată câteva dintre cele mai importante:
1. Învățarea federativă
Învățarea federativă este o tehnică de antrenare a mașinilor care inversează problema agregării datelor. În loc de a agrega date pentru a crea un singur model ML, învățarea federativă agregă modelele mașinilor însele. Acest lucru asigură că datele nu părăsesc niciodată locația lor sursă și permite mai multor părți să colaboreze și să construiască un model ML comun fără a partaja direct date sensibile.
Funcționează astfel. Începeți cu un model de bază ML care este apoi partajat cu fiecare nod client. Aceste noduri rulează apoi antrenament local pe acest model, utilizând datele proprii. Actualizările modelului sunt periodic partajate cu nodul coordonator, care procesează aceste actualizări și le fuzionează pentru a obține un nou model global. În acest fel, obțineți insight-uri din seturi de date diverse fără a fi nevoie să partajați aceste seturi de date.

Sursă: Persistent Systems
În contextul sănătății, acesta este un instrument incredibil de puternic și conștient de confidențialitate pentru a păstra datele pacienților în siguranță, în timp ce oferă cercetătorilor înțelepciunea mulțimii. Prin nepartajarea datelor, învățarea federativă creează un strat suplimentar de securitate. Cu toate acestea, modelele și actualizările modelului însele prezintă încă un risc de securitate, dacă sunt lăsate vulnerabile.
2. Confidențialitate diferențială
Modelele ML sunt adesea ținte ale atacurilor de inferență a apartenenței. Să presupunem că ați partaja datele dvs. de sănătate cu un spital pentru a ajuta la dezvoltarea unui vaccin împotriva cancerului. Spitalul păstrează datele dvs. în siguranță, dar utilizează învățarea federativă pentru a antrena un model ML disponibil public. Câteva luni mai târziu, hackerii utilizează un atac de inferență a apartenenței pentru a determina dacă datele dvs. au fost utilizate în antrenamentul modelului sau nu. Ei apoi transmit informații unei companii de asigurări, care, pe baza riscului dvs. de a dezvolta cancer, ar putea majora primele dvs.
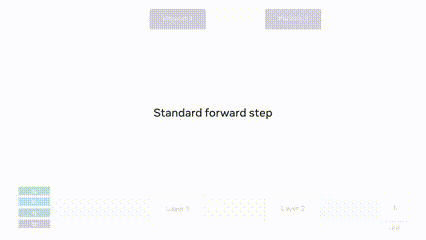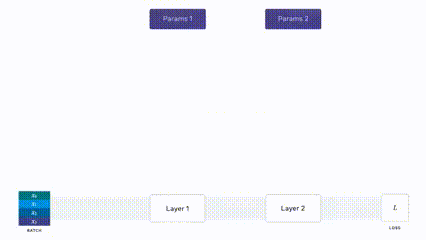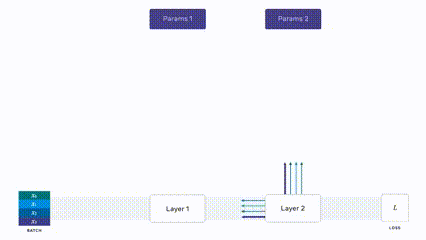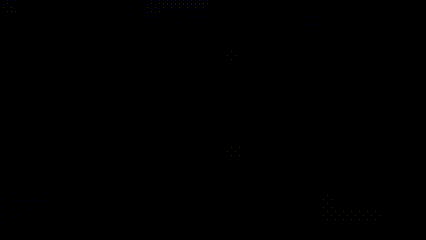
Confidențialitatea diferențială asigură că atacurile adversarilor asupra modelelor ML nu vor putea identifica puncte de date specifice utilizate în timpul antrenamentului, reducând astfel riscul de expunere a datelor sensibile de antrenament în învățarea mașinilor. Acest lucru se realizează prin aplicarea “zgomotului statistic” pentru a perturba datele sau parametrii modelului de învățare a mașinilor în timpul antrenamentului, făcând dificilă executarea atacurilor și determinarea dacă datele unei persoane au fost utilizate pentru a antrena modelul.
De exemplu, Facebook a lansat recent Opacus, o bibliotecă de înaltă viteză pentru antrenarea modelelor PyTorch utilizând un algoritm de antrenament ML cu confidențialitate diferențială, numit Diferențial Private Stochastic Gradient Descent (DP-SGD). Gifa de mai jos evidențiază modul în care utilizează zgomotul pentru a masca datele.
Sursă: Blogul Opacus al Facebook
Acest zgomot este guvernat de un parametru numit Epsilon. Dacă valoarea Epsilon este scăzută, modelul are o confidențialitate perfectă a datelor, dar o utilitate și o acuratețe slabă. Invers, dacă aveți o valoare Epsilon ridicată, confidențialitatea datelor dvs. va scădea, în timp ce acuratețea va crește. Trucul constă în a găsi un echilibru pentru a optimiza ambele.
3. Criptarea omogetică
Criptarea standard este în mod tradițional incompatibilă cu învățarea mașinilor, deoarece odată ce datele sunt criptate, nu mai pot fi înțelese de algoritmul ML. Cu toate acestea, criptarea omogetică este un sistem de criptare special care ne permite să continuăm să efectuăm anumite tipuri de calcule.

Sursă: OpenMined
Puterea acestei tehnici constă în faptul că antrenamentul poate avea loc într-un spațiu complet criptat. Nu numai că protejează proprietarii de date, dar protejează și proprietarii de modele. Proprietarul modelului poate rula inferențe pe date criptate fără a le vedea sau a le folosi în mod abuziv.
Atunci când se aplică învățării federative, fuziunea actualizărilor modelului poate avea loc în siguranță, deoarece are loc într-un mediu complet criptat, reducând drastic riscul atacurilor de inferență a apartenenței.
Deceniul confidențialității
Pe măsură ce intrăm în 2021, învățarea mașinilor care păstrează confidențialitatea este un domeniu emergent cu o cercetare remarcabil de activă. Dacă ultimul deceniu a fost despre eliminarea barierelor pentru date, acest deceniu va fi despre eliminarea barierelor pentru modelele ML, păstrând în același timp confidențialitatea datelor subiacente prin învățarea federativă, confidențialitatea diferențială și criptarea omogetică. Acestea prezintă o nouă modalitate promițătoare de a avansa soluțiile de învățare a mașinilor într-un mod conștient de confidențialitate.


