
Fundamentele AI
Ce este Inteligența Artificială Generativă?

 Adaugă Unite.AI la sursele tale preferate pe Google
Inteligență artificială generativă se referă la modele care învață tiparele din date și produc texte noi, imagini, audio, video, cod sau alte reprezentări atunci când sunt condiționate prin instrucțiuni sau exemple. Ieșirea este sintetizată dintr-un model de probabilitate; nu este preluată intactă dintr-o bază de date, deși instrumentele de recuperare pot furniza dovezi externe.
Familii diferite de modele generează în moduri diferite. Transformatoarele autoregresive prezic o secvență token cu token, modelele de difuzie denoisează iterativ un eșantion, iar rețelele generative adversariale învață printr-un concurs între generator și discriminator.
Aspecte cheie
- Generarea este eșantionare condiționată dintr-o distribuție învățată, nu o reamintire factuală garantată.
- Transformatoarele, modelele de difuzie, GAN-urile și autoencoderele variationale fac compromisuri diferite.
- Recuperarea și instrumentele pot ancora sistemul, dar ieșirile și permisiunile lor necesită în continuare validare.
- Gestionarea riscurilor acoperă datele, modelul, interfața, implementarea, monitorizarea și proveniența conținutului.
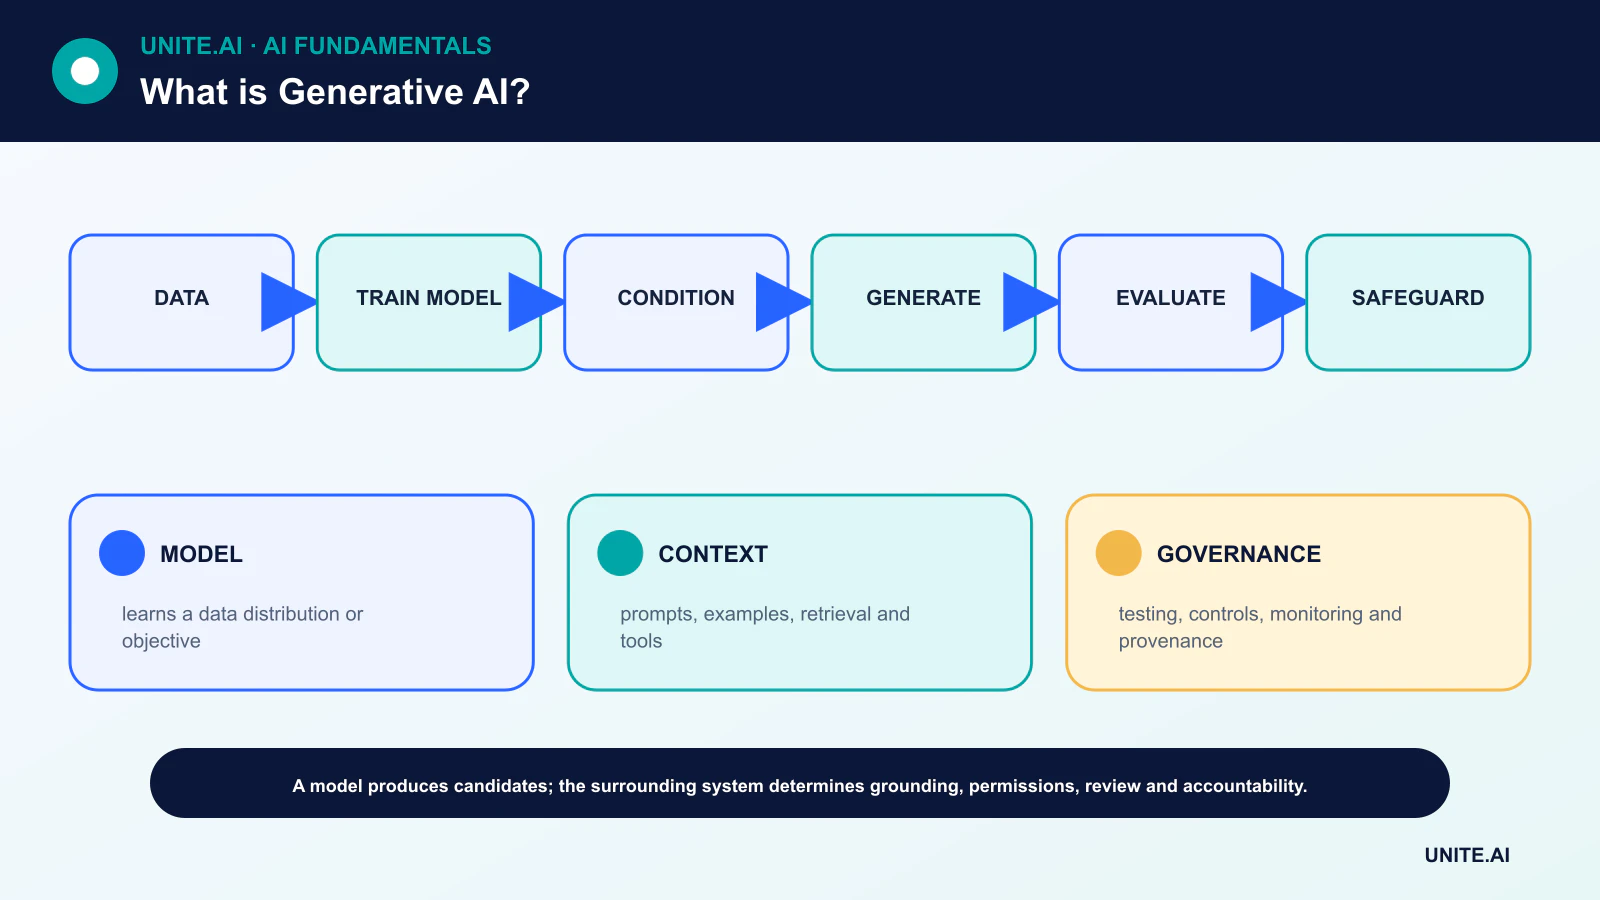
Cum învață modelele generative
Obiectivele de antrenament recompensează un model pentru prezicerea sau reconstrucția tiparelor din exemple. Un model lingvistic estimează tokenul următor; un model de difuzie învață să inverseze un proces de zgomot; un autoencoder varițional învață o distribuție latentă structurată și un decodor.
Acest antrenament creează generalizare statistică, dar poate reproduce și părtiniri, poate memora secvențe neobișnuite sau poate eșua în afara distribuției de date. Documentația setului de date, deduplicarea, controalele de confidențialitate și evaluarea pe date reținute sunt, prin urmare, esențiale înainte de implementare.
Principalele familii de arhitecturi
Transformatoarele autoregresive transformatoare domină textul și susțin secvențe multimodale. Modelele de difuzie sunt utilizate pe scară largă pentru generarea de imagini și audio de înaltă fidelitate. GAN-urile pot crea mostre clare și sisteme de imagini controlabile, dar pot fi dificil de antrenat.
Autoencoderele variationale oferă modelare cu variabile latente și reprezentări eficiente, servind uneori în interiorul unor conducte generative mai mari. Produsele reale combină adesea mai multe modele cu recuperare, filtre, instrumente și cod determinist.
Condționare, eșantionare și control
Un prompt, o etichetă de clasă, o imagine, un fragment audio sau o înregistrare structurată poate condiționa generarea. Parametrii de eșantionare alterează diversitatea și determinismul. O temperatură mai mică poate concentra probabilitățile tokenului, dar nu transformă un răspuns incorect în adevărat.
Controlul se îmbunătățește când sistemul folosește scheme explicite, decodare constrânsă, material de referință și validare. Ingineria prompturilor schimbă contextul; fine‑tuning‑ul modifică parametrii; recuperarea furnizează informații externe. Fiecare abordează un mod diferit de eșec.
Evaluarea este specifică aplicației
Sistemele de text pot necesita teste de factualitate, finalizare de sarcină, suport de citare, toxicitate și calibrări. Sistemele de imagine sau audio pot necesita fidelitate, aliniere semantică, diversitate, siguranță a identității și revizuire perceptuală. Combinați metrici automate cu evaluări umane reprezentative.
Construiți un set de evaluare versionat care să includă cazuri obișnuite, rare, adversariale și relevante din punct de vedere al politicilor. Monitorizați latența, costul și comportamentul de refuz, precum și calitatea ieșirii. O demonstrație selectată de creatorul său nu constituie dovadă de fiabilitate la nivel de populație.
Riscuri, măsuri de protecție și proveniență
Riscuri importante includ halucinații, injecție de prompt, conținut dăunător, impostură, utilizare nesigură a instrumentelor, scurgeri de confidențialitate, dispute de drepturi de autor, părtinire de automatizare și lanțuri de aprovizionare opace. Profilul IA Generativă al NIST organizează acțiunile pe guvernanță, proveniență a conținutului, testare pre‑implementare și divulgare a incidentelor.
Folosiți instrumente cu privilegii minime, controale de intrare/ieșire, revizuire umană pentru decizii consecvente, jurnalizare, rollback și raportare de către utilizatori. Filigranele sau acreditările de conținut pot adăuga semnale, dar niciun detector sau etichetă singulară nu stabilește adevărul. Fluxul de lucru media sintetică trebuie să păstreze contextul și responsabilitatea.
Familii de modele și mecanisme de generare
Modelele de IA generativă estimează sau învață un proces care poate produce texte noi, imagini, audio, video, cod sau date structurate. Modelele autoregresive prezic tokenul sau elementul următor; modelele de difuzie învață să inverseze un proces de zgomot; autoencoderele variationale învață variabile latente probabilistice; GAN-urile antrenează un generator împotriva unui discriminator. Sistemele multimodale leagă reprezentările între medii. Ieșirea este eșantionată din structura statistică învățată, condiționată de prompturi, context, instrumente sau alte intrări — nu este preluată ca un fapt garantat.
Modelele de bază sunt pre‑antrenate pe date largi și adaptate prin prompting, recuperare, fine‑tuning, optimizare de preferințe, rețele de control sau capete specifice sarcinii. Tokenizatoarele, encoder‑ele, decoder‑ele, spațiile latente și setările de eșantionare modelează rezultatele. Temperatura și filtrarea candidaților negociază determinismul și diversitatea. Prompturi mai lungi oferă context, dar pot intra în conflict, pot distrage sau pot conține instrucțiuni malițioase. Recuperarea poate ancora cunoștințe în schimbare, în timp ce codul determinist ar trebui să gestioneze calcule exacte și reguli.
Evaluare, proveniență și drepturi
Evaluați pe sarcină: corectitudine factuală și citare pentru răspunsuri, execuție și securitate pentru cod, fidelitate și diversitate pentru media, și rezultat uman pentru asistență creativă. Includeți refuz, calibrări, latență, cost, limbi, accesibilitate și teste adversariale. O ieșire fluentă sau fotorealistă poate fi greșită. Păstrați modelul, promptul, seed‑ul, dovezile sursă, apelurile de instrumente și post‑procesarea pentru reproductibilitate. Separați calitatea recuperării de generare astfel încât un răspuns lustruit să nu ascundă dovezi lipsă.
Antrenamentul și ieșirile ridică întrebări de drept de autor, licență, consimțământ, confidențialitate, publicitate și confidențialitate. Stabiliți proveniența și utilizarea permisă a datelor de intrare; împiedicați utilizatorii să expună secrete; testați memorarea; și oferiți procese de raportare și eliminare. Media sintetică ar trebui să poarte o proveniență durabilă sau divulgare acolo unde este fezabil, în special când poate fi confundată cu dovezi. Nu folosiți asemănarea, vocea sau stilul în moduri care încalcă drepturi sau induc în eroare.
Controale de implementare
Tratați ieșirea modelului ca intrare neverificată. Validați schemele, curățați codul și fișierele, izolați execuția, autorizați fiecare instrument extern, limitați costul și rata, și cereți confirmare pentru acțiuni consecvente. Monitorizați eșecuri, abuzuri, drift și corecții ale utilizatorilor, cu rollback și un fallback non‑generativ. Documentați utilizarea permisă și cea interzisă. IA generativă extinde interfața pentru crearea și transformarea informației, dar fiabilitatea și responsabilitatea provin din datele înconjurătoare, evaluare, securitate, proveniență și procesul decizional uman.
Exemplu practic: un asistent generativ pentru descrierea produselor
Un retailer permite editorilor să genereze descrieri preliminare doar din atributele de produs aprobate și ghidajul de brand. Promptul include fapte structurate, în timp ce recuperarea furnizează politica curentă. Ieșirea trebuie să respecte o schemă și este validată față de valorile sursă; dimensiuni nesusținute, afirmații de siguranță sau certificări duc la respingere. Evaluarea acoperă acuratețea factuală, stilul, duplicarea, calitatea multilingvă, accesibilitatea, latența și corecțiile editorului, comparativ cu șabloane și scriere manuală.
Editorii aprobă fiecare publicare și pot vedea câmpurile sursă. Modelul nu are capacitatea de a modifica prețul, stocul sau de a publica direct. Prompturile și datele de produs sunt protejate de injecție, iar notele confidențiale ale furnizorilor sunt excluse. Monitorizarea urmărește afirmații nesusținute, editări, reclamații, costuri și versiuni ale furnizorului. Textul generat este stocat cu proveniență. Sistemul economisește timp de redactare doar dacă corecțiile și revizuirea nu anulează beneficiul și adevărul produsului rămâne guvernat de date autoritare.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o linie de bază reproductibilă și un set de evaluare versionat înainte de ajustare. Testați cazuri obișnuite, condiții de frontieră, intrări defecte sau lipsă, schimbări de distribuție, întreruperi ale dependențelor, utilizări abuzive și grupurile sau mediile cele mai susceptibile de a fi sub‑servite. Măsurați calitatea sarcinii împreună cu calibrările sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, rollback și retragere. Folosiți o lansare etapizată, păstrați un fallback sigur și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrării, comportamentul ieșirii, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți praguri de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevalueați ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și retenție, și un punct clar la care să fie dezactivat sau înlocuit.
Întrebări frecvente
Este IA generativă aceeași cu un model lingvistic mare?
Nu. LLM‑urile reprezintă o clasă de modele generative. IA generativă include, de asemenea, sisteme de imagine, audio, video și date structurate construite cu diverse arhitecturi.
Un model copiază datele sale de antrenament?
De obicei sintetizează din tiparele învățate, dar poate apărea memorare și aproape‑duplicare. Riscurile de confidențialitate și proveniență trebuie evaluate, nu presupuse ca inexistent.
Referințe principale












