
Fundamentele AI
Ce este meta-învățarea?

 Adaugă Unite.AI la sursele tale preferate pe Google
Meta-învățarea antrenează un sistem pe o distribuție de sarcini astfel încât să poată să se adapteze la o sarcină nouă și înrudită folosind date sau calcul limitat. Este adesea rezumată ca „învățarea de a învăța”, dar obiectivul tehnic este mai precis: optimizarea învățăcelului astfel încât experiența acumulată din sarcinile anterioare să îmbunătățească adaptarea la una ulterioară.
Meta-învățarea se suprapune cu few-shot learning și transfer learning, dar termenii nu sunt interschimbabili. „Few-shot” descrie cantitatea de date țintă; „transfer” descrie reutilizarea; meta-învățarea face explicit ca adaptarea între sarcini să facă parte din antrenament.
Aspecte cheie
- Meta-antrenarea folosește multe sarcini, nu doar multe exemple independente.
- Un episod N-way K-shot conține N clase și K exemple de suport etichetate pentru fiecare clasă.
- Metodele bazate pe gradient, pe metrică, pe memorie și pe optimizatori învățați se adaptează în moduri diferite.
- Performanța depinde puternic de faptul dacă sarcinile de meta-antrenament seamănă cu sarcina țintă.
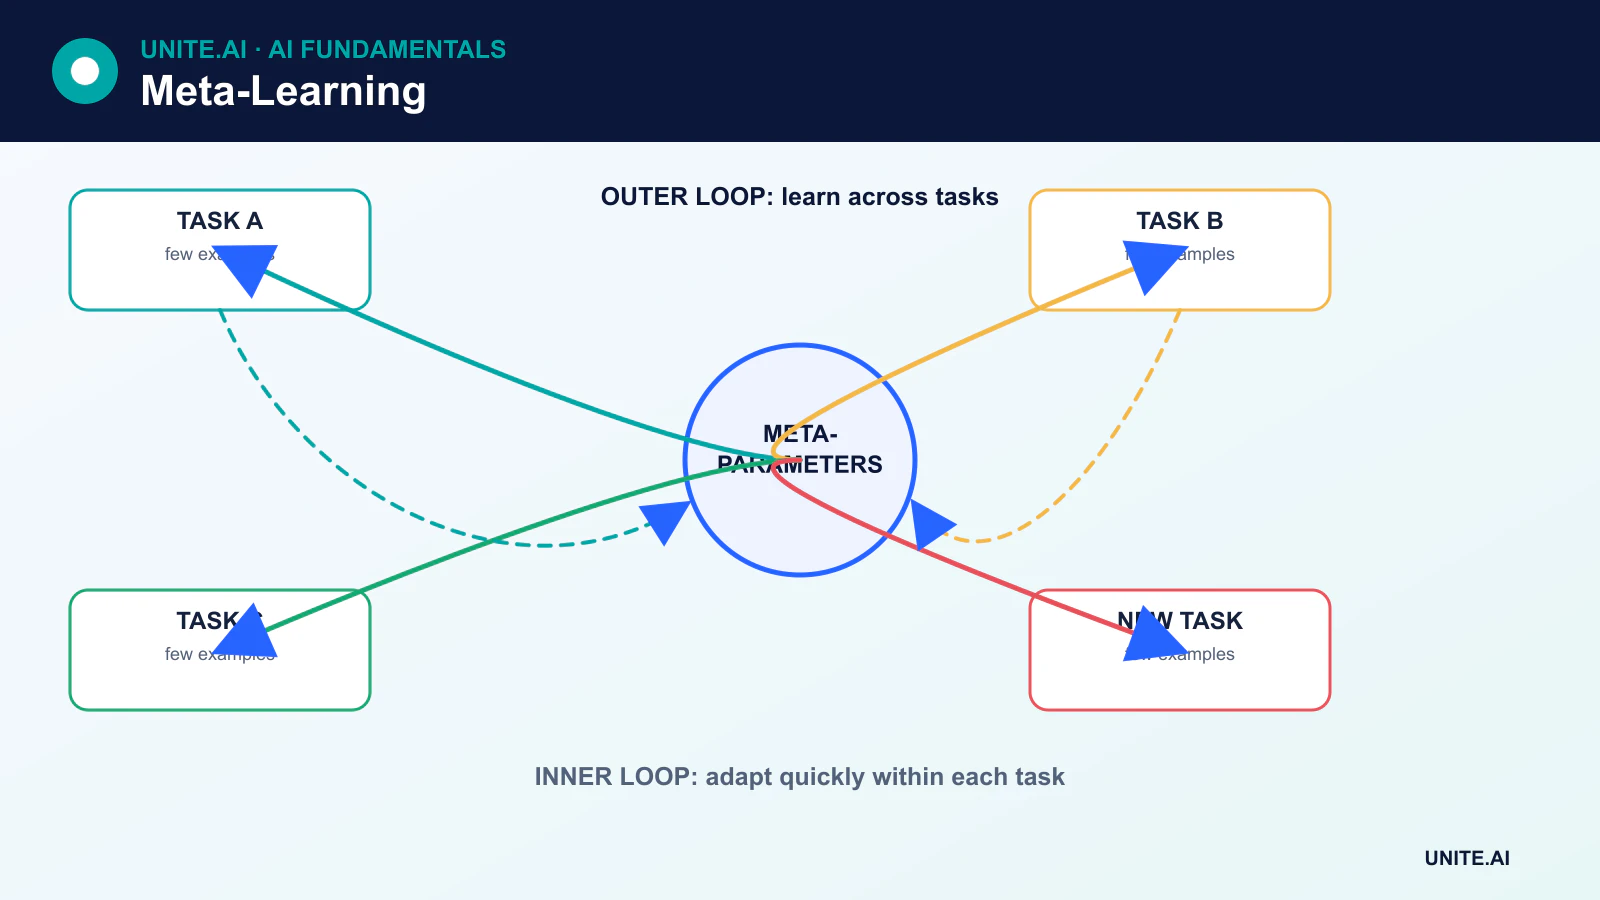
Sarcini, seturi de suport și seturi de interogare
Un set de date pentru meta-învățare este organizat ca un set de sarcini. În clasificarea cu puține exemple, un episod poate fi 5-way 1-shot: cinci clase, un exemplu de suport etichetat pentru fiecare clasă și exemple suplimentare de interogare utilizate pentru a evalua adaptarea. O sarcină 5-way 5-shot are cinci exemple de suport pentru fiecare dintre cele cinci clase – nu cinci exemple în total.
În timpul meta-antrenamentului, învățăcelul se adaptează repetat pe un set de suport și este evaluat pe un set de interogare. Obiectivul exterior îmbunătățește performanța viitoare a interogărilor pe parcursul sarcinilor. Meta-validarea ajustează alegerile pe sarcini separate, iar meta-testarea evaluează sarcini sau clase cu adevărat nevăzute.
Meta-învățarea bazată pe gradient
Meta-învățarea model-agnostică (MAML) învață o inițializare din care un număr mic de gradient pași produc o performanță bună pe o sarcină nouă. Bucla interioară adaptează parametrii modelului utilizând datele de suport. Bucla exterioară actualizează inițializarea comună folosind pierderea de interogare pe parcursul sarcinilor eșantionate.
MAML nu este limitat la clasificare; poate fi aplicat la regresie și la învățarea prin recompensă atunci când modelul și sarcina sunt diferențiabile. Reptile oferă o abordare de ordinul întâi mai simplă care mută parametrii către soluții adaptate sarcinii fără a calcula meta-gradientul complet al MAML.
Meta-învățarea bazată pe metrică
Metodele bazate pe metrică învață o încorporare în care exemplele din aceeași clasă sunt apropiate, iar clasele diferite sunt separate. O rețea prototipică mediază încorporările de suport pentru a forma un prototip pentru fiecare clasă, apoi clasifică interogările în funcție de distanța față de acele prototipuri.
Rețelele de tip Matching și Siamese utilizează mecanisme de similaritate conexe. Aceste metode nu verifică doar dacă un model „atinge o metrică țintă”; distanța învățată sau reprezentarea este în sine parte a procedurii de predicție.
Metode bazate pe memorie și optimizatori învățați
Sistemele bazate pe memorie folosesc stări recurente sau bazate pe atenție pentru a stoca informații despre sarcina curentă. Optimizatorii învățați primesc gradienti sau semnale de antrenament ca intrări și învață cum să actualizeze un alt model. Aceste metode pot descoperi reguli de adaptare, dar adaugă parametri, calcul și un nivel suplimentar de supraînvățare potențială.
Meta-învățarea și învățarea în context
Transformerele mari transformers pot adapta ieșirea lor din exemple furnizate într-un prompt fără a actualiza greutățile. Acest lucru se numește învățare în context. Se aseamănă cu comportamentul meta-învățării, iar datele de antrenament pot încuraja inferența sarcinii, dar un învățător în context nu este antrenat automat cu un obiectiv clasic episodic de meta-învățare.
Unde este utilă meta-învățarea
Aplicațiile potențiale includ personalizarea, robotică, recunoaștere cu resurse reduse, sarcini științifice cu puține măsurători și adaptarea rapidă la medii noi. Meta-învățarea este cea mai atractivă atunci când sunt disponibile multe sarcini sursă înrudite, dar datele pentru sarcina țintă sunt limitate.
Limitări
Meta-învățarea poate fi costisitoare din punct de vedere computațional deoarece antrenamentul imbracă adaptarea în interiorul optimizării. Rezultatele sunt sensibile la construcția sarcinilor, scurgerile dintre seturile de suport și interogare, arhitectură și schimbarea domeniului. Un model antrenat pe sarcini înguste și omogene poate să se adapteze slab în afara acelei distribuții.
Comparațiile ar trebui să includă învățarea prin transfer obișnuită și bazele multitask. O reprezentare pre-antrenată puternică urmată de ajustarea fină standard poate fi mai simplă și mai eficientă decât un algoritm dedicat de meta-învățare.
Sarcini, adaptare și structura de optimizare interioară‑exterioară
Meta-învățarea se antrenează pe o distribuție de sarcini astfel încât un învățăcel să poată să se adapteze la o sarcină nouă cu date sau actualizări limitate. Fiecare episod eșantionează o sarcină, împarte exemplele într-un set de suport utilizat pentru adaptare și un set de interogare utilizat pentru evaluare și actualizează cunoștințele comune între episoade. Metodele bazate pe metrică învață o încorporare și o regulă de comparare; metodele bazate pe optimizare învață inițializarea sau comportamentul de actualizare; metodele bazate pe memorie și model condiționează pe exemplele sarcinii. Distribuția sarcinilor este datele reale de antrenament și trebuie să semene cu problemele de adaptare viitoare.
În meta-învățarea model-agnostică, o buclă interioară adaptează parametrii pe exemplele de suport și o buclă exterioară optimizează performanța pe exemplele de interogare după adaptare. Gradientele de ordin superior pot fi costisitoare; aproximările de ordinul întâi fac compromisuri între fidelitate și cost. Rețelele prototipice reprezintă fiecare clasă printr-un centroid al setului de suport și clasifică prin distanță. Aceste metode presupun că geometria claselor, pașii de adaptare și construcția episodului reflectă implementarea. O metodă poate părea că învață rapid în timp ce exploatează etichete fixe, artefacte de achiziție sau suprapuneri între seturile de date sursă.
Evaluare, bază de referință și limitări în lumea reală
Separați sarcinile de antrenament, validare și test – nu doar exemple – pentru a măsura adaptarea la sarcini cu adevărat nevăzute. Raportați acuratețea sau pierderea în funcție de numărul de exemple și pașii de adaptare, intervalele de încredere între sarcini, calcul, memorie și sensibilitatea la compoziția setului de suport. Comparați cu învățarea prin transfer, ajustarea fină a unui model pre-antrenat, vecinii cei mai apropiați și un model antrenat în comun pe toate datele sursă. Multe câștiguri aparente ale meta-învățării se diminuează când bazele de referință primesc backbone-uri, augmentări și reglaje echivalente.
Implementările reale necesită o metodă de a recunoaște când o sarcină nouă se află în afara distribuției de meta-antrenament. Exemplele de suport slabe sau etichetate greșit pot provoca eșecuri rapide și sigure. Limitați magnitudinea actualizărilor, validați modelele adaptate, păstrați o soluție de rezervă și protejați datele de adaptare de otrăvire. Monitorizați modelul de bază, selectorul de sarcini, semințele episoadelor și codul de adaptare. Meta-învățarea este utilă pentru familii repetate de probleme cu date reduse, dar nu creează o capacitate generală de învățare din exemple arbitrare și nu elimină nevoia de evaluare specifică domeniului.
Exemplu practicat: adaptare cu puține exemple între mașini
Un producător tratează fiecare tip de mașină ca o sarcină și meta-antrenează o reprezentare a anomaliilor pe multe mașini cu rezultate de mentenanță verificate. Mașinile de testare sunt complet excluse din antrenamentul sarcinilor. Pentru o mașină nouă, un set mic de suport acoperă modurile de operare normale în loc de minute arbitrare de date. Meta-învățarea este comparată cu un encoder pre-antrenat înghețat, vecinii cei mai apropiați și ajustarea fină obișnuită utilizând aceleași exemple de suport și calcul.
Evaluarea repetă multe selecții de suport și raportează reamintirea evenimentelor, alarmele false, timpul de adaptare și variația. Sistemul se abține când setul de senzori sau dinamica mașinii noi se află în afara distribuției sarcinii. Actualizările de adaptare sunt limitate și revizuite înainte de a influența mentenanța. Etichetele de suport și identitatea mașinii sunt protejate de otrăvire, iar fiecare model adaptat păstrează versiunea și exemplele de bază. Adaptarea rapidă este acceptată numai dacă depășește constant transferul mai simplu în condiții de schimbare realistă a sarcinii.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație de succes. Definiți utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabiliți o bază reproducibilă și un set de evaluare versionat înainte de reglare. Testați cazurile obișnuite, condițiile de frontieră, intrările defecte sau lipsă, schimbarea distribuției, întreruperi ale dependențelor, utilizarea incorectă și grupurile sau mediile care ar putea fi subservite. Măsurați calitatea sarcinii împreună cu calibrul sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrați fiecare transformare și prag astfel încât un revizor independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuiți autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Utilizați o lansare în etape, păstrați o soluție de rezervă sigură și verificați monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definiți pragurile de alertă și un responsabil de răspuns, apoi revizuiți dovezile din lumea reală după implementare în loc să presupuneți că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware-ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar în care să fie dezactivat sau înlocuit.
Întrebări frecvente
Este prompting-ul cu puține exemple meta-învățare?
Prompting-ul cu puține exemple este o tehnică de adaptare în context. Poate afișa un comportament asociat cu învățarea pe parcursul sarcinilor, dar nu este antrenat automat cu episoade de suport/interogare sau cu o buclă explicită de meta-optimizare.
Care este cel mai mare risc al meta-învățării?
O neconcordanță între sarcinile de meta-antrenament și sarcina țintă poate face ca adaptarea rapidă să pară puternică într-un benchmark, dar să eșueze în implementare. Împărțirile sarcinilor și proveniența sursei trebuie auditate cu aceeași atenție ca împărțirile obișnuite de antrenament/test.
Referințe principale











