
Fundamentele AI
Ce este învățarea prin transfer?

 Adaugă Unite.AI la sursele tale preferate pe Google
Transfer learning reutilizează cunoștințele învățate pentru o problemă pentru a îmbunătăți învățarea pe o problemă înrudită. În loc să inițializeze fiecare parametru aleatoriu, practicianul pornește de la un model sau o reprezentare pre‑antrenată și o adaptează la sarcina țintă.
Această abordare este deosebit de utilă când setul de date țintă este mic, etichetarea este costisitoare sau pre‑antrenarea necesită mai multă putere de calcul decât echipa țintă poate justifica. Antrenarea unui model de la zero este alternativa la învățarea prin transfer — nu un tip de învățare prin transfer.
Aspecte cheie
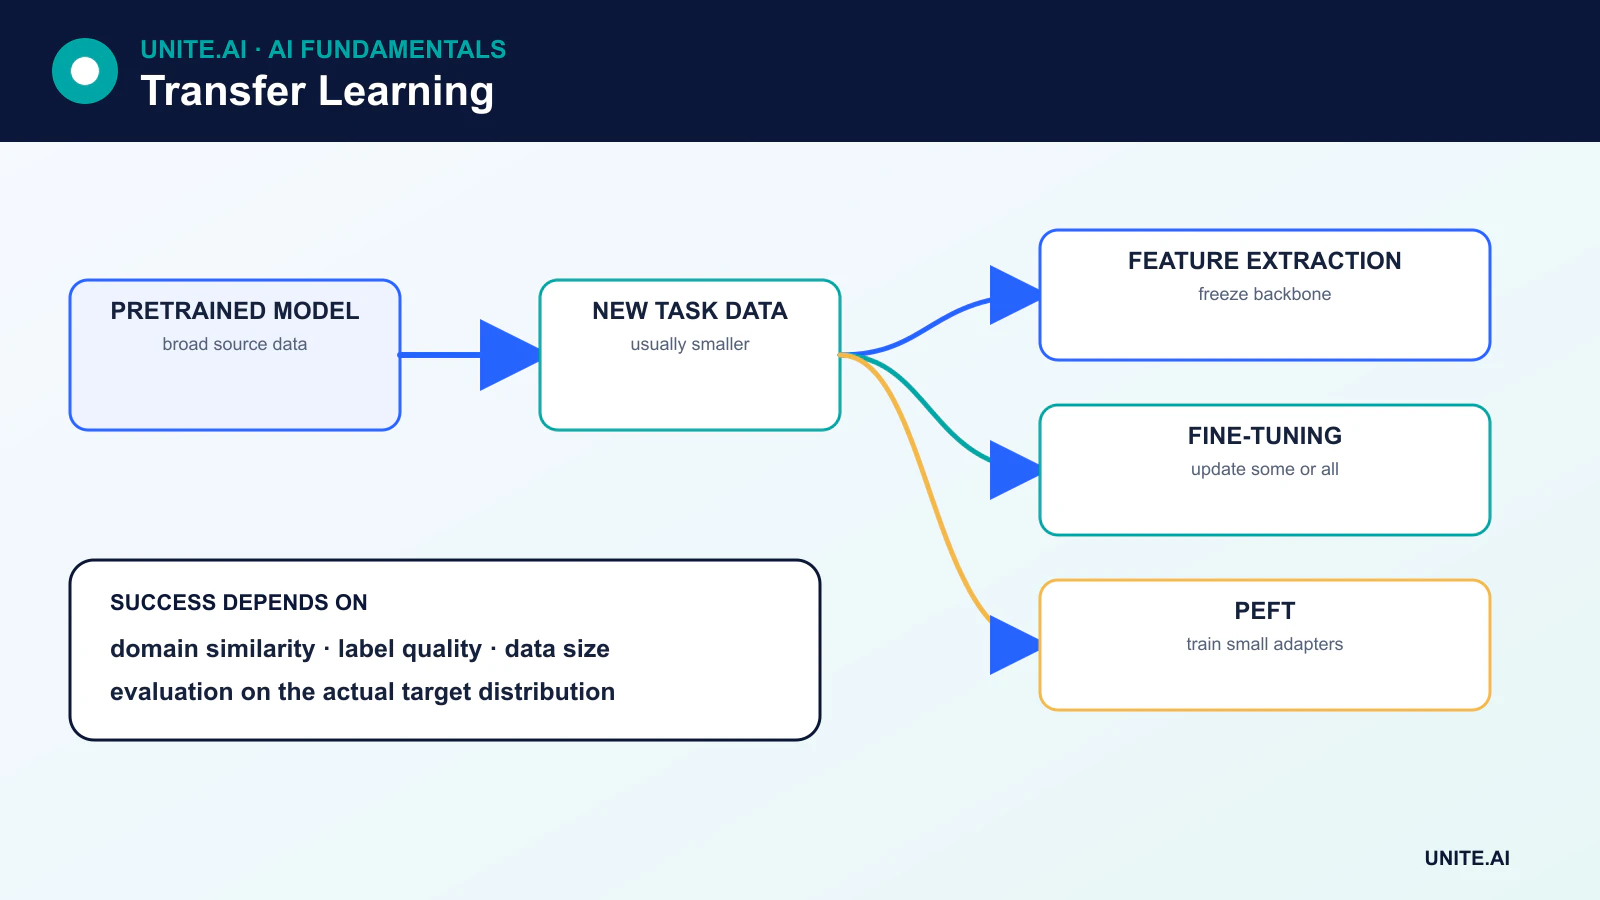
- Extracția de caracteristici păstrează baza pre‑antrenată înghețată și antrenează o nouă componentă specifică sarcinii.
- Ajustarea fină actualizează o parte sau toți parametrii pre‑antrenați utilizând date din domeniul țintă.
- Metodele eficiente din punct de vedere al parametrilor, cum ar fi adaptoarele și LoRA, actualizează o mică fracțiune a modelului.
- Transferul poate eșua când domeniile sursă și țintă diferă, licențele sunt în conflict sau modelul sursă conține un bias inadecvat.
De ce funcționează învățarea prin transfer
Modelele adesea învață reprezentări care sunt utile dincolo de datele exacte pe care au fost antrenate. Straturile timpurii ale unui model de imagini pot captura modele locale reutilizabile; un model de limbaj poate învăța sintaxa, semantica și asocieri largi din predicția auto‑supervizată. O sarcină țintă poate construi pe baza acestor reprezentări în loc să reînvețe totul din exemple limitate.
Beneficiul depinde de similaritatea dintre sarcinile sursă și țintă, de scară și calitatea pre‑antrenării și de modul în care modelul este adaptat. Reutilizarea nu este garantată: caracteristicile transferate pot fi irelevante sau chiar dăunătoare.
Extracția de caracteristici
În extracția de caracteristici, baza pre‑antrenată este înghețată, astfel încât parametrii săi nu se modifică. Ieșirea ei devine intrarea pentru un nou clasificator, regresor sau altă componentă specifică sarcinii. Doar noua componentă este antrenată.
Aceasta este rapidă și eficientă din punct de vedere al datelor și reduce riscul de a distruge reprezentările pre‑antrenate utile. De asemenea, poate sub‑antrena când domeniul țintă diferă semnificativ de pre‑antrenare. Straturi precum normalizarea batch necesită atenție specială, deoarece statisticile stocate și comportamentul de antrenament pot afecta adaptarea chiar și atunci când majoritatea greutăților sunt înghețate.
Ajustare fină
Fine-tuning actualizează parametrii pre‑antrenați pe datele țintă. Un flux de lucru comun este:
- Încarcă modelul pre‑antrenat și înlocuiește sau adaugă componenta de ieșire.
- Îngheață baza și antrenează noua componentă.
- Dezgheță straturile selectate — sau întregul model — și continuă cu o rată de învățare mai mică.
- Validează pentru supra‑antrenare, uitare și performanță în domeniul țintă.
Nu există o regulă universală că doar straturile finale ar trebui ajustate. Alegerea optimă depinde de arhitectură, dimensiunea datelor țintă, similaritatea domeniului, straturile de normalizare, memorie și calcul. Ajustarea fină completă poate oferi mai multă capacitate, dar necesită mai multe resurse și poate provoca uitare catastrofică.
Ajustare fină eficientă din punct de vedere al parametrilor
Transformerele mari transformers fac ajustarea fină completă costisitoare. Ajustarea fină eficientă din punct de vedere al parametrilor (PEFT) modifică sau adaugă un set mic de parametri, lăsând majoritatea modelului de bază înghețată.
- Adapters inserează module mici antrenabile în rețea.
- LoRA reprezintă actualizările de greutăți cu matrici de rang scăzut, reducând parametrii antrenabili și memoria optimizatorului.
- Prompt and prefix tuning învață intrări continue specifice sarcinii sau prefixe interne.
PEFT poate stoca multe adaptări de sarcini în jurul unui singur model de bază, deși servirea în inferență, compatibilitatea adaptoarelor și gestionarea greutăților îmbinate necesită în continuare o inginerie atentă.
Învățarea prin transfer între tipuri de date
Clasificatoarele de imagini încep de obicei de la modele pre‑antrenate pe seturi de date mari de imagini. Sistemele de limbaj pornesc de la un model de bază și îl adaptează prin ajustare fină supravegheată, optimizare a preferințelor, recuperare sau utilizare de instrumente. Modelele de vorbire, audio, proteine și multimodale urmează modele similare.
Transferul poate avea loc și fără a modifica modelul original. Un model înghețat poate produce încorporări pentru un clasificator ulterior, un sistem de căutare de similaritate vectorială sau o conductă de recuperare.
Schimbarea domeniului și transferul negativ
Domain shift apare când intrările țintă diferă de datele sursă. Un model de imagini medicale, de exemplu, poate întâlni echipamente, populații sau protocoale de achiziție absente din pre‑antrenare. Negative transfer înseamnă că reutilizarea face performanța țintă mai slabă decât o bază adecvată antrenată de la zero.
Echipele ar trebui să compare strategiile de adaptare, să evalueze subgrupuri semnificative și să păstreze un set de testare în domeniul țintă. Dacă sarcina sursă este slab potrivită, un model mai mic specific domeniului poate depăși un model general mai mare.
Licențiere, proveniență și securitate
Un model descărcabil nu este automat sigur pentru implementare. Revizuiește licența, utilizările permise, divulgările privind datele de antrenament, limitările cardului modelului și lanțul de dependențe. Modelele pot reproduce bias, pot memora date sensibile sau pot conține cod malițios serializat. Folosește formate de încredere, scanează artefactele și încarcă greutăți neîncredere într-un mediu izolat.
Când să folosești învățarea prin transfer
Învățarea prin transfer este o alegere solidă atunci când există un model pre‑antrenat relevant și datele țintă sunt limitate. Antrenarea de la zero poate fi preferabilă când domeniul este foarte specializat, licența este incompatibilă, dimensiunea modelului depășește limitele de implementare sau o sarcină simplă nu beneficiază de o reprezentare pre‑antrenată mare. Decizia ar trebui validată empiric, nu presupusă pe baza scară modelului.
Ce se transferă și cum să îl adaptezi
Învățarea prin transfer reutilizează reprezentările învățate pe o sarcină sau set de date sursă pentru o sarcină țintă. În domeniul vizual, caracteristicile timpurii captează adesea margini și texturi; în limbaj, modelele pre‑antrenate codifică modele statistice între tokeni și contexte. Transferul funcționează când reprezentările sursă conțin informații relevante pentru țintă, dar diferențele de domeniu, etichetă, modalitate și achiziție pot produce transfer negativ. Începe cu un punct de referință pre‑antrenat, verifică licența de antrenament și documentația, și compară-l cu antrenarea unui model mic specific țintei de la zero.
Extracția de caracteristici îngheață scheletul și antrenează o nouă componentă; ajustarea fină parțială dezgheță straturi selectate; ajustarea fină completă actualizează întregul model. Metodele eficiente din punct de vedere al parametrilor adaugă adaptoare sau actualizări de rang scăzut, reducând parametrii antrenabili, dar nu neapărat memoria de inferență. Folosește o rată de învățare mai mică pentru greutățile pre‑antrenate, păstrează comportamentul de normalizare și evită uitarea catastrofică cu programe, regularizare, repetiție sau actualizări restricționate acolo unde este necesar. Selectează puncte de control pe datele de validare țintă și testează mai multe seed‑uri deoarece seturile de date țintă mici produc o variabilitate ridicată.
Compromisuri privind datele, evaluarea și implementarea
Datele țintă ar trebui să reprezinte condițiile de implementare și subgrupurile importante, nu doar un eșantion etichetat convenabil. Împarte pe subiect, sursă, timp sau locație pentru a preveni ca exemplele înrudite să treacă între partiții. Testează atât în condiții din domeniu, cât și în condiții deplasate. Compară variantele înghețate, parțial ajustate și complet ajustate în ceea ce privește calitatea, calibrarea, costul de antrenament, latența și robustețea. O îmbunătățire a scorului mediu poate ascunde o pierdere la clase rare moștenite din bias‑ul sursei. Revizuiește exemplele de eșec pentru scurtături specifice sursei, lacune de vocabular sau diferențe de senzori.
Urmărește modelul de bază, greutățile, tokenizer‑ul sau preprocesarea, adaptorul, datele și licența ca un singur grafic de dependență. Modelele de bază găzduite pot schimba comportamentul; greutățile deschise pot introduce responsabilități legate de lanțul de aprovizionare și actualizări. Validează artefactul îmbinat sau exportat și scanează fișierele modelului din surse neîncredere. În producție, monitorizează deriva și performanța țintă și păstrează capacitatea de a reveni la versiunea de adaptare și la cea de bază. Transferul reduce cantitatea de date țintă necesare; nu elimină etichetarea, evaluarea, confidențialitatea sau expertiza de domeniu.
Exemplu practic: adaptarea unui model de vizual la o clinică nouă
O clinică adaptează un encoder de imagistică pre‑antrenat pentru a clasifica calitatea imaginii înainte de revizuirea diagnostică. Verifică licența modelului sursă și modalitatea vizată, colectează dispozitivele locale și condițiile de achiziție și împarte pe pacienți. Variantele de caracteristici înghețate, adaptor, ajustare parțială și ajustare completă sunt comparate cu un punct de referință local mic. Metriile includ recall‑ul clasei, calibrarea, comportamentul subgrupului, calculul și sensibilitatea la dispozitiv, locație și artefacte rare.
Modelul adaptat nu poate face un diagnostic și redirecționează imaginile cu încredere scăzută sau nesuportate către tehnicieni. Validarea exportului confirmă preprocesarea locală și echivalența numerică. Versiunile modelului, adaptorului, dispozitivului și setului de date sunt legate în înregistrare. Monitorizarea detectează scanere noi, schimbări de protocol și deriva de ieșire, în timp ce mostrele revizuite periodic estimează performanța reală. O actualizare a modelului sursă este tratată ca o nouă dependență care necesită validare; învățarea prin transfer nu justifică reutilizarea automată a dovezilor vechi.
Dovezi de implementare și pregătire operațională
O decizie de producție necesită mai mult decât o demonstrație reușită. Definește utilizatorii vizați, mediul de operare, intrările, ieșirile, dependențele, proprietarul și consecința fiecărui eșec important. Stabilește un punct de referință reproductibil și un set de evaluare versionat înainte de ajustare. Testează cazuri obișnuite, condiții limită, intrări defecte sau lipsă, schimbarea distribuției, întreruperea dependențelor, utilizarea greșită și grupurile sau mediile cel mai probabil neacoperite. Măsoară calitatea sarcinii împreună cu calibrarea sau incertitudinea, latența, debitul, costul resurselor, accesibilitatea, confidențialitatea și securitatea. Înregistrează fiecare transformare și prag astfel încât un evaluator independent să poată reproduce rezultatul și să distingă dovezile de un prototip atrăgător.
Înainte de lansare, atribuie autoritatea pentru eliberare, excepții, modificări, revenire și retragere. Folosește o implementare etapizată, păstrează o soluție de rezervă sigură și verifică monitorizarea cu eșecuri injectate deliberat. Telemetria operațională ar trebui să dezvăluie calitatea intrărilor, comportamentul ieșirilor, versiunea modelului sau a regulii, sănătatea dependențelor, intervențiile umane și rezultatele confirmate fără a colecta date sensibile inutile. Definește pragurile de alertă și un responsabil de răspuns, apoi revizuiește dovezile din lumea reală după implementare în loc să presupui că performanța offline va persista. Reevaluează ori de câte ori sursele de date, utilizatorii, modelele, furnizorii, politicile, hardware‑ul sau obiectivele se schimbă. Un sistem întreținut necesită, de asemenea, proceduri documentate de recuperare, învățare din incidente, ștergere și păstrare, și un punct clar la care să fie dezactivat sau înlocuit.
Referințe principale











