
Fundamentele AI
Ce este analiza de sentiment? Metode, utilizări și limitări

 Adaugă Unite.AI la sursele tale preferate pe Google
Analiza de sentiment evaluează limbajul evaluativ din texte, transcrieri de vorbire sau alte tipuri de conținut. Un sistem poate clasifica polaritatea ca pozitivă, negativă sau neutră; detecta opinii la nivel de aspect; estima intensitatea; sau identifica poziția față de o anumită afirmație.
Ținta trebuie definită cu atenție. Sentimentul nu este același cu emoția, intenția, toxicitatea, satisfacția sau adevărul. O propoziție pozitivă poate descrie un eveniment nociv în mod sarcastic, în timp ce o recenzie de produs negativă poate totuși recomanda produsul în ansamblu.
Aspecte cheie
- Definiți unitatea, ținta, etichetele și contextul înainte de a colecta exemple.
- Lexicourile sunt linii de bază transparente; modelele supravegheate și cele bazate pe transformere pot captura mai mult context, dar necesită date reprezentative.
- Negarea, sarcasmul, vocabularul de domeniu, textul multilingv și limitele aspectelor rămân dificile.
- Evaluează pe clasă, subgrup, domeniu și perioadă; include revizuirea umană pentru utilizări cu consecințe.
Nivele și ținte
Analiza la nivel de document produce o singură etichetă pentru întregul element. Analiza la nivel de propoziție separă afirmațiile, în timp ce analiza bazată pe aspect leagă sentimentul de o entitate sau atribut – de exemplu, pozitiv privind calitatea imaginii, dar negativ privind durata de viață a bateriei.
Poziția întreabă dacă vorbitorul susține o anumită propoziție, ceea ce poate diferi de tonul emoțional. Aceste distincții trebuie fixate în ghidul de adnotare înainte de a aplica metodele de clasificare a textului.
Lexicouri, modele clasice și transformere
Un lexic atribuie scoruri cuvintelor și le combină cu reguli pentru negație sau intensitate. Este interpretabil și ieftin, dar are dificultăți cu contextul. Modelele clasice supravegheate folosesc caracteristici de cuvânt sau n‑gram, în timp ce transformerele învață reprezentări contextuale și pot fi ajustate fin.
Promptarea few‑shot poate fi convenabilă, dar rezultatele depind de exemple și de formulare. Compară fiecare abordare complexă cu o linie de bază și folosește învățarea few‑shot doar cu un set de evaluare reținut, versionat.
Provocări de date și limbaj
Etichetele pot reflecta perspectiva adnotatorului mai degrabă decât un fapt obiectiv. Schimbarea de domeniu este severă: „imprevizibil” poate fi laude pentru un film și critică pentru un vehicul. Cod‑switching‑ul, dialectul, emoji‑urile, citatele și ironia complică semnalele la nivel de token.
Echilibrează clasele în mod intenționat și evită ca autori, produse sau conversații conexe să se scurgă între antrenament și testare. Un model care memorează un brand sau un vorbitor poate părea precis fără să învețe sentimentul.
Evaluare și utilizare responsabilă
Raportează precizia, recall‑ul, F1‑ul și o matrice de confuzie în loc de acuratețe singură. Analizează erorile pe aspect, lungime, dialect și timp și calibrează pragurile în funcție de costul operațional al fiecărei greșeli.
Trendurile agregate pot susține cercetarea sau trierea, dar inferențele despre starea unui individ sau deciziile de angajare, credit, sănătate sau aplicare a legii generează riscuri majore. Oferă incertitudine, contextul sursei, controale de confidențialitate și revizuire umană.
Adnotare și construcție de seturi de date
Redactaţi un ghid de adnotare cu entitatea ţintă, unitatea de analiză, definiţiile etichetelor, gestionarea mixtelor şi neutrelor, reguli de citare, politică de sarcasm şi exemple din domeniu. Pilotaţi cu mai mulţi adnotatori, calculaţi acordul, discutaţi neconcordanţele şi revizuiţi sarcina înainte de a scala etichetele.
Eşantionarea determină ce învață modelul. Un flux de social‑media poate suprareprezenta conturile foarte active; tichetele de suport pot omite clienţii mulțumiţi; rating‑urile stelare pot să nu corespundă textului recenziei. Păstraţi metadatele de sursă și timp, respectaţi termenii platformei și confidențialitatea și creaţi un set de testare din populaţia în care vor fi luate deciziile.
Scurgerea etichetelor poate apărea prin ratinguri, emoji‑uri inserate de sistemul de colectare, semnături şablonate sau nume de produse corelate cu sentimentul. Deduplificaţi postările aproape identice și grupaţi conversațiile sau autorii astfel încât limbajul lor să nu apară în ambele părţi ale unei partiții.
Alegerea modelelor și calibrare
Sistemele bazate pe lexicouri însumează scorurile cuvintelor și ajustează pentru negație, intensificatori, punctuație sau emoji‑uri. Ele oferă un control de sănătate util și pot fi adaptate cu termeni de domeniu. Modelele liniare cu caracteristici TF‑IDF rămân competitive pe unele seturi de date și expun n‑gramurile influente.
Codificatoarele contextuale reprezintă cuvintele în funcție de textul înconjurător și pot fi ajustate fin pentru polaritate sau aspecte. Documentele lungi pot necesita modele ierarhice, agregare de propoziții sau recuperare de fragmente relevante. Abordările multilingve pot antrena un model partajat, pot traduce într‑o limbă pivot sau pot menține modele locale; fiecare are acoperire și compromisuri culturale.
Calibrarea probabilităților este importantă când scorurile declanșează acțiuni. Graficele de fiabilitate și eroarea de calibrare așteptată dezvăluie dacă o încredere raportată de 0.8 corespunde la aproximativ 80% corectitudine. Pragurile pot crea o bandă de abstinență pentru revizuire umană, iar praguri separate pot fi justificate când costurile erorilor diferă — nu pentru a ascunde o calitate inegală.
Aplicații și interpretări greșite comune
Sentimentul agregat poate ajuta la prioritizarea temelor, compararea reacțiilor la campanii sau direcționarea mesajelor de serviciu urgente. Analiza aspectelor este adesea mai acționabilă decât polaritatea generală, deoarece identifică ce discută oamenii. Analiza tendințelor necesită eșantionare stabilă și definiții de etichete pe parcursul timpului.
Nu echivalaţi prevalența postărilor negative cu opinia populației. Comportamentul de postare, boții, moderarea, demografia platformei, campaniile și interogările de colectare modelează eșantionul. Un model de sentiment nu măsoară populația tăcută, iar o schimbare de formulare poate părea o schimbare de atitudine.
Pentru decizii individuale, etichetele false pot fi stigmatizante și greu de contestat. Evitaţi utilizarea sentimentului ca proxy pentru implicarea angajaților, sănătatea mentală, solvabilitatea, intenția sau înșelăciunea. Când oamenii sunt afectaţi, arătaţi contextul sursei, permiteţi corecţia și solicitaţi un decident uman cu discreție reală.
Exemplu practic: analiză de sentiment pentru feedback-ul clienţilor
O companie care analizează comentariile de suport ar trebui să definească dacă are nevoie de sentiment la nivel de document, sentiment pe aspect, emoție, urgență sau clasificare a problemei. „Livrarea a fost rapidă, dar produsul s‑a stricat” nu poate fi reprezentat fidel printr‑o singură etichetă pozitiv‑negativă. Creaţi un ghid de adnotare pentru ținte, negație, sarcasm, declarații mixte, citate și cazuri necunoscute, apoi măsuraţi acordul înainte de a trata etichetele ca adevăr de bază.
Comparaţi un lexic sau o linie de bază liniară cu un codificator ajustat fin sau cu un model de limbaj promptat. Împărţiţi datele pe timp sau client pentru a preveni scurgerea de duplicate aproape identice și păstraţi prevalenţa claselor. Raportaţi precizia, recall‑ul, F1‑ul, calibrarea și confuzia pe limbă, canal, produs și proxy‑uri demografice numai acolo unde este legal și justificat. Revizuiţi erorile cu încredere mare, deoarece acestea sunt mai periculoase în rutarea automată decât ieșirile nesigure care sunt escaladate.
Folosiţi sentimentul ca un semnal pentru agregare sau prioritizare, nu ca o măsură incontestabilă a stării unei persoane. Monitorizaţi vocabularul și driftul de produs, reantrenaţi cu exemple revizuite și permiteţi agenţilor să corecteze etichetele. Nu inferaţi trăsături protejate sau nu disciplinaţi lucrătorii pe baza scorurilor de sentiment nevalidat. Pentru rapoartele executive, arătaţi dimensiunea eșantionului, incertitudinea, datele lipsă și temele care generează schimbarea, astfel încât un scor fluctuant să conducă la investigație, nu la o concluzie simplistă.
Implementarea multilingvă nu ar trebui să presupună că traducerea intrărilor păstrează tonul, negația, expresiile idiomatice sau convențiile culturale. Validaţi fiecare limbă suportată și tiparele mixte cu recenzenţi nativi și furnizaţi un rezultat necunoscut când dovezile sunt slabe. Adaptarea la domeniu contează de asemenea: cuvintele care sună negative în conversaţia obișnuită pot fi descrieri tehnice neutre. Menţineţi praguri sau modele separate doar când dovezile operaționale justifică complexitatea și povara de guvernanță adăugată.
Checklist de implementare practică
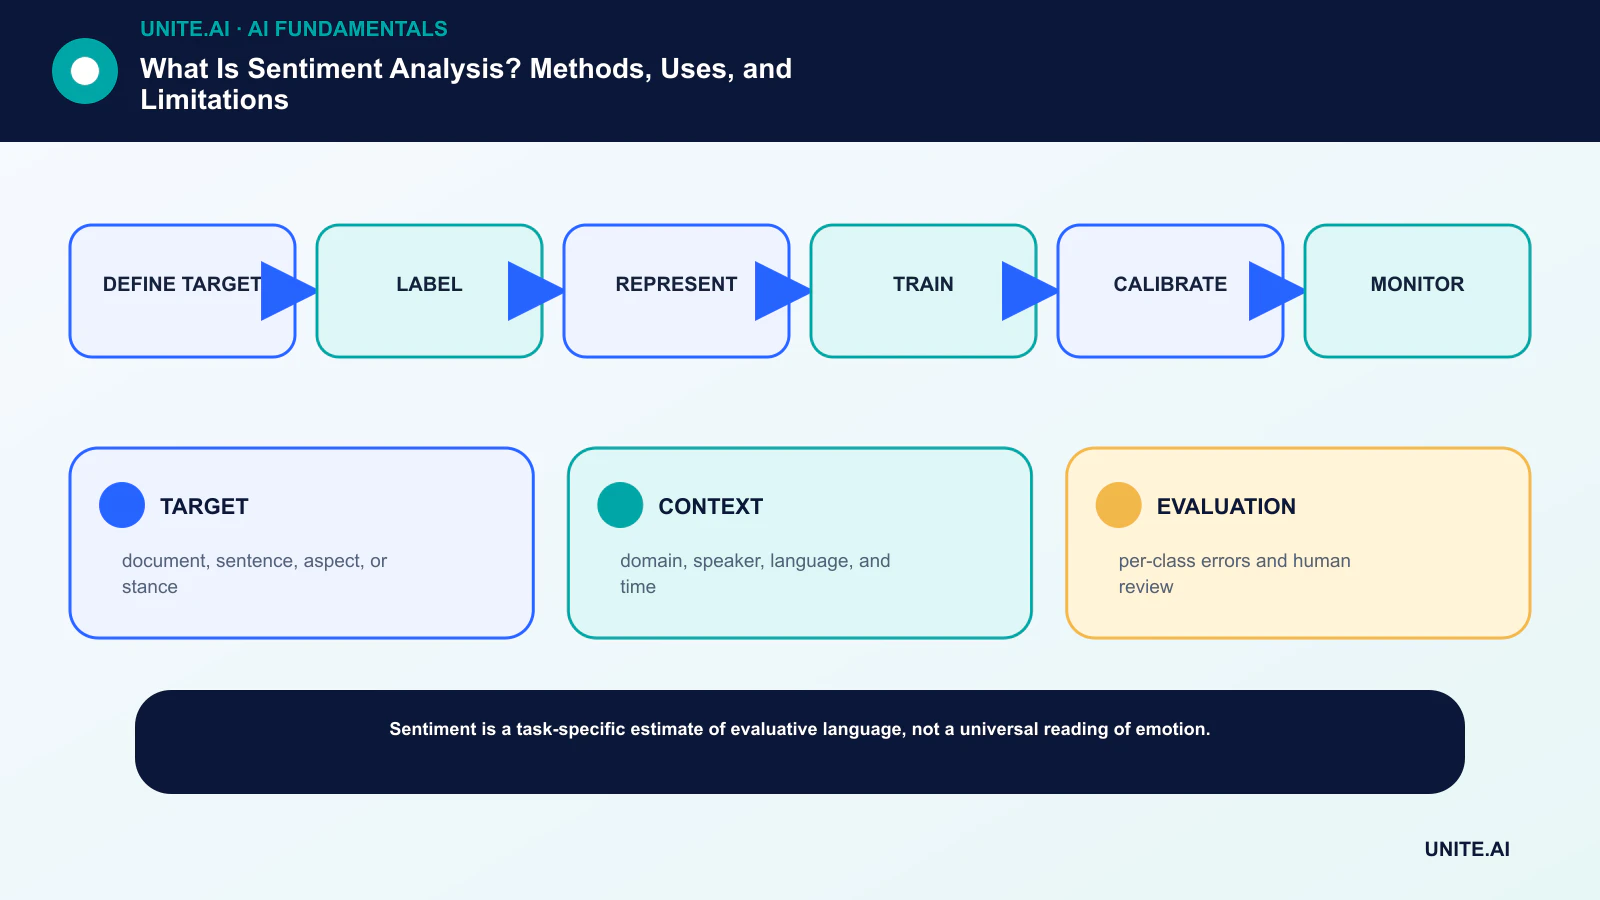
Transformaţi conceptul într-un flux de lucru delimitat și testabil: definiţi ţinta → etichetă → reprezentare → antrenare → calibrare → monitorizare. Stabiliţi un responsabil, documentaţi datele și dependenţele, creaţi o linie de bază simplă, definiţi criterii de acceptare și oprire, testaţi eșecuri reprezentative și definiţi monitorizarea, rollback‑ul și revizuirea înainte de a extinde domeniul. Înregistraţi versiuni și presupuneri pentru ca o altă echipă să poată reproduce rezultatul și să înţeleagă ce s‑a schimbat.
Înainte de lansare, efectuaţi o revizuire de pregătire documentată cu persoanele care construiesc, operează, securizează și sunt afectate de sistem. Testaţi cazuri normale, condiţii de frontieră, eșecuri de dependență și utilizări abuzive; păstraţi dovezile și riscurile nerezolvate. Definiţi cine poate aproba lansarea, modifica un prag, anula un rezultat sau opri funcţionarea. Revedeaţi decizia după ce apar date din lumea reală, deoarece un pilot tehnic de succes nu garantează performanță fiabilă la scară mai largă.
- ŢINTĂ: document, propoziție, aspect sau poziție.
- CONTEXT: domeniu, vorbitor, limbă și timp.
- EVALUARE: erori pe clasă și revizuire umană.
Întrebări frecvente
Este analiza de sentiment obiectivă?
Nu. Ea estimează etichete definite de o sarcină și de procesul de adnotare. Unele texte sunt cu adevărat ambigue, mixte, dependente de context sau interpretate diferit de cititori.
Poate analiza de sentiment să detecteze sarcasmul?
Modelele pot învăța unele tipare, dar sarcasmul depinde adesea de istoricul vorbitorului, cunoștințele comune și contextul din afara textului. Rămâne o modalitate comună de eșec.
Referințe principale












