Grunnleggende AI
Hva er maskinlæring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
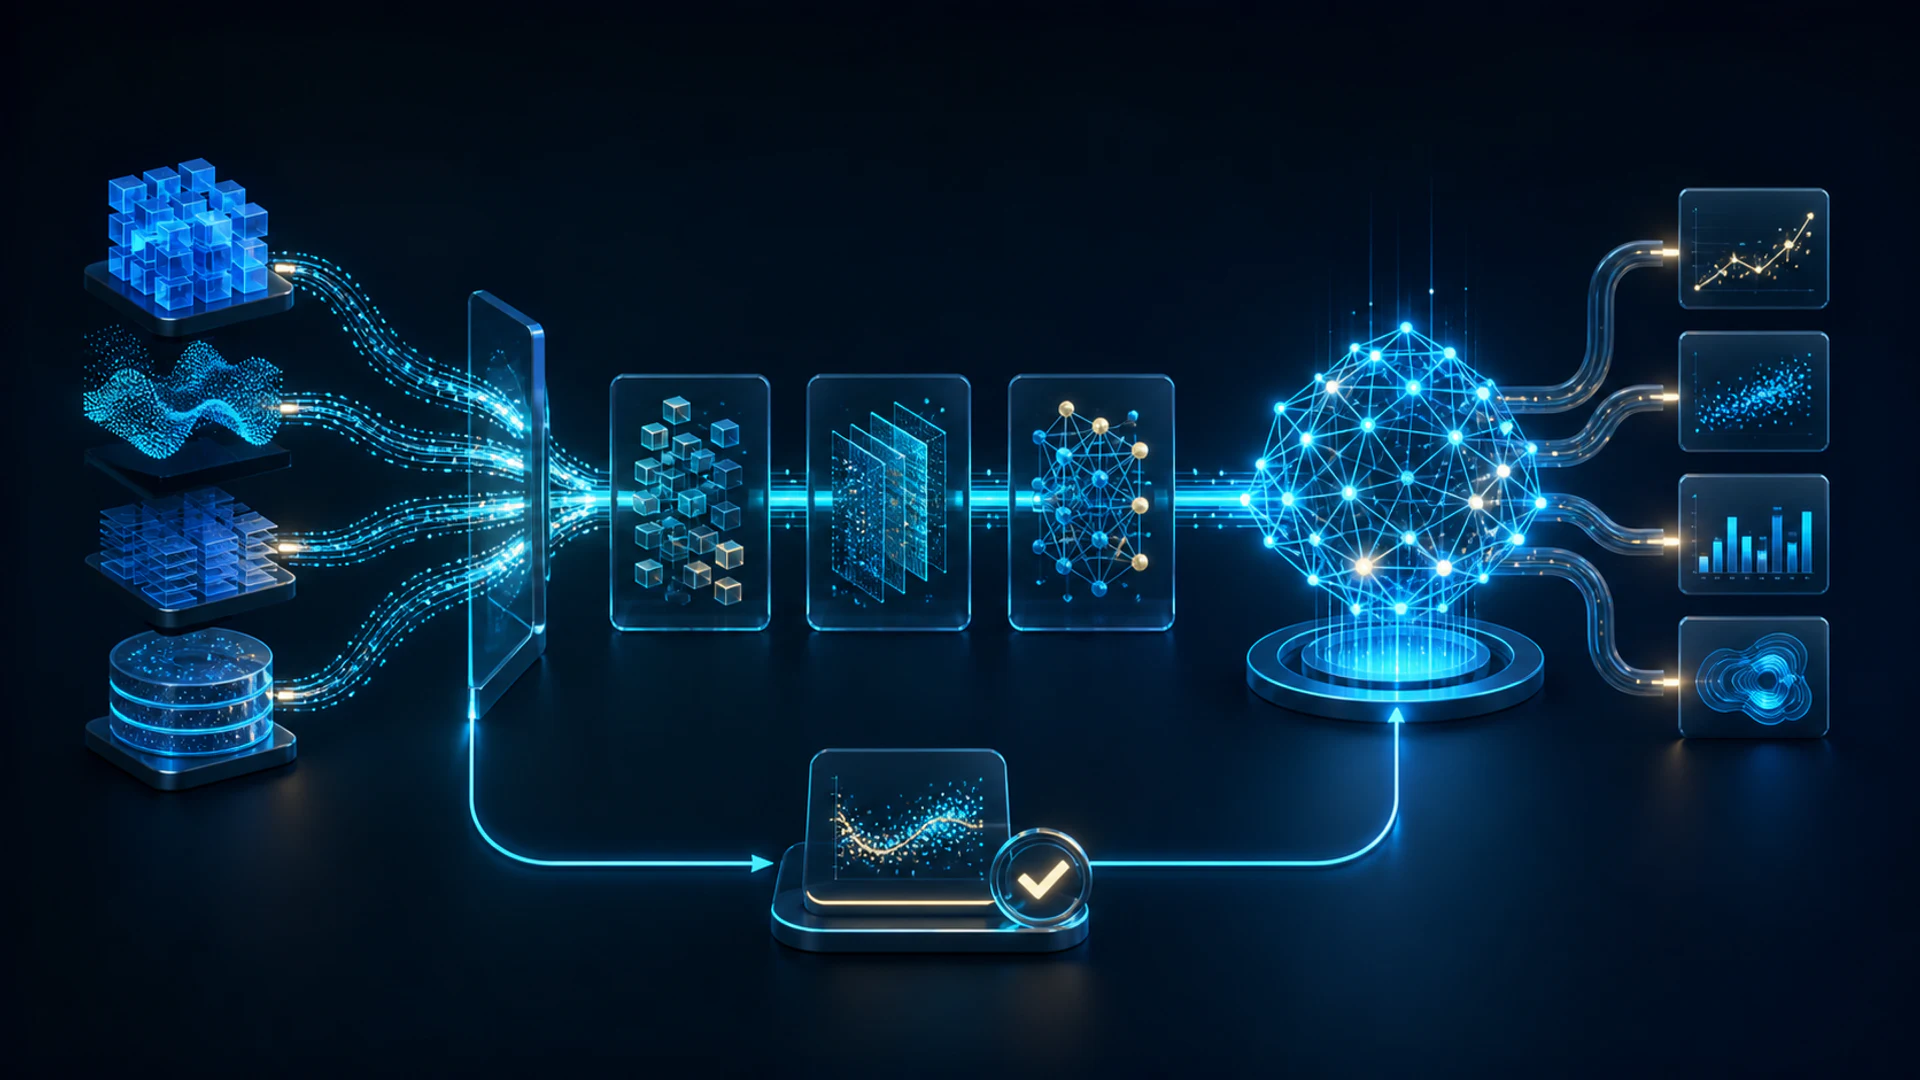
Maskinlæring (ML) er en gren av kunstig intelligens der et system lærer mønstre fra data slik at det kan gjøre prediksjoner, klassifiseringer, anbefalinger eller beslutninger uten at en utvikler må skrive en egen regel for hvert mulig tilfelle. Resultatet er ikke en maskin som “tenker” som et menneske. Det er en statistisk modell som kartlegger innganger til nyttige utganger og kan evalueres på data den ikke har sett under trening.
Maskinlæring er en del av det bredere feltet AI, mens deep learning er en familie av maskinlæringsmetoder bygget rundt flerlags nevrale nettverk. Denne distinksjonen er viktig: ikke alle AI‑systemer bruker ML, og ikke alle ML‑problemer krever et nevralt nettverk.
Nøkkelpunkter
- ML lærer en relasjon fra eksempler i stedet for kun å stole på håndskrevne regler.
- En nyttig modell må generalisere til nye data, ikke bare memorere treningssettet.
- Overvåket, uovervåket, semi‑overvåket, selv‑overvåket og forsterkningslæring løser forskjellige typer problemer.
- Datakvalitet, evalueringsdesign og overvåking er like viktige som algoritmen.
Hvordan maskinlæring fungerer
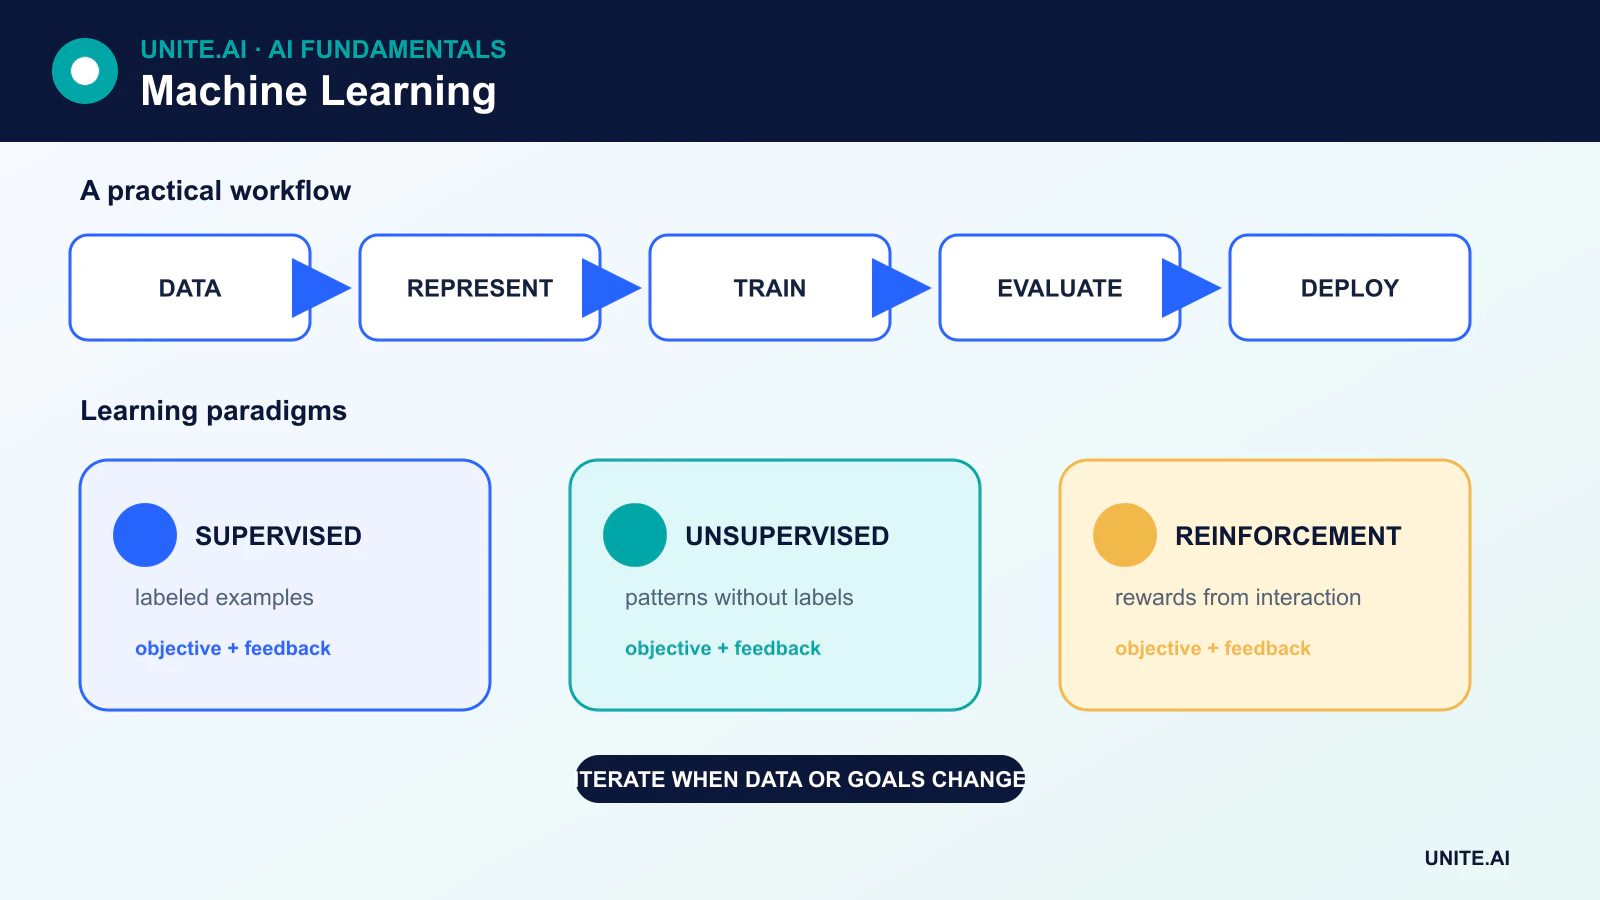
De fleste ML‑prosjekter kan forstås som en sekvens av seks trinn:
- Definer oppgaven. Bestem hva systemet skal forutsi eller oppdage, og hva suksess betyr i den faktiske anvendelsen.
- Samle inn og forberede data. Rengjør poster, håndter manglende verdier, lag nyttige funksjoner, og dokumenter hvor dataene kommer fra.
- Del opp dataene. Et treningssett brukes til å tilpasse modellen, et valideringssett hjelper med å velge innstillinger, og et testsett gir et endelig estimat på urørte data.
- Tren modellen. En algoritme justerer modellparametere for å redusere en tapsfunksjon eller oppfylle et annet læringsmål.
- Evaluer generalisering. Metrikker må gjenspeile oppgaven, klassebalanse, feilkostnader og populasjonen modellen skal operere på.
- Distribuer og overvåk. Virkelige data kan endre seg, så teamene følger med på driftsavdrift, ytelsesnedgang, skjevhet og driftsfeil.
Variablene som leveres til en modell kalles vanligvis features. I overvåket læring kalles ønsket svar label eller target. En modells lærte parametere kodar en relasjon mellom funksjonene og utgangen; de er ikke en database med eksplisitte regler.
De viktigste læringsparadigmene
Overvåket læring
I overvåket læring inneholder eksemplene både innganger og kjente mål. En klassifiseringsmodell forutsier kategorier, for eksempel om en transaksjon er svindel. En regresjonsmodell forutsier en kontinuerlig verdi, som forventet energibehov.
Vanlige overvåkede algoritmer inkluderer decision trees, support vector machines, K-nearest neighbors, lineær og logistisk regresjon, gradient‑boostede trær, og neural networks. En klassifiseringsterskel som 0,5 er en beslutning valgt etter at en modell har produsert en poengsum eller sannsynlighet; den er ikke en uforanderlig egenskap ved logistisk regresjon.
Uovervåket læring
Uovervåket læring arbeider med data som ikke inneholder mål‑etiketter. Målet kan være å finne klynger, oppdage uvanlige observasjoner, estimere en fordeling, eller lage en lavdimensjonal representasjon. En klynge er en gruppe foreslått av en likhetsregel; den er ikke automatisk en meningsfull virkelighetsklasse.
Eksempler inkluderer K-means clustering, principal component analysis, density estimation, og noen former for autoencoders. En autoencoder lærer å rekonstruere sitt input gjennom en komprimert representasjon. Den lager ikke automatisk sannhets‑etiketter.
Semi‑overvåket og selv‑overvåket læring
Semi‑overvåket læring kombinerer et lite merket datasett med et større umerket datasett. Selv‑overvåket læring skaper et treningssignal fra dataene selv—for eksempel ved å forutsi maskerte ord eller matche to transformerede visninger av samme bilde. Selv‑overvåkning er sentral i mange moderne transformer og grunnmodell‑pipelines fordi den kan bruke store samlinger av tekst, bilder, lyd eller video uten at en person merker hvert eksempel.
Forsterkningslæring
I forsterkningslæring tar en agent handlinger i et miljø og mottar belønninger eller kostnader. Målet er å lære en policy som maksimerer forventet kumulativ belønning. Dette skiller seg fra overvåket læring fordi den korrekte handlingen ikke gis for hver tilstand, og en handling kan påvirke hvilke data agenten møter neste.
Trening, validering og generalisering
En modell som presterer godt på sine trenings‑eksempler kan fortsatt feile på nye data. Denne feilen kalles overtilpasning (overfitting). Team reduserer den gjennom passende modellkapasitet, regularisering, kryss‑validering, data‑augmentering, forebygging av lekkasje, og et virkelig uavhengig testsett.
Det finnes ingen enkelt metrikk for alle ML‑oppgaver. Klassifisering kan kreve presisjon, tilbakekalling, F1, kalibrering, eller en kostnadsvektet måling i stedet for rå nøyaktighet. Regresjon kan bruke gjennomsnittlig absolutt feil, rot‑gjennomsnittlig kvadratisk feil, eller et domene‑spesifikt tap. Klynging trenger ulike former for intern eller ekstern validert evaluering. Metrikken bør gjenspeile hva en feil betyr for brukeren eller organisasjonen.
Maskinlæringsalgoritmer er verktøy, ikke garantier
En algoritme bærer med seg antakelser. Lineære modeller antar en bestemt form for relasjon. K‑nærmeste naboer antar at den valgte avstanden representerer meningsfull likhet. Naiv Bayes antar at funksjonene er betinget uavhengige gitt klassen. Beslutningstrær deler funksjonsrommet ved hjelp av lærte splitt‑regler; bladene deres inneholder prediksjoner basert på grupper av treningsobservasjoner snarere enn nødvendigvis én observasjon hver.
Modellvalg avhenger derfor av datastørrelse, funksjonstyper, krav til latenstid, behov for tolkbarhet, og kostnaden ved feil. En enklere modell kan overgå en større modell når data er begrenset eller driftsbegrensninger favoriserer hastighet og åpenhet.
Hvor maskinlæring brukes
ML støtter søke‑ranking, anbefalinger, prognoser, avviksdeteksjon, oversettelse, talegjenkjenning, datamaskinsyn, prediktivt vedlikehold, svindeldeteksjon og vitenskapelig analyse. De samme teknikkene kan også forsterke historisk skjevhet, avsløre sensitiv informasjon, eller oppføre seg uforutsigbart ved distribusjonsendring. Ansvarlig distribusjon krever dokumentasjon, menneskelig tilsyn der det er hensiktsmessig, sikkerhetstesting og kontinuerlig overvåking.
Fra problemdefinisjon til et gyldig maskinlærings‑eksperiment
Et maskinlæringsprosjekt bør starte med en beslutning og et målbare resultat, ikke med en algoritme. Definer prediksjonsenheten, målet, observasjonstidspunktet, beslutningstidspunktet, tilgjengelige funksjoner, og kostnaden for hver feil. For en churn‑modell, for eksempel, vil bruk av hendelser registrert etter kansellering lekke svaret. Etabler en enkel regel eller statistisk basislinje, og del deretter data etter tid, kunde, sted eller en annen grense som reflekterer distribusjon. Tilfeldige rad‑splittelser kan plassere nesten identiske observasjoner i trenings‑ og testsett og gi en misvisende score.
Funksjons‑engineering konverterer rå poster til representasjoner modellen kan bruke, men hver funksjon trenger opprinnelse og en tilgjengelighetsgaranti. Tilpass normalisering, vokabular, imputasjon og dimensjonsreduksjon kun på treningsdata, og anvend deretter den lærte transformasjonen på validerings‑ og testdata. Kryss‑validering estimerer variasjon på tvers av prøver; et endelig urørt testsett støtter utgivelsesbeslutningen. Velg metrikker basert på konsekvenser: presisjon og tilbakekalling for ulik klassifiseringsfeil, kalibrering når sannsynligheter styrer handling, og kostnads‑ eller nyttevektede mål når feil har ulike operasjonelle effekter.
Distribusjon, overvåking og ansvarlig drift
Produksjons‑inferenz gjentar den komplette transformasjonen fra treningstid og returnerer en prediksjon innenfor krav til latenstid, gjennomstrømning og tilgjengelighet. Pakke forhåndsprosessering med modellen, valider inndata‑skjemaer, versjoner artefakter, og sammenlign resultater mellom offline‑ og tjeneste‑implementasjoner. Velg en terskel basert på driftskapasitet og feil‑avveining i stedet for standard 0,5. Rull ut gjennom skygge‑evaluering, en begrenset kohort, eller et eksperiment med sikkerhets‑metrikker. Hold en deterministisk fallback og en tilbake‑rull‑vei for avhengighets‑feil eller uakseptabel oppførsel.
Overvåk inndata‑kvalitet, funksjons‑drift, prediksjonsfordeling, kalibrering, undergruppe‑resultater, latenstid, kostnad, og bekreftede etiketter når de til slutt kommer. Drift er et signal for undersøkelse, ikke automatisk bevis på at ny‑trening vil hjelpe. Ny‑trening krever gjennomgåtte data, repeterbare tester, godkjenning, og sammenligning med den nåværende beste modellen. Dokumenter tiltenkte og ugyldige bruksområder, datarettigheter, personvern, sikkerhet, menneskelig overstyring, og klageprosesser der mennesker påvirkes. Maskinlæring er et vedlikeholdt beslutningssystem; modellfilen er kun én utskiftbar komponent.
Arbeidseksempel: forutsi utstyrs‑svikt
En produsent definerer én prediksjon per maskin‑dag: om en verifisert svikt vil inntreffe innen syv dager ved kun å bruke telemetri tilgjengelig ved starten av den dagen. Den deler etter maskin og tid, sammenligner med alders‑ og terskel‑baserte regler, tilpasser forhåndsprosessering på treningsdata, og evaluerer hendelses‑tilbakekalling, falske varsler, varslingens ledetid, kalibrering og vedlikeholdskapasitet. Sensor‑utskifting og planlagte nedstengninger modelleres som driftskontekst snarere enn som vanlige observasjoner.
Modellen kjøres først i skygge‑modus. Varsler viser bidragende telemetri og usikkerhet, men vedlikeholdere bestemmer om de skal inspisere. Funna og bekreftede årsaker blir styrte etiketter; fravær av en arbeidsordre antas ikke å bety ingen svikt. En trinnvis utrulling bruker varsel‑grenser og en manuell fallback, mens overvåkning sporer sensorhelse, inndata‑drift, gjennomgått presisjon, nedetid, og unødvendig vedlikehold. Ny‑trening skjer kun etter at data‑ og terskel‑gjennomgang viser en sannsynlig forbedring over det nåværende distribuerte systemet.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier, og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende inndata, distribusjonsendring, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latenstid, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbake‑rulling og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelig overstyring, og bekreftede resultater uten å samle unødvendige sensitive data. Definer varsel‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og lagrings‑prosedyrer, og et klart punkt hvor det skal deaktiveres eller erstattes.
Primære referanser