
Grunnleggende AI
Hva er overfitting?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Overfitting oppstår når en modell fanger mønstre eller støy som fungerer usedvanlig bra på treningsdataene, men som ikke generaliserer til nye eksempler. En overtilpasset modell kan ha svært lav treningsfeil, mens validerings‑ eller virkelighetsytelse er betydelig dårligere.
Det motsatte problemet er underfitting: modellen eller treningsprosessen kan ikke fange nok av signalet selv på treningssettet. God modellering balanserer tilpasning med generalisering i stedet for å jakte på perfekt treningsytelse.
Viktige poeng
- Treningsytelse alene kan ikke diagnostisere generalisering.
- Tidlig stopp bør bruke valideringsadferd, aldri gjentatte beslutninger på det endelige testsettet.
- Mer data kan hjelpe, men flere funksjoner eller kapasitet kan også forverre overtilpasning.
- Regularisering, augmentering, kryssvalidering, lekkasjeforebygging og passende evaluering adresserer ulike årsaker.
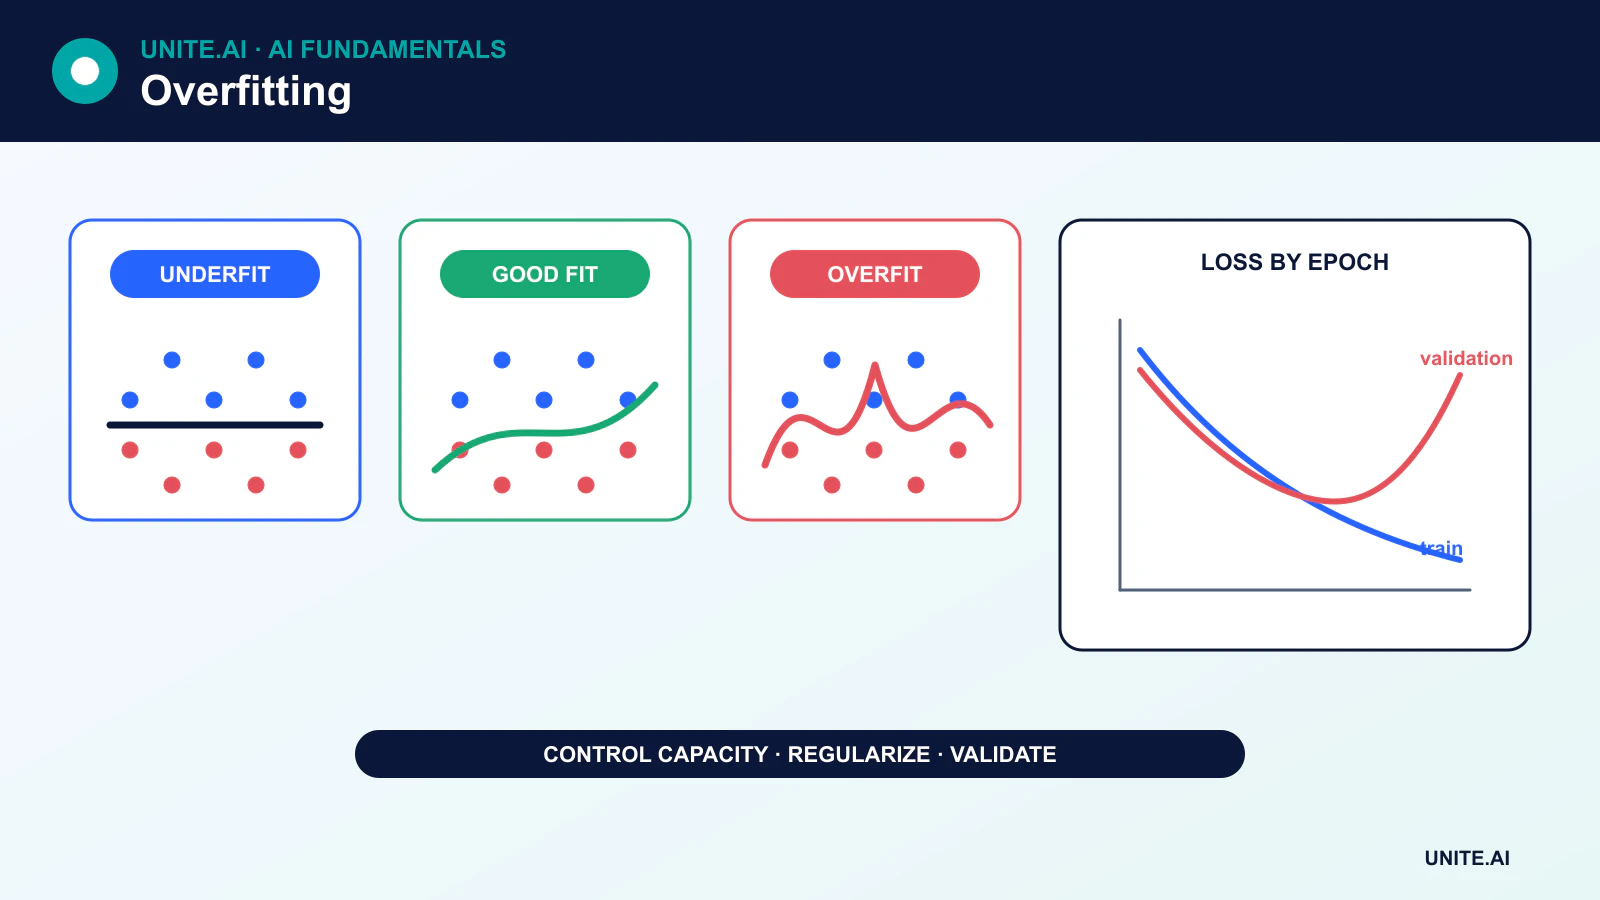
Tilpasning, underfitting og overfitting
En modell underfitter når dens antakelser er for restriktive, dens funksjoner utelater viktig signal, optimaliseringen er utilstrekkelig, eller treningen er utilstrekkelig. Å legge til relevante funksjoner eller kapasitet kan hjelpe, men å bare legge til vilkårlige funksjoner kan øke støy og overfitting.
En modell overfitter når dens effektive kapasitet er for høy i forhold til informasjonen i treningsdataene. Eksempler inkluderer et dypt decision tree som lager svært små blader, et polynom som følger tilfeldige svingninger, eller et nevralt nettverk som memoriserer eksempler.
Rollen til trenings‑, validerings‑ og testdata
- Training data tilpasser modellparametere.
- Validation data velger arkitektur, hyperparametere, terskler og stoppetidspunkt.
- Test data gir et endelig estimat etter at disse valgene er fullført.
Hvis testsettet gjentatte ganger styrer beslutninger, blir det en del av utviklingsprosessen og gir ikke lenger et upartisk sluttestimat. Kryssvalidering kan utnytte begrenset data mer effektivt, men all forhåndsbehandling og funksjonsutvelgelse må foregå innen hver treningsfold.
Tidlig stopp
Under trening faller vanligvis treningsfeilen kontinuerlig. Valideringsfeilen kan falle i starten og senere stige når modellen spesialiserer seg på treningsstøy. Tidlig stopp lagrer sjekkpunktet med best valideringsmål eller stopper etter at valideringen ikke har forbedret seg i en definert tålmodighetsperiode.
Det riktige sjekkpunktet er ikke det med lavest treningsfeil. Et eget endelig testsett evalueres etter at tidlig stopp og justeringsbeslutninger er fullført.
Regulariseringsmetoder
Vektstraff
L2-regularisering eller vektforfall demper store parameterverdier. L1-regularisering kan fremme sparsomme koeffisienter. Effektene avhenger av modell og optimaliserer; AdamW, for eksempel, frakobler vektforfall fra den adaptive oppdateringen.
Dropout og stokastisk regularisering
Dropout maskerer tilfeldig aktiveringer under trening. Andre metoder dropper stier, forstyrrer funksjoner eller jevner ut etiketter. Disse teknikkene endrer treningsmålet og må deaktiveres eller håndteres korrekt ved inferens.
Data‑augmentering
Augmentering lager realistiske variasjoner—som beskjæringer, rotasjoner, støy eller parafraseringer—som bør bevare målet. Ugyldige transformasjoner kan endre etiketten og skade modellen. For bildebehandling hjelper verktøy som Albumentations med å implementere kontrollerte pipelines.
Kapasitetskontroll
Grunnere trær, færre parametere, funksjonsutvelgelse, beskjæring og enklere hypoteseklasser kan redusere varians. Beskjæring av trær er kriteriedrevet, ikke tilfeldig fjerning av lært detalj.
Datalekkasjer kan se ut som eksepsjonell ytelse
Lekkasje oppstår når informasjon som ikke er tilgjengelig på prediksjonstidspunktet kommer inn i trening eller evaluering. Vanlige eksempler inkluderer å tilpasse normalisering på hele datasettet, splitte gjentatte poster på tvers av fold, bruke fremtidige data til å forutsi fortiden, eller inkludere en funksjon avledet fra målet.
Lekkasje er ikke vanlig overfitting, men den skaper samme misvisende gap mellom offline‑resultater og produksjon. Split‑strategien bør respektere tid, identitet, lokasjon og data‑genereringsprosesser.
Distribusjonsskifte er et eget problem
En modell kan generalisere til sin testfordeling og fortsatt feile når produksjonsdata endres. Nye enheter, retningslinjer, populasjoner, årstider eller ondsinnet atferd kan forskyve forholdet mellom input og mål. Overvåking og periodisk revurdering er nødvendig selv om den opprinnelige modellen ikke var overtilpasset.
Diagnostisering av overfitting
Bruk læringskurver, kryssvalideringsvarians, undergruppe‑metrikker, kalibrering og feilinspeksjon. Hvis både trenings‑ og valideringsytelse er dårlig, fokuser på underfitting, funksjoner, etiketter eller optimalisering. Hvis treningen er sterk og valideringen svak, undersøk kapasitet, lekkasje, regularisering og representativitet før du bare samler mer data.
Hvorfor overfitting oppstår og hvordan man oppdager det
Overfitting oppstår når en modell lærer mønstre som reduserer treningsfeil, men som ikke generaliserer til målpopulasjonen. Årsaker inkluderer overdreven kapasitet i forhold til effektiv data, etikettstøy, gjentatte enheter, fleksibel funksjonsutvelgelse, lekkasje og justering mot samme valideringssett. Et økende gap mellom trenings‑ og valideringsytelse er vanlig bevis, men et lite gap utelukker ikke overfitting dersom begge sett deler forurensning eller avviker fra produksjon. Læringskurver over datavolum og kapasitet hjelper med å skille varians fra bias.
Lekkasje er spesielt villedende: fremtidig informasjon, duplikater, overlappende subjekter, forhåndsbehandling tilpasset på all data, eller etiketter kodet i metadata kan gi utmerkede hold‑out‑resultater. Del etter enheten som vil være ny ved utrulling—pasient, kunde, maskin, lokasjon eller tid—før du tilpasser transformasjoner eller augmenteringer. Hold et endelig testsett lukket mens du velger funksjoner, arkitektur og terskler. Hvis team gjentatte ganger inspiserer testresultater, blir testsettet et annet valideringssett og krever erstatning eller formell korrigering.
Regularisering, modellvalg og produksjonsdrift
Reduser overfitting med mer representativ data, lavere kapasitet, vektforfall, dropout, tidlig stopp, augmentering, ensemble‑metoder eller begrensninger som gjenspeiler domenestrukturen. Hver metode har kompromisser: augmentering kan forvrenge etiketter, dropout endrer optimalisering, og ensembler øker betjeningskostnaden. Kryssvalidering estimerer valgvariabilitet, men grupperte eller tidsbevisste fold må bevare utrullingsgrensen. Sammenlign med en enkel modell og rapporter usikkerhet over fold eller frø i stedet for å velge den mest gunstige kjøringen.
Produksjon kan avdekke en annen form for generaliseringsfeil når input, brukere, insentiver eller måling endres. Overvåk funksjons‑ og prediksjonsfordelinger, kalibrering, undergruppe‑resultater og forsinket sannhet. Ikke tren automatisk på urevurdert tilbakemelding; modellens egne beslutninger kan forme etikettene den senere ser. Diagnostiser om feilen skyldes drift, datapipelines, policy‑endringer eller et ugyldig mål. Overfitting styres av eksperimentell design og livssyklussedisiplin, ikke en enkelt regulariseringsinnstilling.
Arbeids‑eksempel: fjerning av lekkasje i en svindelmodell
En første svindelklassifikator får ekstremt gode poeng fordi gjentatte kort‑ og handels‑hendelser dukker opp i tilfeldige trenings‑ og test‑rader, og chargeback‑informasjon registrert uker senere er inkludert som en funksjon. Teamet rekonstruerer hver funksjons tilgjengelighetstid, fjerner felt etter beslutning, grupperer etter konto, og bruker en fremover‑tids‑splitt. Ytelsen faller kraftig, men estimerer nå den faktiske beslutningen. En enkel regel‑baseline og læringskurver styrer den nødvendige modellkompleksiteten.
Regularisering og tidlig stopp tunes kun innen historiske fold. Den endelige evalueringen rapporterer presisjon ved gjennomgangskapasitet, tilbakekalling, kalibrering og kostnad etter svindeltype og kundesegment. I produksjon kommer bekreftede etiketter sent og er skjeve av hvilke transaksjoner som ble gjennomgått, så overvåking skiller poeng‑drift fra resultat‑estimater. Gjen‑trening bruker dommer‑saker og replay mot gjeldende policy. Prosjektet foretrekker en lavere ærlig poengsum fremfor en høy lekket som ikke kan overleve i produksjon.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, input, output, avhengigheter, eier, og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feilformatert eller manglende input, distribusjonsskifte, avhengighetsavbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig revisor kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåking med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑adferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en responsansvarlig, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagringsprosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Kan en enkel modell overfitte?
Ja. Gjentatt funksjonsutvelgelse, terskeljustering eller evaluering på samme hold‑out kan overfitte utviklingsprosessen selv om den endelige modellen er enkel.
Løser mer treningsdata alltid overfitting?
Nei. Mer representativ, korrekt merket data kan hjelpe, men duplisert, skjev, lekket eller utenfor‑domene data gjør det kanskje ikke. Læringsmålet og evalueringsdesignen er fortsatt viktig.
Primære referanser












