Grunnleggende AI
Hva er dyp læring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Dyp læring er en familie av maskinlæringsmetoder som bruker nevrale nettverk med flere behandlingslag for å lære nyttige representasjoner av data. Disse modellene driver mange moderne systemer for språk, bilder, lyd, anbefalinger, vitenskapelige spådommer og generativ AI.
Ordet dyp refererer til antall transformasjoner mellom input og output, ikke til at en maskin har dypere forståelse. En dyp modell lærer numeriske relasjoner som er nyttige for dens treningsmål, og ytelsen må fortsatt testes på nye data.
Viktige punkter
- Dyp læring er en undergruppe av maskinlæring.
- Lag transformerer tensorer ved hjelp av lærte parametere, ikke‑lineære aktiveringer, normalisering og andre operasjoner.
- Tilbakepropagering beregner gradienter; en optimizer bruker disse gradientene til å oppdatere trenbare parametere, inkludert vekter og bias.
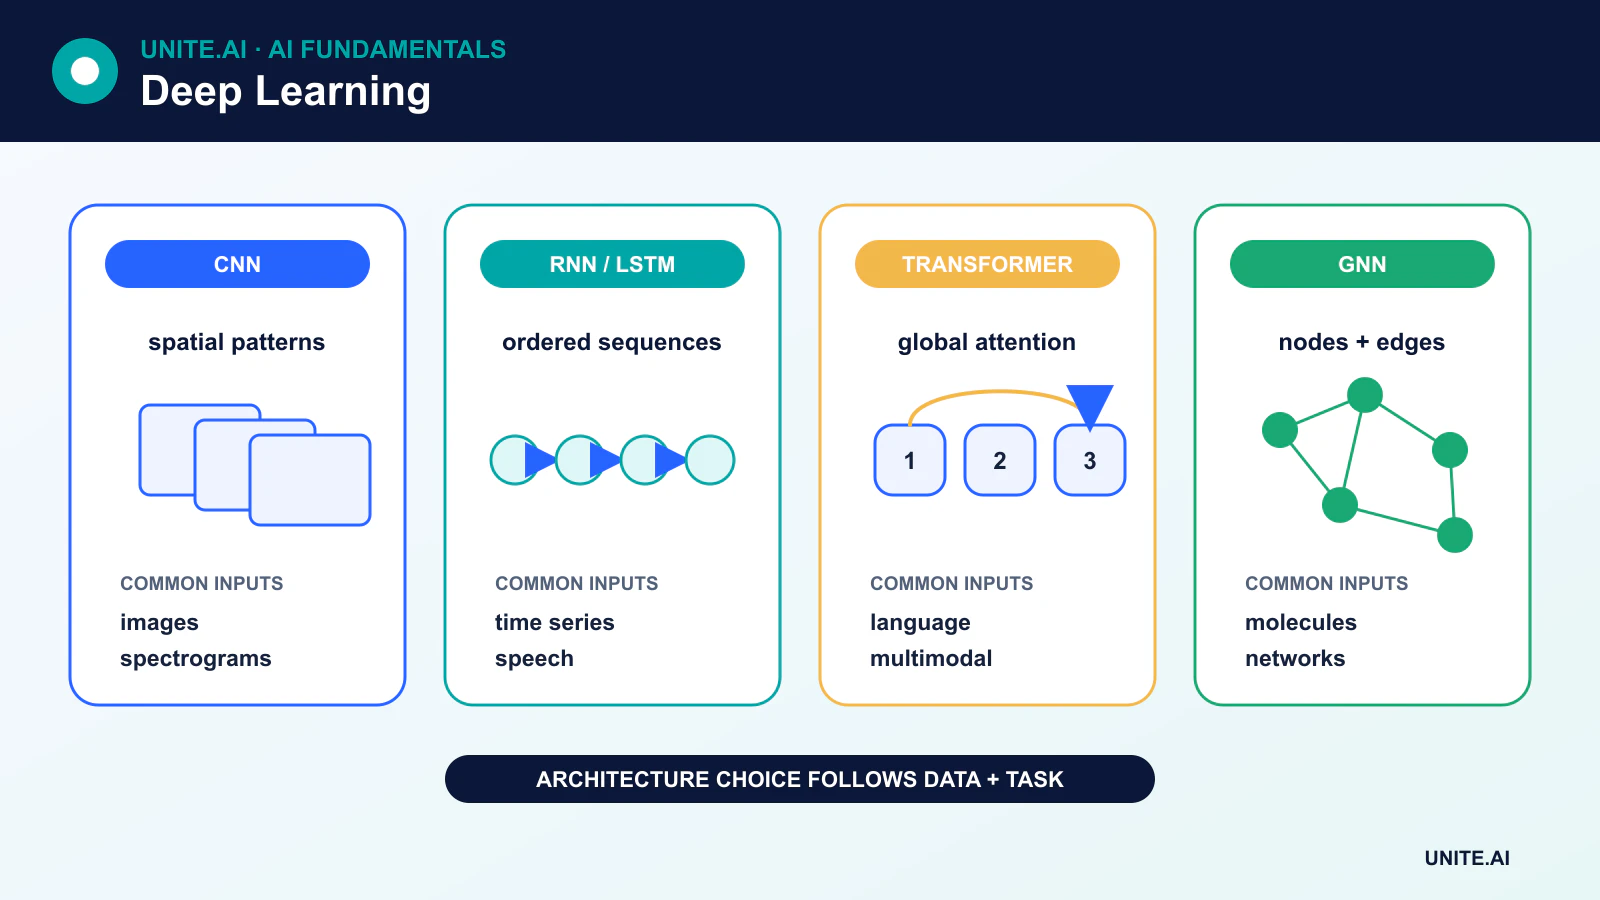
- CNN‑er, rekurrente nettverk, transformere, autoenkodere og diffusionsmodeller har ulike strukturer og styrker.
Hvordan et dypt nevralt nettverk lærer
Et nevralt nettverk mottar data som tensorer, eller flerdimensjonale tallmatriser. En bildetensor kan kode pikselkanaler, mens en språkmodell bruker vektorer som representerer tokens. Hvert lag utfører en differensierbar transformasjon og sender resultatet til neste lag.
I et enkelt tett lag beregner modellen en vektet sum av sine input‑verdier, legger til en trenbar bias, og anvender deretter en aktiveringsfunksjon:
output = activation(Wx + b)
Aktiveringsfunksjonen introduserer ikke‑linearitet. Uten den ville stablet av vanlige lineære lag fortsatt bare representere en lineær transformasjon. ReLU og varianter er vanlige i skjulte lag, mens output‑aktiveringer avhenger av oppgaven.
Trening følger vanligvis fire trinn:
- Et forward pass produserer prediksjoner.
- En loss‑funksjon måler hvordan prediksjonene avviker fra målet.
- Tilbakepropagering bruker kjerneregelen for å beregne gradienten av tapet med hensyn til hver trenbar parameter.
- En optimizer som stokastisk gradientnedstigning eller AdamW oppdaterer parametrene.
Å gjenta disse trinnene over mange batcher kan forbedre modellen, men lav trenings‑loss garanterer ikke pålitelig oppførsel i den virkelige verden. Validering, regularisering, representative data og overvåking er fortsatt essensielt.
Viktige dyp‑læringsarkitekturer
Flerlags perseptroner
En flerlags perseptron (MLP) bruker fullt tilkoblede lag der hver output‑enhet avhenger av alle input‑verdier fra forrige lag. MLP‑er er nyttige for tabulære funksjoner og som komponenter i større systemer, men de inneholder ingen antakelser om bildelokalitet eller sekvensrekkefølge.
Konvolusjonelle nevrale nettverk
Konvolusjonelle nevrale nettverk (CNN‑er) anvender lærte filtre over lokale områder. Vektdeling gjør dem effektive for gittere som bilder og spektrogrammer. CNN‑er forblir viktige for syn og edge‑utplassering, selv om visjon‑transformere og hybride modeller også er mye brukt.
Rekurrente nettverk, LSTM‑er og GRU‑er
Rekurrente nevrale nettverk (RNN‑er) oppdaterer en skjult tilstand mens en sekvens behandles. LSTM‑er og gated recurrent units hjelper med å bevare informasjon og redusere problemet med forsvinnende gradient som gjør grunnleggende RNN‑er slite med lange avhengigheter. De eliminerer ikke alle begrensninger knyttet til lang kontekst, men de er fortsatt nyttige for strømmende signaler, tidsseriedata og kompakte sekvensielle modeller.
Transformere
Transformere bruker oppmerksomhet (attention) for å modellere relasjoner mellom elementer i en sekvens eller et sett. Evnen til å behandle mange posisjoner parallelt hjalp dem med å erstatte rekurrens i de fleste store språk‑systemer, og transformervarianter behandler nå bilder, lyd, video, proteiner og multimodale data.
Autoenkodere og generative modeller
En autoenkoder komprimerer en input til en representasjon og rekonstruerer inputen fra den. Dette skaper et selv‑supervisert rekonstruksjonsmål; det gjør ikke automatisk ubemannede data om til merkede eksempler.
Generative adversarial networks trener en generator og en diskriminator i konkurranse. Diffusjonsmodeller lærer å reversere en gradvis støyingsprosess. Autoregressive transformere genererer ett token eller enhet om gangen. Disse tilnærmingene har ulike treningsdynamikker, kontrollerbarhet og beregningskrav.
Hvorfor dybde hjelper—og hvorfor arkitektur betyr noe
Flere lag lar en modell sette sammen enklere transformasjoner til mer komplekse. I visjon kan noen lærte trekk utvikle seg fra lokale teksturer mot oppgavespesifikke mønstre. I språk bygger oppmerksomhetslag kontekstavhengige token‑representasjoner. Disse beskrivelsene er nyttige intuisjoner, ikke faste regler for hva hvert lag må lære.
Moderne nettverk bruker også residual‑forbindelser, normalisering, nøye initiering, regularisering og optimalisert maskinvare. Å bare legge til lag eller parametere kan gjøre en modell vanskeligere å trene, tregere, eller mer utsatt for over‑tilpasning. Modellens skala hjelper kun når data, mål, optimalisering og distribusjonsmiljø støtter det.
Trening versus inferens
Trening justerer parametere og er vanligvis den beregningsintensive fasen. Inferens kjører den trente modellen for å produsere en output. Inferens kan fortsatt være kostbart for store modeller, noe som gjør at team bruker kvantisering, destillasjon, batch‑behandling, caching, sparsitet og spesialisert maskinvare som nevrale prosesseringsenheter.
Begrensninger og ansvarlig bruk
Dype modeller kan arve skjevheter, memorere sensitiv informasjon, feile under distribusjons‑skift, og produsere overbevisende men feilaktige resultater. De kan også være vanskelige å tolke og kostbare å trene. Evaluering bør dekke mer enn et benchmark‑gjennomsnitt: team trenger klasse‑ eller undergruppe‑nivå ytelse, robusthet, kalibrering, sikkerhet, latency, energiforbruk og konsekvensene av feil.
Representasjoner, optimalisering og arkitekturvalg
Dype nettverk lærer påfølgende representasjoner gjennom parameteriserte lag. Lineære transformasjoner blander input; ikke‑lineære aktiveringer gjør at nettverket kan tilnærme komplekse funksjoner; normalisering og residual‑forbindelser hjelper optimalisering; oppmerksomhet, konvolusjon, rekurrens eller state‑space‑operasjoner kodar ulike strukturelle antakelser. Dybde øker antall transformasjoner, ikke garantert intelligens. Arkitekturen bør reflektere modaliteten, datavolum, latency, minne og invariansene til oppgaven. En mindre konvolusjonell modell kan overgå en transformer når data er begrenset og lokal romlig struktur dominerer.
Trening beregner en loss, differensierer den med tilbakepropagering, og oppdaterer parametere med en optimizer som stokastisk gradientnedstigning eller Adam. Batch‑størrelse, læringsrate, skjema, initiering, regularisering og numerisk presisjon påvirker hverandre. Kurver for trenings‑ og validerings‑loss hjelper med å skille under‑fitting, over‑fitting, ustabilitet og lekkasje, men de fastslår ikke nytte i den virkelige verden. Bruk uavhengige evalueringsdata, gjentatte kjøringer der varians er viktig, ablasjoner og sammenligning med enklere baselines. Store parameter‑antall øker også behovet for datastyring, beregningsplanlegging og reproduserbar konfigurasjon.
Servering av dype modeller trygt og effektivt
Distribusjon kan bruke et hostet endepunkt, dedikert akselerator, nettleser, telefon eller innebygd enhet. Eksport og kompilering kan slå sammen operatører, kvantisere vekter og aktiveringer, eller endre numerisk oppførsel, så valider det distribuerte artefaktet i stedet for kun trenings‑checkpointen. Mål kald start, jevn latency, gjennomstrømning, minne, strømforbruk og kvalitet ved realistiske batch‑ og sekvensstørrelser. Komprimeringsmetoder—pruning, destillasjon, kvantisering og lav‑rang‑adaptasjon—bytter størrelse eller hastighet mot nøyaktighet og ingeniørkompleksitet og må vurderes på sensitive klasser og kant‑tilfeller.
Dype modeller kan feile selvsikkert under distribusjons‑skift, adversarial input, falske korrelasjoner og dårlig representerte grupper. Overvåk input‑ og output‑fordelinger, oppgaveutfall, kalibrering, ressursbruk og avhengighetsversjoner. Bruk tilgangskontroll, signerte artefakter, beskyttet treningsdata, red‑teaming og rate‑limits som passer til trusselmodellen. Forklaringer som salienskart eller oppmerksomhetsvisninger er diagnostisk bevis, ikke bevis på årsakssammenheng. Kombiner dem med atferdstester, kontrafaktiske, menneskelig gjennomgang, hendelsesrespons og eksplisitte begrensninger på automatiserte beslutninger.
Arbeidseksempel: trening av en bildedefekt‑detektor
En fabrikk samler produktbilder fra ulike kameraer, skift, materialer og kjente defektklasser, og deler dem etter produksjonsbatch slik at nesten‑dupliserte elementer ikke kan krysse partisjoner. En liten konvolusjonell baseline sammenlignes med et forhåndstrent dypt nettverk. Augmentering gjenskaper validert belysning og synsvinkelvariasjon uten å fjerne defekter. Evaluering rapporterer per‑defekt recall, falsk‑avvisningsrate, kalibrering, inferens‑latency og robusthet mot uskarphet, blending, kamera‑bytte og sjeldne materialfarger.
Den eksporterte modellen og eksakt kode for resizing, farge og normalisering testes på linje‑maskinvaren for vedvarende gjennomstrømning og termisk oppførsel. Lav‑tillit‑tilfeller sendes til inspektører; en uavhengig regel stopper linjen ved sikkerhetskritisk sensorsvikt. Bilder beholdes kun som tillatt og modellartefakter signeres. Overvåkning kobler prediksjoner til senere inspeksjonsresultater og produksjonslotter. Et nytt kamera eller materiale utløser en kontrollert revurdering i stedet for stille online‑læring fra urevurderte etiketter.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, input‑ene, output‑ene, avhengighetene, eieren og konsekvensene av hver viktig feil. Etabler en reproduserbar baseline og et versjonert evalueringssett før tuning. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende input, distribusjons‑skift, avhengighets‑nedetid, misbruk og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latency, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig reviewer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, rollback og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regel‑versjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle inn unødvendige sensitive data. Definer varslings‑terskler og en responsansvarlig, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagrings‑prosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Primære referanser