
Grunnleggende AI
Hva er RNN-er og LSTM-er i dyp læring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
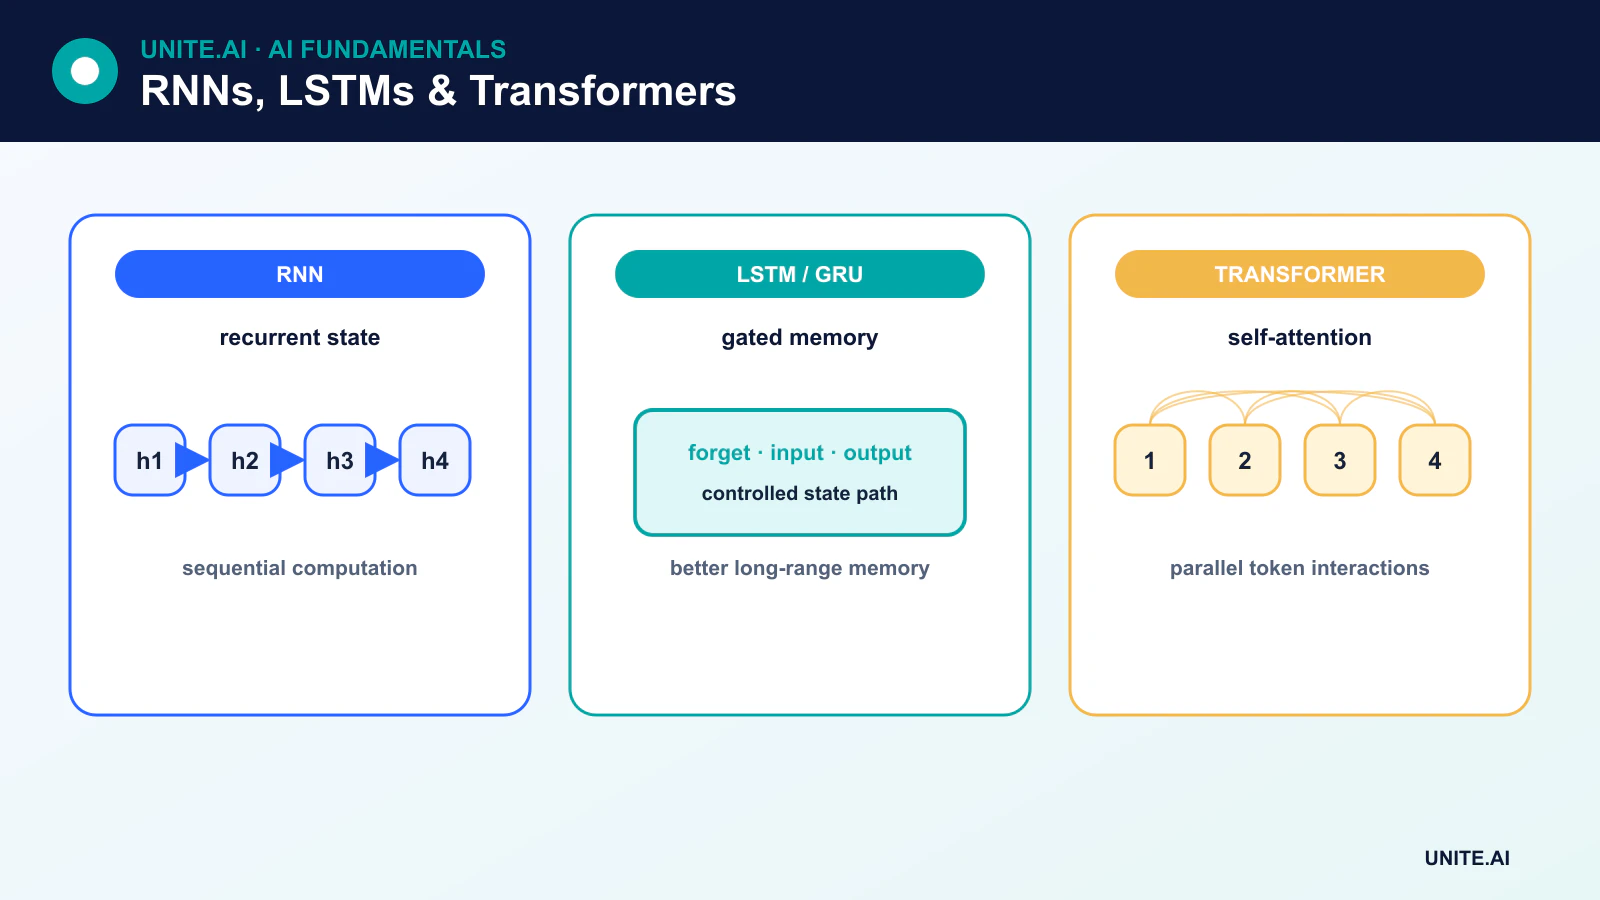
Rekurrente nevrale nettverk (RNN-er) behandler sekvenser ved å oppdatere en skjult tilstand over tid. Long short-term memory (LSTM)-nettverk er porterede RNN-er designet for å bevare og kontrollere informasjon mer effektivt enn en enkel rekurrent enhet.
RNN-er og LSTM-er dominerte tidligere mange språkoppgaver, men moderne store chat‑boter er primært basert på transformere. Rekurrente modeller er fortsatt nyttige for strømming, tidsserier, tale, kontroll og ressursbegrensede systemer hvor inkrementell tilstand og lav latens er viktig.
Nøkkelpunkter
- En RNN gjenbruker de samme parametrene på hvert sekvenssteg og viderefører en skjult tilstand.
- Trening over tid kan føre til forsvinnende eller eksploderende gradienter.
- En LSTM legger til en celletilstand samt inngangs‑, glemsel‑ og utgangsporter.
- Transformere håndterer langdistanseforhold og parallell trening på en annen måte; ingen av arkitekturene er best for alle implementeringer.
Hvordan en enkel RNN fungerer
Ved steg t kombinerer en enkel rekurrent enhet den nåværende inngangen xₜ med den forrige skjulte tilstanden hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
Den skjulte tilstanden er et lært sammendrag som brukes til neste steg og, avhengig av oppgaven, som en utgang. Et «utrullet» diagram viser én kopi per tidssteg, men alle kopier deler parametere. Utgangen kopieres ikke bare tilbake som ny råinngang; rekurrensen sender den skjulte tilstanden gjennom en definert transformasjon.
Tilbakepropagering gjennom tid
RNN-er trenes med tilbakepropagering gjennom tid (BPTT). Den utrullede sekvensen danner en dyp beregningsgraf, og tilbakepropagering beregner hvordan tapet avhenger av de delte rekurrente parametrene.
Gjentamultiplikasjon kan få gradientene til å krympe mot null eller vokse uten grenser. Forsvinnende gradienter hindrer læring av lange avhengigheter; eksploderende gradienter skaper ustabile oppdateringer. Gradientklipping håndterer eksploderende gradienter, mens portering, initialisering, normalisering og kortere treningsvinduer kan hjelpe.
Inni en LSTM-celle
En LSTM opprettholder en celletilstand cₜ i tillegg til den skjulte tilstanden hₜ. Dens porter er lærte, datadrevne kontroller:
- Glemselporten styrer hvor mye av den forrige celletilstanden som beholdes.
- Inngangsporten styrer hvor mye kandidatinformasjon som skrives.
- Utgangsporten styrer hvor mye celleinformasjon som bidrar til den skjulte tilstanden.
Sigmoid‑utganger mellom null og én fungerer som myke porter, mens en tanh‑transformert kandidat leverer nytt innhold. Den additive celletilstandsveien hjelper gradientene med å vedvare, men LSTM-er garanterer ikke ubegrenset minne eller eliminerer alle optimaliseringsproblemer.
GRU-er og todireksjonell rekurrens
En gated recurrent unit (GRU) kombinerer portmekanismer i en enklere rekurrent celle uten en separat LSTM‑lignende celletilstand. GRU-er kan trenes raskere og yte likt på enkelte oppgaver.
En todireksjonell RNN behandler en fullført sekvens i begge retninger og kombinerer tilstandene. Den kan bruke fremtidig kontekst for merking eller koding, men er upassende for kausal strømming når fremtidige innganger ennå ikke er tilgjengelige.
Sekvens‑til‑sekvens‑modeller
Encoder‑decoder RNN-er kartlegger én sekvens til en annen. Oppmerksomhet ble introdusert for å la en dekoder konsultere ulike encoder‑tilstander i stedet for å stole på én fast vektor. Denne utviklingen førte til transformer‑arkitekturen, som erstattet rekurrens med oppmerksomhetsbaserte blokker.
RNN-er versus transformere
Transformere behandler treningsposisjoner parallelt og skaper korte oppmerksomhetsveier mellom fjerne token. RNN-er behandler tilstand sekvensielt, noe som begrenser parallellitet men gir en konstant størrelse på den rekurrente tilstanden under strømming. Transformer‑inferenz kan kreve en voksende nøkkel‑verdi‑cache, mens en RNN komprimerer historikken inn i sin skjulte tilstand og kan miste detaljer.
Velg basert på sekvenslengde, datamengde, maskinvare, latens, minne og om oppgaven er offline eller i strømming. Hybrid‑ og tilstandsrom‑arkitekturer gir ytterligere avveininger.
Nåværende bruksområder
RNN-er og LSTM-er er fortsatt relevante for prognoser, anomali‑deteksjon, sensorbehandling, tale‑komponenter, håndskrift, innebygd kontroll og lav‑latens sekvensmodellering. De er ikke standardforklaringen på dagens store språkmodeller eller AI‑chatboter.
Rekurrens, porter og sekvensminne
Et rekurrent nevralt nettverk behandler en sekvens ved å kombinere den nåværende inngangen med en skjult tilstand som er båret fra tidligere steg. Delte vekter tillater variabel sekvenslengde, og utrulling eksponerer beregningen over tid for trening. Enkle RNN-er kan representere tidsavhengighet, men gradienter som gjentatte ganger multipliseres over lange sekvenser har en tendens til å forsvinne eller eksplodere. Avkortet tilbakepropagering begrenser minne og beregning, mens gradientklipping kontrollerer ekstreme oppdateringer. Den skjulte tilstanden er et lært sammendrag, ikke en nøyaktig lagring av hver tidligere token.
Long short-term memory‑nettverk legger til en celletilstand samt inngangs‑, glemsel‑ og utgangsporter som regulerer skriving, beholdning og eksponering av informasjon. Gated recurrent units bruker en enklere tilbakestillings‑ og oppdateringsstruktur. Todireksjonelle varianter bruker fremtidig kontekst og kan derfor ikke strømme kausalt uten forsinkelse. Stablede, residuale og oppmerksomhetsutvidede rekurrente modeller øker kapasiteten. Padding og masker må hindre kunstige sekvenselementer i å påvirke tilstand eller tap, og tilstanden bør nullstilles ved ekte sekvensgrenser for å unngå lekkasje mellom eksempler.
Trening, sammenligning og tilstandsbasert tjeneste
RNN-er og LSTM-er er fortsatt nyttige for strømming, kompakte modeller på enheten, tidsserier og arbeidsbelastninger hvor sekvensiell tilstand er effektiv. Transformere parallelliserer trening og modellerer langdistanseinteraksjoner på en annen måte, men kan kreve større minne og cache. Sammenlign arkitekturer på nøyaktighet, latens, gjennomstrømning, minne, strømforbruk og ytelse etter hvert som sekvenslengden endres. Evaluer prognoser med rullende tids‑splitt, språk med sekvens‑bevisste mål, og anomali‑deteksjon med hendelses‑nivå‑mål. Undersøk feil etter lange hull, regime‑endringer, manglende prøver og brå sekvensgrenser.
Tilstandsbasert distribusjon må knytte skjult tilstand til riktig økt, utløse den, kryptere den hvis sensitiv, og nullstille den etter feil eller modellendringer. Hendelser uten rekkefølge eller dupliserte kan korrumpere tilstanden; inkluder tidsstempler, sekvensnumre og idempotens. Overvåk tilstandsalder, sekvenslengde, mangler, utgangs‑drift og latens. Kvantisering krever port‑sensitiv validering fordi små numeriske endringer kan akkumulere over tid. RNN‑minne muliggjør kontekst, men kan også bevare privat eller foreldet informasjon, så lagrings‑ og bruker‑kontroller må innlemmes i designet.
Arbeidseksempel: en LSTM for strømmende sensorssekvenser
Et verktøy bruker en LSTM til å forutsi kort‑siktig belastning fra nylige målinger, kalender og vær. Sekvenser bygges med streng tidsrekkefølge; skjult tilstand nullstilles ved mate‑grenser, og padding maskeres. Sesong‑naive og gradient‑boosted basislinjer sammenlignes med LSTM‑en over rullende vinduer. Tester dekker manglende intervaller, forsinket vær, helligdager, strømbrudd og sekvenslengder utover vanlig trening.
Strømmetjenesten knytter tilstand til én mate, avviser dupliserte utenfor rekkefølge, og utløser tilstand etter lange hull eller modelloppdateringer. En sikker statistisk prognose erstatter utgangen når sensorer eller tilstand er ugyldige. Kvantisert inferens sjekkes over lange sekvenser for akkumulert drift. Overvåking sporer tilstandsalder, mangler, latens, skjevhet og intervall‑feil. Modellen trenes kun på nytt etter nettverksendringer, og gjennomgåtte resultater viser at de lærte tidsmessige relasjonene ikke lenger generaliserer.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer målbrukere, driftsmiljø, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grenseforhold, feil‑ eller manglende input, distribusjons‑skift, avhengighets‑nedbrudd, misbruk, og de grupper eller miljøer som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan gjenskape resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke input‑kvalitet, output‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en responsansvarlig, gjennomgå deretter virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vedvarer. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, slettings‑ og lagrings‑prosedyrer, samt et klart punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er en LSTM alltid bedre enn en enkel RNN?
Nei. Portering hjelper mange problemer med lange avhengigheter, men tilfører beregning og parametere. En enkel RNN kan være tilstrekkelig for korte, enkle sekvenser, og en annen arkitektur kan være bedre for svært lang kontekst.
Kan en LSTM behandle en ubegrenset historikk?
Nei. Tilstanden har begrenset kapasitet, gradienter og treningsdata pålegger grenser, og relevante detaljer kan bli overskrevet. Ytelse på lang kontekst må måles i stedet for å antas ut fra arkitekturens navn.
Primære referanser












