
Grunnleggende AI
Hva er CNN-er (Convolutional Neural Networks)?

 Legg til Unite.AI blant dine foretrukne kilder på Google
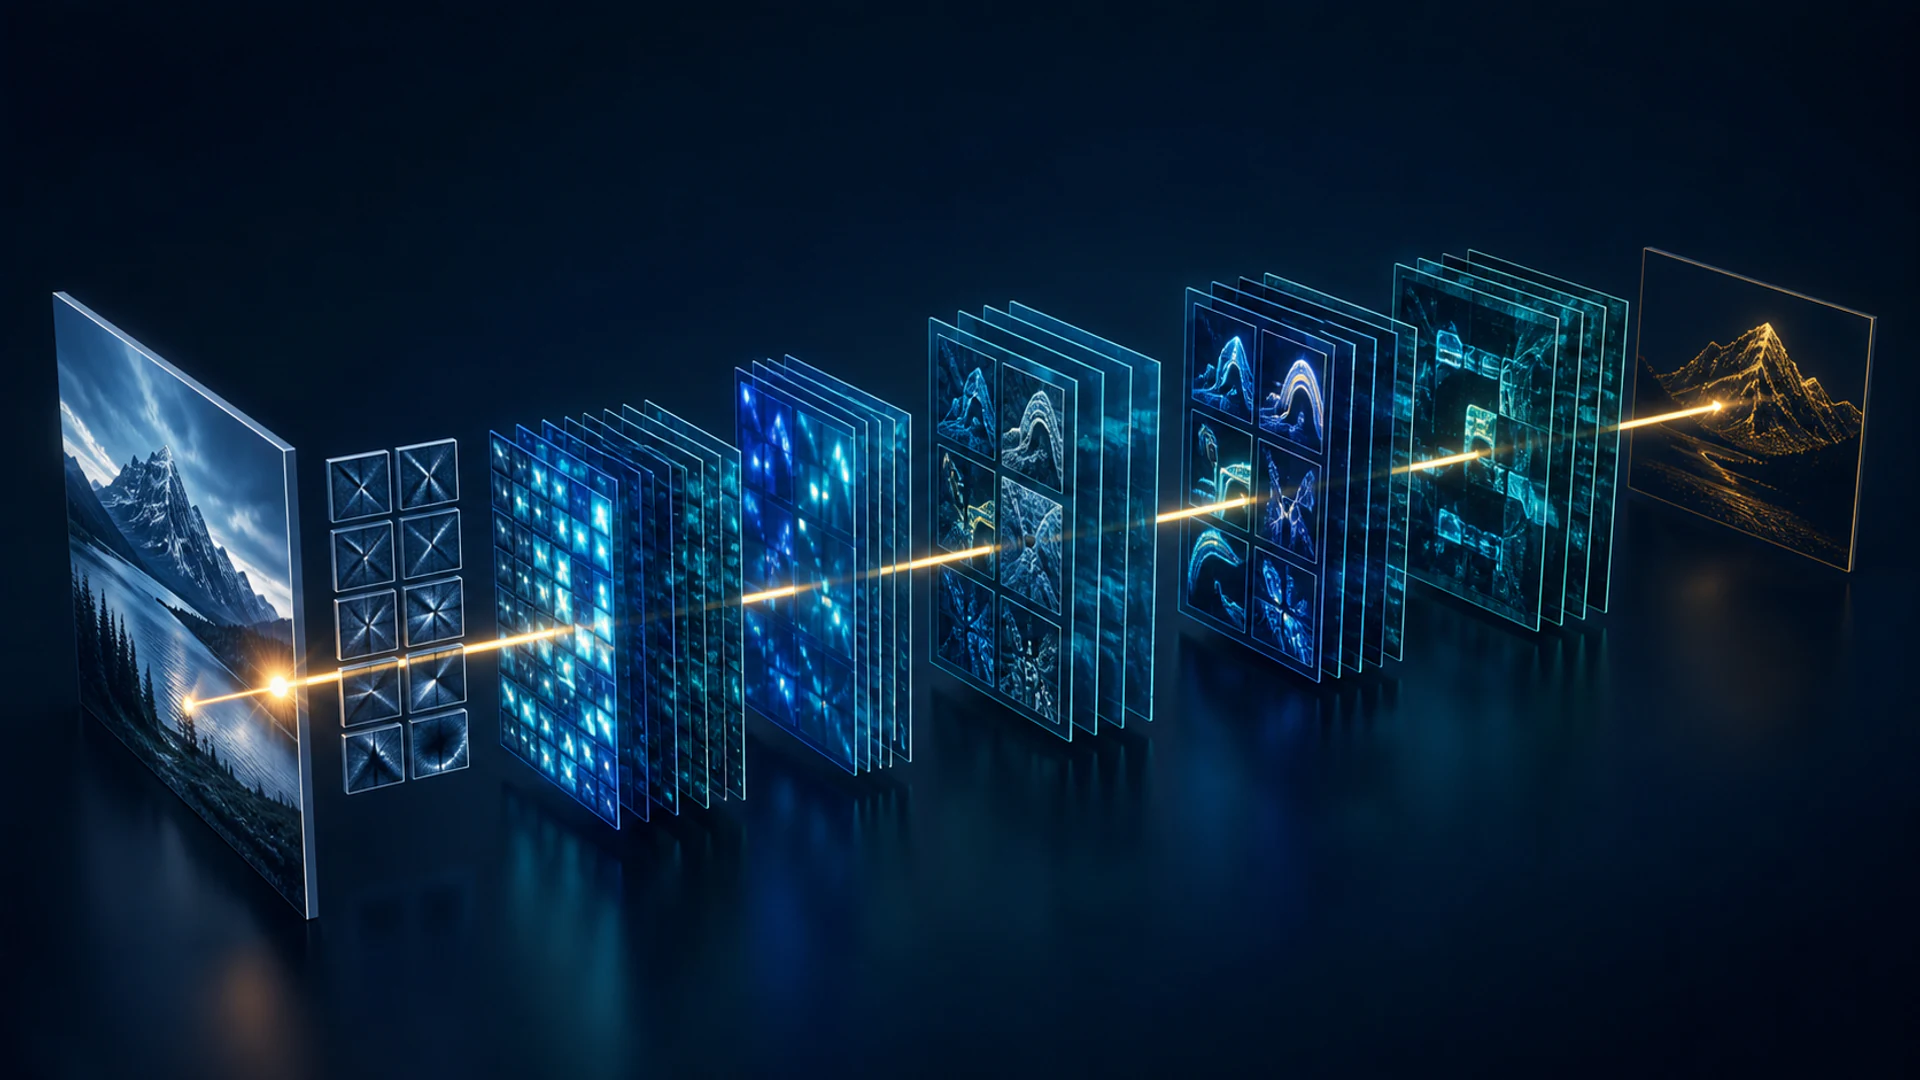
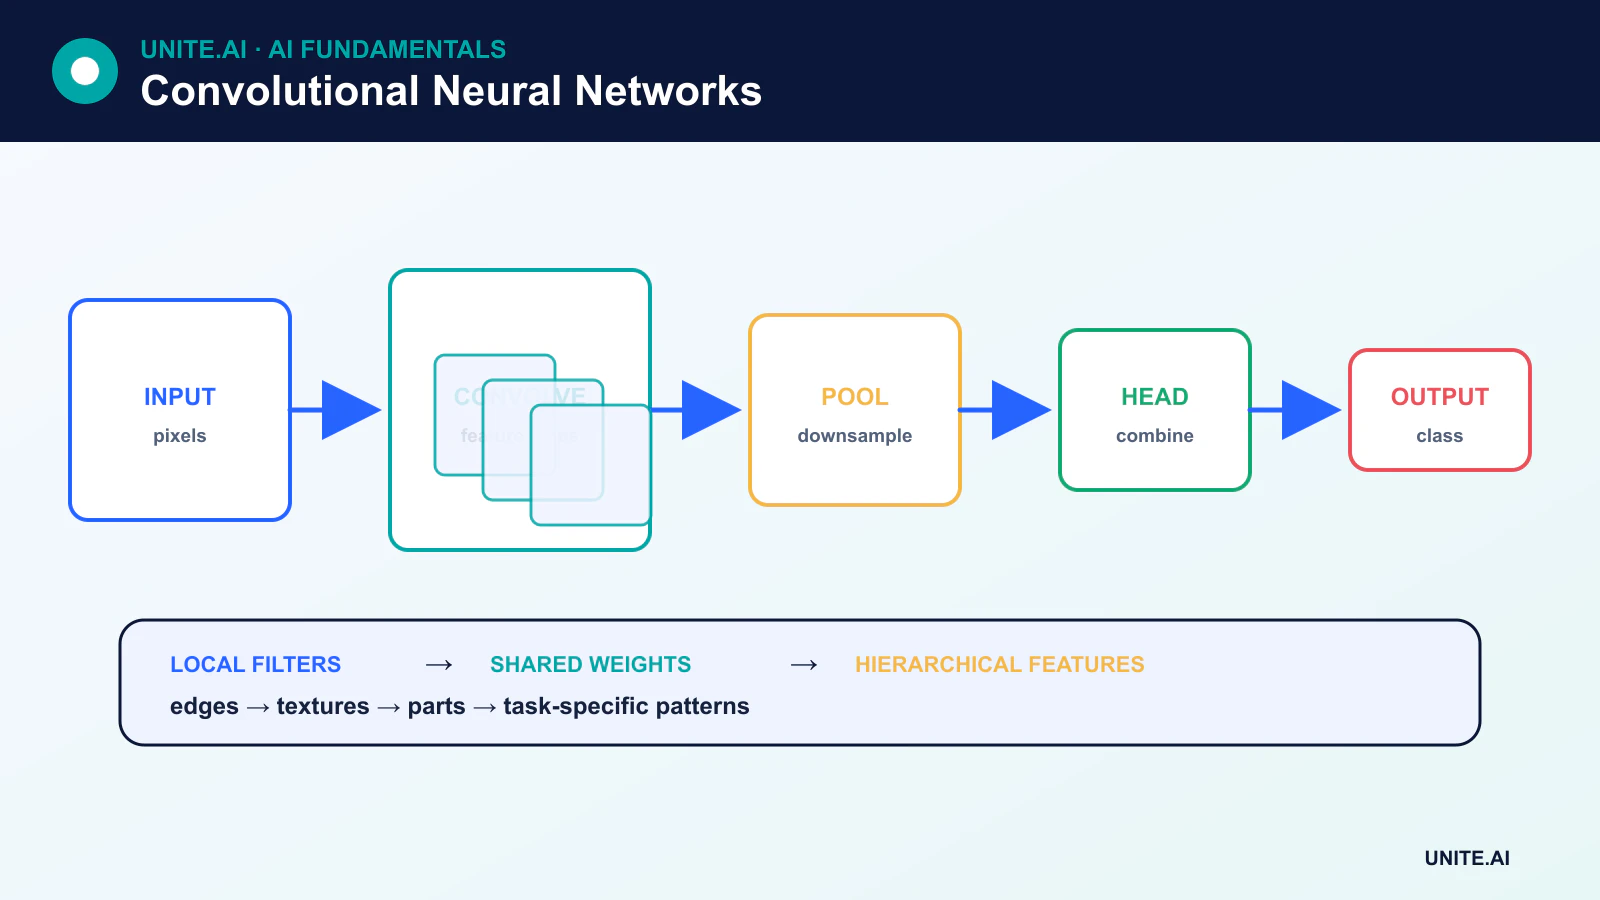
Et konvolusjonelt nevralt nettverk (CNN) er en nevralt nettverksarkitektur som bruker lærte filtre over lokale regioner av en inngang. CNN-er ble grunnleggende for moderne datamaskinsyn fordi de kan oppdage mønstre uavhengig av hvor mønstrene forekommer og gjenbruke de samme parameterne over et bilde.
Et CNN konverterer ikke et bilde fra ikke‑numerisk til numerisk form – bildet kommer allerede som en tensor av pikselverdier. Formålet er å transformere den tensoren til funksjonskart som er nyttige for klassifisering, gjenkjenning, segmentering eller en annen oppgave.
Viktige punkter
- En konvolusjon kombinerer lokale inngangsverdier med en lært kjerne for å produsere et funksjonskart.
- Stride, padding, dilatasjon og pooling styrer romlig oppløsning og det reseptive feltet.
- Vektdeling gjør CNN-er mer parameter‑effektive enn et fullt tilkoblet nettverk over rå piksler.
- Vision‑transformere tilbyr et alternativ, men CNN-er forblir sterke for effektive og databegrensede systemer.
Hvordan konvolusjon fungerer
En kjerne er et lite rutenett av trenbare vekter. På hver posisjon multipliserer CNN kjerneverdiene med de tilsvarende inngangsverdiene, summerer resultatene, og legger vanligvis til en bias. Å gjenta dette over hele inngangen produserer et funksjonskart.
For et fargebilde dekker en kjerne alle inngangskanalene. Et lag bruker flere kjerner for å lage flere utgangskanaler. Under trening beregner bakoverpropagering gradienter for disse kjernevektene; konvolusjonsoperasjonen lager ikke et nytt fast sett med vekter fra hvert bilde.
Stride, padding og dilatasjon
- Stride styrer hvor langt kjernen beveger seg. En stride større enn én reduserer romlig oppløsning.
- Padding legger til verdier rundt en inngang slik at kantinformasjon kan behandles og utgangsstørrelsen kan kontrolleres.
- Dilatasjon spreder kjerneelementene, utvider det reseptive feltet uten å øke antall parametere proporsjonalt.
Det reseptive feltet er området av den opprinnelige inngangen som kan påvirke en enhet. Å stable konvolusjoner utvider det, slik at senere funksjoner kan kombinere informasjon fra bredere områder.
Aktivering, normalisering og pooling
Konvolusjonslag følges vanligvis av ikke‑lineære aktiveringer og normalisering. Pooling oppsummerer lokale regioner ved hjelp av en operasjon som maksimum eller gjennomsnitt. Lærte strided‑konvolusjoner kan også nedprøve.
Pooling er ikke obligatorisk. Mange moderne nettverk bruker global gjennomsnitts‑pooling nær utgangen i stedet for å flate ut et stort funksjonskart til en fullt tilkoblet stabel. Dette reduserer antall parametere og lar nettverket aggregere romlig evidens.
En moderne CNN‑arkitektur
En typisk visuell modell inneholder en rot (stem), en sekvens av funksjonsblokker, nedprøvingsstadier og et oppgavehode. Residual‑forbindelser lar en blokk lære en modifikasjon av sin inngang og gir en direkte rute for informasjon og gradienter. Suksessen med residual‑nettverk gjorde det praktisk å trene mye dypere CNN-er.
Klassifiseringshoder produserer klassescore. Gjenkjenningshoder forutsier kategorier og bokser. Segmentasjonsarkitekturer legger til dekoder‑stier som gjenoppretter romlig detalj. Den samme CNN‑ryggraden kan gjenbrukes via transfer‑læring.
Hva CNN‑lag lærer
Det er vanlig å visualisere tidlige filtre som responderer på kanter eller teksturer og senere representasjoner som korrelerer med deler eller objekter. Dette er en nyttig intuisjon, men det er ingen fast regel. Funksjonene avhenger av oppgaven, arkitekturen, data, mål og treningsprosessen, og noen enheter kombinerer informasjon som ikke passer pent inn i et menneskelig konsept.
CNN-er versus vision‑transformere
Vision‑transformere deler bilder inn i lapper og bruker oppmerksomhet for å modellere relasjoner mellom dem. De kan skaleres effektivt med store forhåndstreningsdatasett. CNN-er bygger lokalitet og translateringsrelaterte antakelser direkte inn i arkitekturen, noe som kan gjøre dem mer effektive og databevisste i mindre miljøer.
Mange praktiske systemer kombinerer konvolusjon og oppmerksomhet. Den rette arkitekturen avhenger av nøyaktighet, latenstid, minne, treningsdata, maskinvare og distribusjon – ikke av hvilken familie som er nyest.
Begrensninger og praktiske betraktninger
CNN-er kan være følsomme for distribusjonsendringer, adversarielle forstyrrelser, bakgrunnssnarveier og skjev treningsdata. De er ikke helt invariante til posisjon, rotasjon, skala eller synsvinkel. Augmentering og arkitekturvalg kan forbedre robusthet, men garanterer den ikke.
For distribusjon, mål ende‑til‑ende‑latens, minne, gjennomstrømning og subgruppe‑adferd. Kvantisering og beskjæring kan redusere kostnad, spesielt for edge‑AI, men komprimerte modeller må valideres på nytt.
Konvolusjon, reseptive felt og moderne CNN‑blokker
Et konvolusjonslag skyver lærte kjerner over et rutenett og deler vekter på tvers av posisjoner. Kjerne‑størrelse, stride, dilatasjon og padding bestemmer utgangsformen og det reseptive feltet. Tidlige lag responderer ofte på lokale kanter eller teksturer; dypere lag kombinerer informasjon over større områder, selv om lærte representasjoner ikke nødvendigvis kartlegges tydelig til menneskelige konsepter. Pooling eller strided‑konvolusjon reduserer romlig oppløsning. Kanaler bærer funksjonskart, mens gruppert og depthwise‑separerbar konvolusjon bytter kryss‑kanalmiksing for lavere beregning. Residual‑forbindelser gjør svært dype nettverk lettere å optimalisere.
For en inngangshøyde og -bredde styrer padding grensebehandlingen og stride styrer prøvetakingen. Aggressiv nedprøving kan slette små objekter; null‑padding kan skape kantartefakter; dilatasjon utvider kontekst uten samme parametervekst, men kan føre til gittermønstre. Batch‑normalisering avhenger av treningsstatistikk, mens alternativer kan oppføre seg bedre ved små batch‑størrelser. Moderne arkitekturer kombinerer flaskehalser, flerskala‑funksjoner, oppmerksomhet eller inverterte residualer. Velg arkitektur basert på oppgaveløsning, minnebåndbredde, latenstid og målmaskinvare snarere enn kun bilde‑klassifiserings‑nøyaktighet.
Trening, tolkning og distribusjon
Bruk augmenteringer som bevarer etiketter og reflekterer reell variasjon, og del opp etter subjekt eller scene før augmentering. Transfer‑læring er vanlig: erstatt oppgavehodet, tren det, og deretter frigjør ryggraden forsiktig. Evaluer klasse‑spesifikk ytelse, kalibrering, robusthet mot uskarphet, komprimering, belysning, skala, beskjæring og adversarielle forstyrrelser. Visualiseringsmetoder som funksjonskart og saliens kan avdekke snarveier, men de er følsomme for metode og referanse. Bekreft mistenkt avhengighet med kontrafaktiske bilder, okklusjonstester eller datasettendringer.
Eksporterte CNN-er kan flettes, kvantiseres eller kompileres for GPU, NPU, nettleser eller mikrokontroller. Valider den distribuerte grafen, inkludert forhånds‑ og etterbehandling, på nøyaktige enheter. Mål ende‑til‑ende‑latens, minne, energi og termisk oppførsel; dekoding av inngang kan dominere en liten modell. Overvåk kamera‑ og bildestatistikk, utgangsfordeling og bekreftede feil. Signerte modellartefakter, beskyttede oppdateringskanaler og elegant sensorsvikt er en del av produksjonsdesign. CNN-er koder en nyttig lokalitetsbias, men de forstår ikke automatisk objekter eller kausale scener.
Arbeidseksempel: distribuere et CNN på et inspeksjonskamera
Et CNN klassifiserer overflatedefekter fra høyoppløselige linjeskanningsbilder. Ingeniører fliser bildene med overlapp slik at små defekter overlever nedprøving, bevarer koordinater for gjennomgang, og validerer augmenteringer mot reell optisk variasjon. Et residual‑CNN og en lettere depthwise‑modell sammenlignes ved lik tilbakekalling. Tester inkluderer kantdefekter, blending, komprimering, bevegelse, materialbatcher og kamera‑utskiftninger, med uavhengige produksjonspartier reservert for endelig evaluering.
Kompilering fletter og kvantiserer modellen for en edge‑akselerator, men den distribuerte grafen sammenlignes med referansen på sensitive defekttilfeller. Dekoding, flising, inferens og sammenslåings‑latens måles ende‑til‑ende. Systemet flagger døde piksler og eksponeringsdrift separat fra produktdefekter. Operatører kan inspisere kildefliser og overstyre resultater. Modell‑ og kameraendringer rulles ut gradvis, og linjen beholder en sikker manuell inspeksjonsprosedyre når visjonspipelinen er utilgjengelig.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler en reproduserbar basislinje og et versjonert evalueringssett før finjustering. Test vanlige tilfeller, grensetilstander, feilformet eller manglende inngang, distribusjonsendring, avhengighetsavbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latenstid, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avsløre inngangskvalitet, utgangsadferd, modell‑ eller regelversjon, avhengighetshelse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter distribusjon i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og oppbevaringsprosedyrer, og et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Må et CNN alltid ha pooling?
Nei. Et CNN kan nedprøve med strided‑konvolusjon og kan bevare oppløsning for tett prediksjon. Pooling er et designverktøy, ikke et definert krav.
Er CNN‑filtre hånddesignede?
I et trent CNN blir kjerneverdier vanligvis lært fra data. Dette skiller seg fra klassiske visjonsfiltre der koeffisientene velges på forhånd for operasjoner som kantdeteksjon.
Primære referanser












