
Grunnleggende AI
Hva er Ensemble‑læring?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Ensemble‑læring kombinerer prediksjoner fra flere modeller. Hovedideen er at modeller med ulike feil kan gi et mer nøyaktig eller stabilt resultat når deres utdata blir gjennomsnittet, stemt eller sendt til en meta‑lærer.
Det er ikke nok å bare legge til modeller. Hvis hvert medlem lærte den samme snarveien, vil feilene deres være korrelerte, og ensemblet kan bare bli mer sikker på den samme feilen.
Viktige punkter
- Ensemble fungerer best når medlemsmodellene er nyttige hver for seg og gjør meningsfullt forskjellige feil.
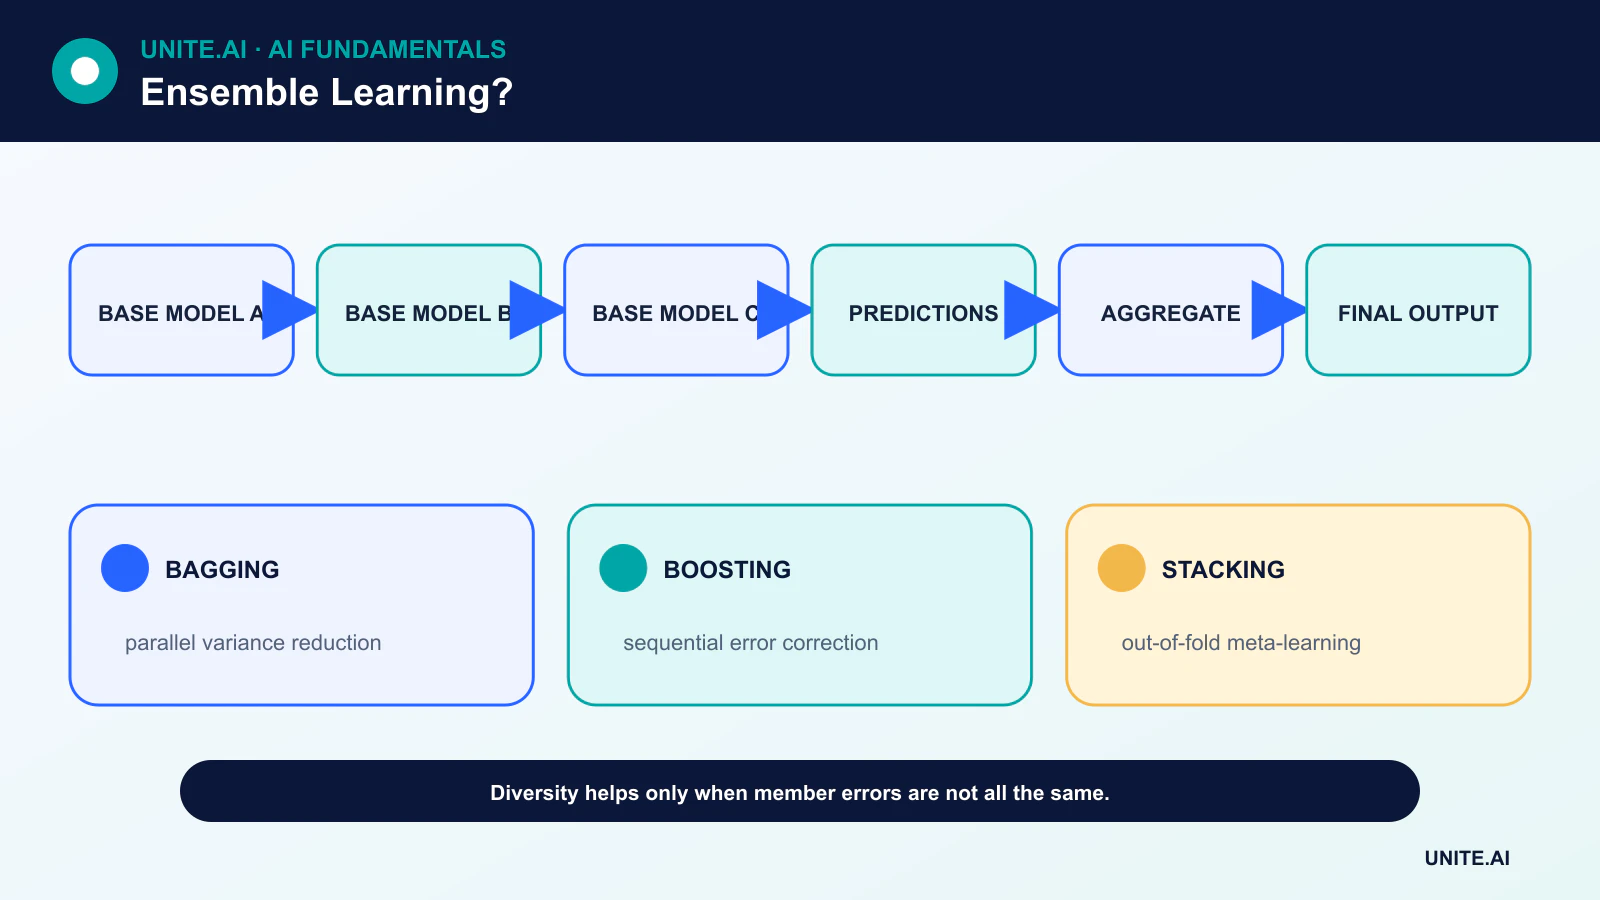
- Bagging trener medlemmene parallelt på resamplede data; boosting trener lærere sekvensielt for å korrigere feil.
- Stacking trener en meta‑modell på out‑of‑fold‑prediksjoner, ikke på in‑sample‑prediksjoner.
- Nøyaktighetsgevinster må veies opp mot latens, kalibrering, tolkbarhet og vedlikeholdskostnader.
Stemming og gjennomsnitt
Hard voting velger klassen med flest stemmer. Soft voting tar gjennomsnitt av klasse‑sannsynligheter, vanligvis etter kalibrering. Regresjons‑ensemble tar ofte gjennomsnitt av numeriske prediksjoner. Vektede versjoner gir mer innflytelse til sterkere medlemmer.
Et gjennomsnitt kan redusere varians når feilene ikke er perfekt korrelerte. Det kan ikke reparere en felles datadefekt, merkelabsfeil eller manglende undergruppe. Mangfold bør måles gjennom uenighet og feiloverlapp, ikke antas kun basert på ulike modellnavn.
Bagging og random forests
Bootstrap‑aggregating trener modeller på resamplede datasett og tar gjennomsnitt av dem. Et beslutningstre har høy varians, noe som gjør det til en naturlig kandidat for bagging.
Random forests legger til tilfeldig funksjonsvalg ved delinger, noe som reduserer korrelasjon mellom trær. Out‑of‑bag‑eksempler kan estimere ytelse, men et endelig urørt testsett er fortsatt verdifullt for modellutvelgelse og påstand om utrulling.
Boosting
Boosting bygger en additiv modell i trinn. Senere lærere fokuserer på eksempler eller residualmønstre som det nåværende ensemblet håndterer dårlig. AdaBoost endrer eksempelvekter; gradient boosting tilpasser lærere til negative gradienter av et valgt tap.
Boostede trær kan modellere komplekse tabulære relasjoner, men dype trær, for mange runder og lekkasje kan fortsatt føre til overtilpasning. Læringsrate, tredybde, underprøvetaking og tidlig stopp er viktige kontrollparametere.
Stacking og blending
Stacking lager en modell på andre nivå som lærer hvordan man kombinerer basis‑prediksjoner. For å unngå lekkasje må hver treningsrad for meta‑modellen komme fra en basis‑modell som ikke ble trent på den raden. Kryss‑validering genererer disse out‑of‑fold‑prediksjonene.
Blending bruker et eget hold‑out‑sett for meta‑modellen, noe som er enklere men reduserer data tilgjengelig for trening. Begge tilnærmingene krever samme forhåndsbehandling og versjonskontroll ved inferens.
Operasjonelle avveininger
Et ensemble kan multiplisere minne‑, beregnings‑ og feilmoduser. Det kan være vanskeligere å forklare, kalibrere og oppdatere konsistent. Destillasjon kan komprimere et ensemble til en mindre modell, men studenten må evalueres uavhengig.
Et praktisk utvalg sammenligner ytelse, tail‑latens, kalibrering, ressursbruk og feilkostnad. Noen ganger er én godt regulert modell å foretrekke fremfor en liten nøyaktighetsgevinst fra en skjør stabel.
Hvorfor ensemble fungerer
Ensemble‑læring kombinerer flere modeller slik at feilene deres delvis kansellerer hverandre eller styrkene deres dekker ulike områder. Bagging trener modeller på resamplede data og tar gjennomsnitt av prediksjoner, noe som reduserer varians; random forests legger til tilfeldig funksjonsvalg for å dekorelere trær. Boosting trener lærere sekvensielt for å fokusere på residualfeil, ofte reduserer bias men øker sensitiviteten for støy og tuning. Stacking trener en meta‑modell på basis‑modellprediksjoner. Mangfold må være nyttig: å ta gjennomsnitt av identiske modeller gir kostnad uten vesentlig feilreduksjon.
Korrelasjon mellom feilene bestemmer nytten. Mangfold kan komme fra datasett, funksjoner, algoritmer, hyperparametere, tilfeldig initialisering eller tidsvinduer. Hard voting forkaster tillit; soft voting tar gjennomsnitt av sannsynligheter men krever kompatibel kalibrering. Regresjon kan ta gjennomsnitt eller bruke robust aggregasjon. I stacking er out‑of‑fold‑prediksjoner essensielle – å trene meta‑modellen på basis‑prediksjoner fra samme tilpassede data forårsaker lekkasje. Hold en enkel gjennomsnitts‑baseline før du adopterer en kompleks kombinasjon.
Evaluering, kalibrering og usikkerhet
Sammenlign hvert medlem og ensemblet på et hold‑out‑sett med identisk forhåndsbehandling. Rapporter oppgave‑metrikker, kalibrering, undergruppe‑feil, varians på tvers av fold eller frø, og ressurskostnad. Et ensemble kan forbedre gjennomsnittskvaliteten samtidig som det skjuler et felles blindpunkt forårsaket av felles data eller etiketter. Inspiser uenighet: den kan avdekke usikkerhet, men korrelerte, selvsikre feilaktige modeller kan være enige. Kalibrer det endelige ensemblet, ikke bare medlemmene, og valider avholds‑terskler mot gjennomgangskapasitet og konsekvenser.
Out‑of‑bag‑estimater er nyttige for baggede modeller, men erstatter ikke en endelig test som representerer produksjonsmiljøet. For tidsavhengige data, unngå resampling som bryter rekkefølgen. For sikkerhetskritisk bruk, test medlems‑feil, utdaterte modeller og adversarial input. Vektede ensemble kan overtilpasse valideringsdata når mange kandidater prøves. Registrer kandidatvalg og bruk nestet validering når tuning er omfattende.
Utrulling og vedlikehold
Ensemble multipliserer minne, latens, energi og operative avhengigheter. Destillasjon kan komprimere kombinert oppførsel til én modell, med et nytt valideringskrav. Versjonér medlemmer, forhåndsbehandling, vekter og ruting som ett artefakt; definer oppførsel når et medlem tidsavbrytes eller produserer et ugyldig resultat. Overvåk medlems‑prediksjoner og uenighet slik at stille feil blir synlige. Avvikle overflødige medlemmer og tren på nytt bevisst. Ensemble forbedrer prediksjon når feil‑mangfoldet er reelt, men de gjør ikke skjev treningsdata eller et ugyldig mål til pålitelig bevis.
Arbeidseksempel: et ensemble for varsler om ekstremvær
Et prognoseteam kombinerer et fysisk modell‑funksjonssett, gradient‑boostet tre, nevralt sekvensmodell og en kalibrert statistisk basislinje. Out‑of‑fold‑prediksjoner trener en enkel meta‑modell, og evalueringen bruker fremtidige stormer som er helt ekskludert fra medlems‑trening. Metrikker inkluderer hendelses‑gjenkalling, falske alarmer, ledetid, kalibrering, geografisk ytelse og pålitelighet under sjeldne ekstreme forhold. Medlems‑feilkorrrelasjon undersøkes fordi delt inngangsdata kan skape felles blindsoner.
Utrullingen beholder hver prediksjon og det kombinerte resultatet. Hvis et medlem er utilgjengelig, bruker systemet en forhåndsvalidert degraderte konfigurasjon i stedet for stille å renormalisere. Uenighet utløser ekstra gjennomgang, men behandles ikke som usikkerhet i alle tilfeller. Overvåking sporer medlems‑drift, latens og stormutfall, med vekter oppdatert kun gjennom kontrollert validering. Offentlige varsler forblir under autoriserte meteorologiske beslutningsprosesser; ensemblet forbedrer bevisene men redefinerer ikke automatisk varslingspolitikken.
Implementeringsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, innganger, utganger, avhengigheter, eier og konsekvensen av hver viktig feil. Etabler et reproducerbart grunnlag og et versjonert evalueringssett før tuning. Test vanlige tilfeller, grensetilstander, feilformatert eller manglende input, distribusjons‑skifte, avhengighets‑nedbrudd, misbruk, og gruppene eller miljøene som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig vurderer kan gjenskape resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en ansvarlig for respons, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, retningslinjer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumentert gjenoppretting, hendelses‑læring, sletting‑ og lagringsprosedyrer, samt et tydelig punkt hvor det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er en random forest et ensemble?
Ja. Den kombinerer mange randomiserte beslutningstrær, vanligvis ved stemming eller gjennomsnitt.
Kan identiske modeller danne et nyttig ensemble?
De kan hvis treningsdata, initialisering eller sampling skaper tilstrekkelig forskjellige feil, men ren duplisering gir ingen fordel.
Primære referanser












